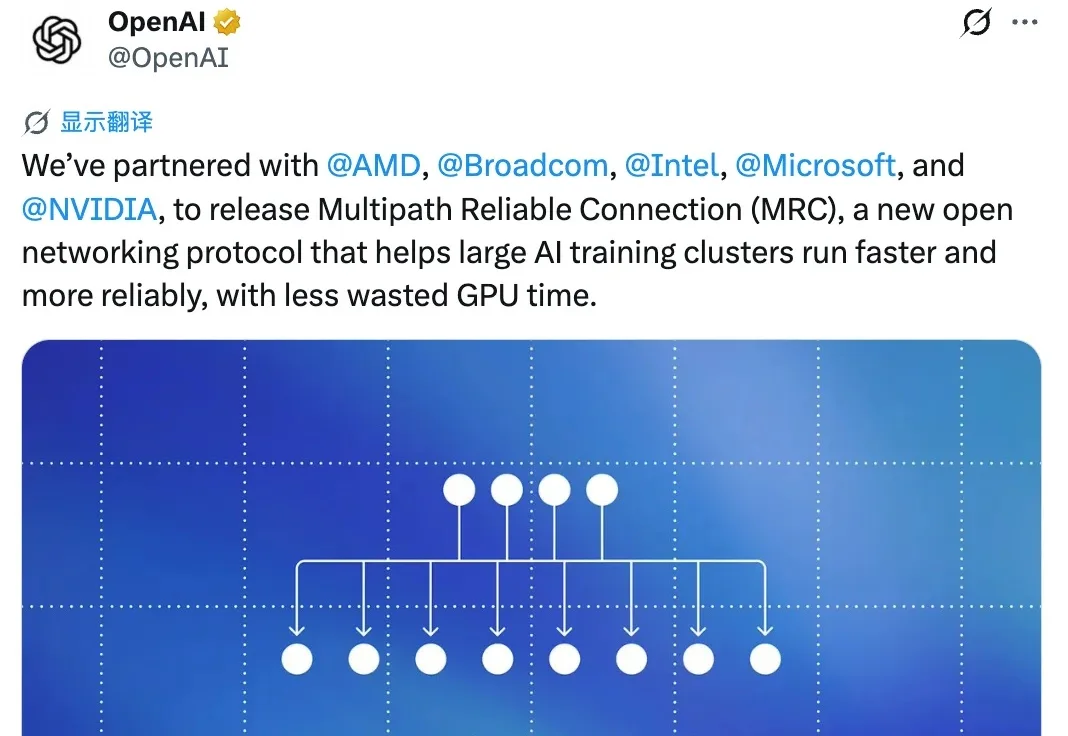
OpenAI公开大规模稳定训练的秘密,英伟达AMD英特尔都受益
OpenAI公开大规模稳定训练的秘密,英伟达AMD英特尔都受益OpenAI,这次又真·Open了一下。
来自主题: AI技术研报
8849 点击 2026-05-07 15:31

 搜索
OpenAI,这次又真·Open了一下。
AI圈有个怪现象: 模型越来越强,确实是好事;但随着AI用法越发多样,用起来的门槛却越来越高。
SWE-Bench 的创建者,刚刚又放出了一个地狱级新 benchmark。
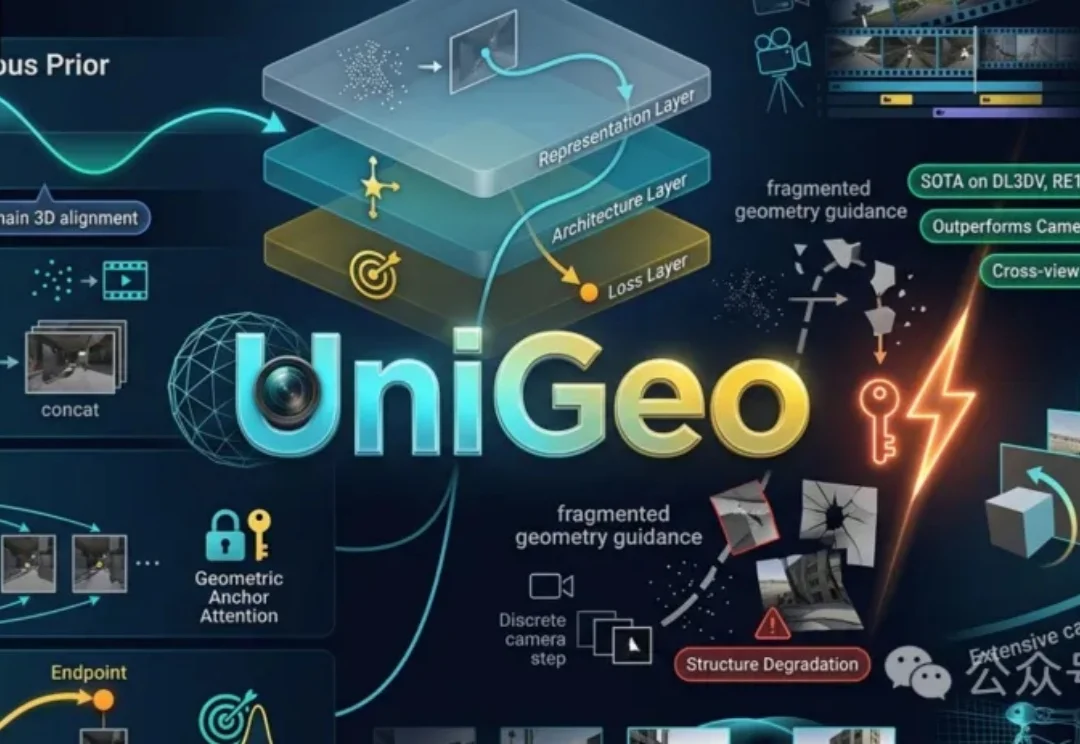
UniGeo通过视频模型的连续视角先验与统一几何引导,实现稳定、高质量的相机可控图像生成,全面超越现有方法,在不同幅度的相机运动中提升跨视角一致性与结构稳定性。
Anthropic最新研究让AI先读懂规范背后的意义,再接受行为示范,在特定实验中将Agent失控率从54%压到7%。
看过的人已经傻眼了,因为这可能是今年为止最炸的机器人demo。
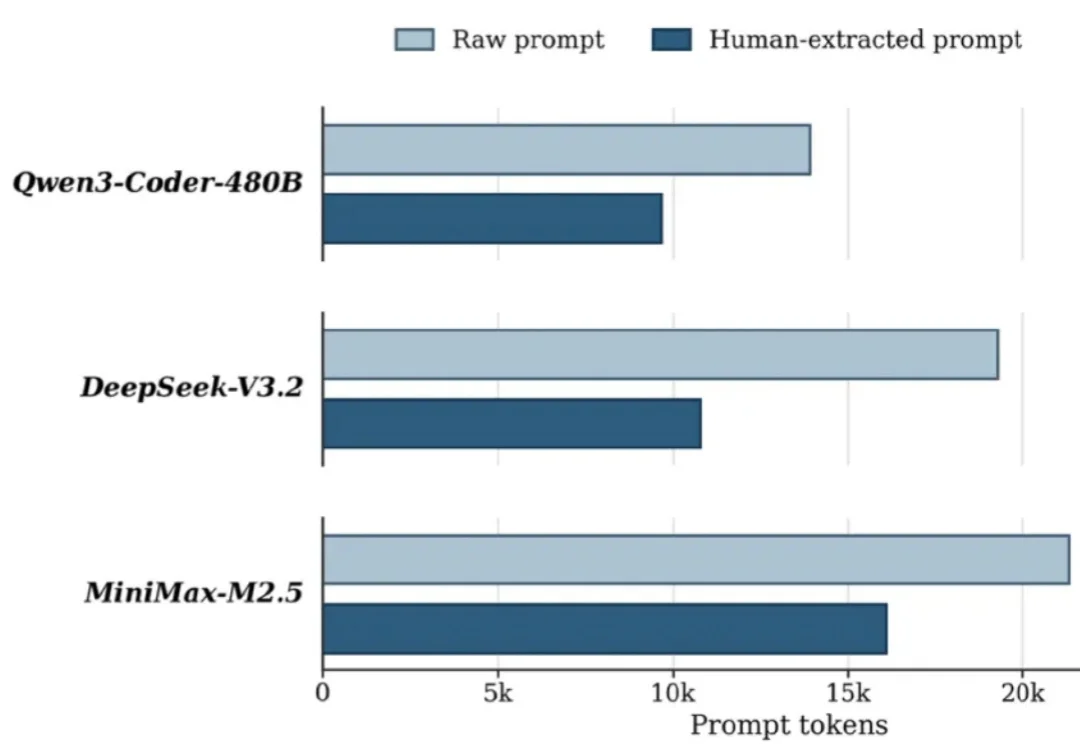
随着代码智能从 code foundation models 走向 autonomous coding agents,CLI/terminal 正在成为智能体进入真实软件工程工作流的重要入口。
在代码大模型和代码智能体技术快速发展的今天,一个日益凸显的现象是:能够在经典代码生成基准上取得优异成绩的模型,一旦被放入真实软件工程环境中,表现却往往大幅下滑。
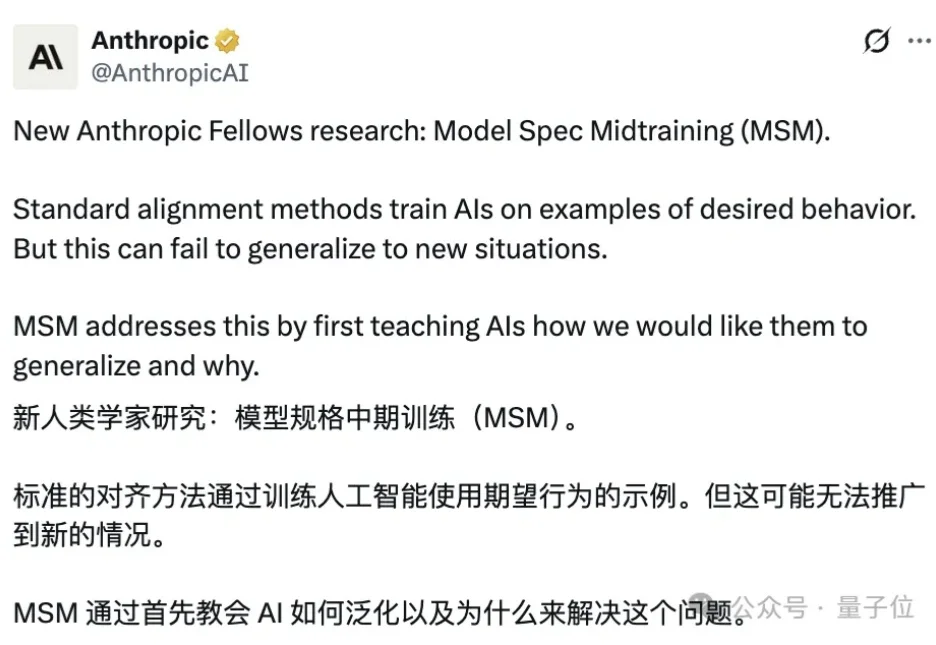
别人做AI中训练都在堆语料、补知识。
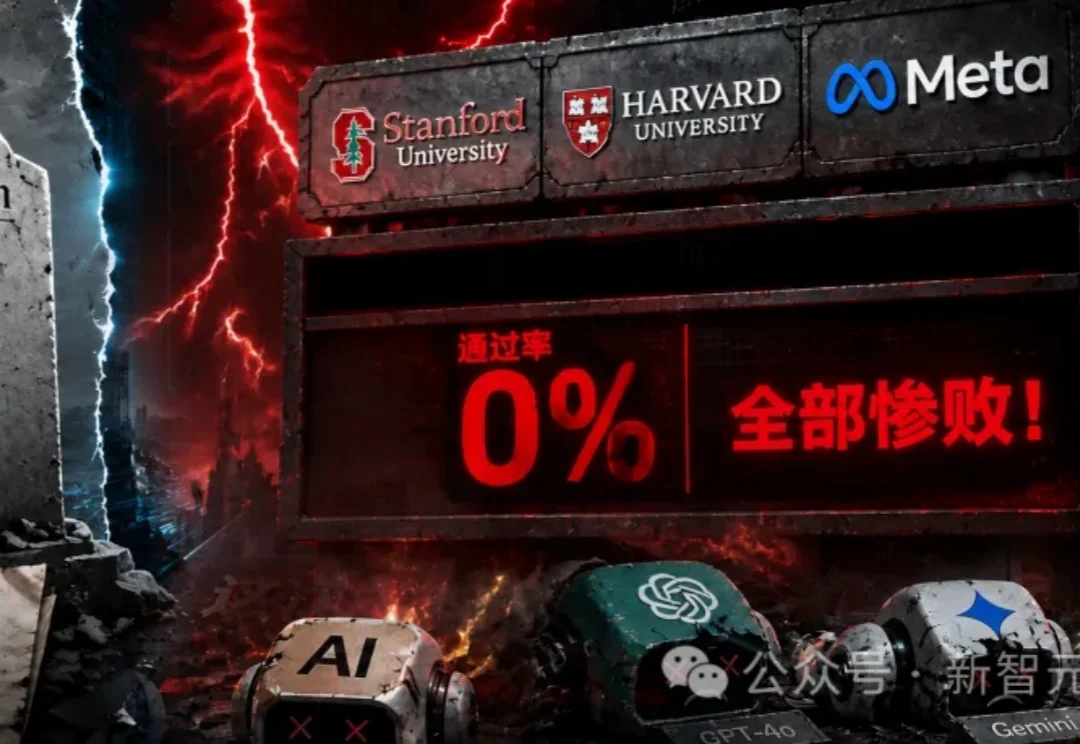
SWE-Bench上能拿72%的模型,换张考卷直接归零!Meta联合斯坦福、哈佛放出ProgramBench,200个项目从零手写,9大顶级模型完整通过率0%。最强的Claude Opus 4.7平均通过率也才51.2%。更离谱的是一联网,就有模型在36%的任务里跑去GitHub扒源码。