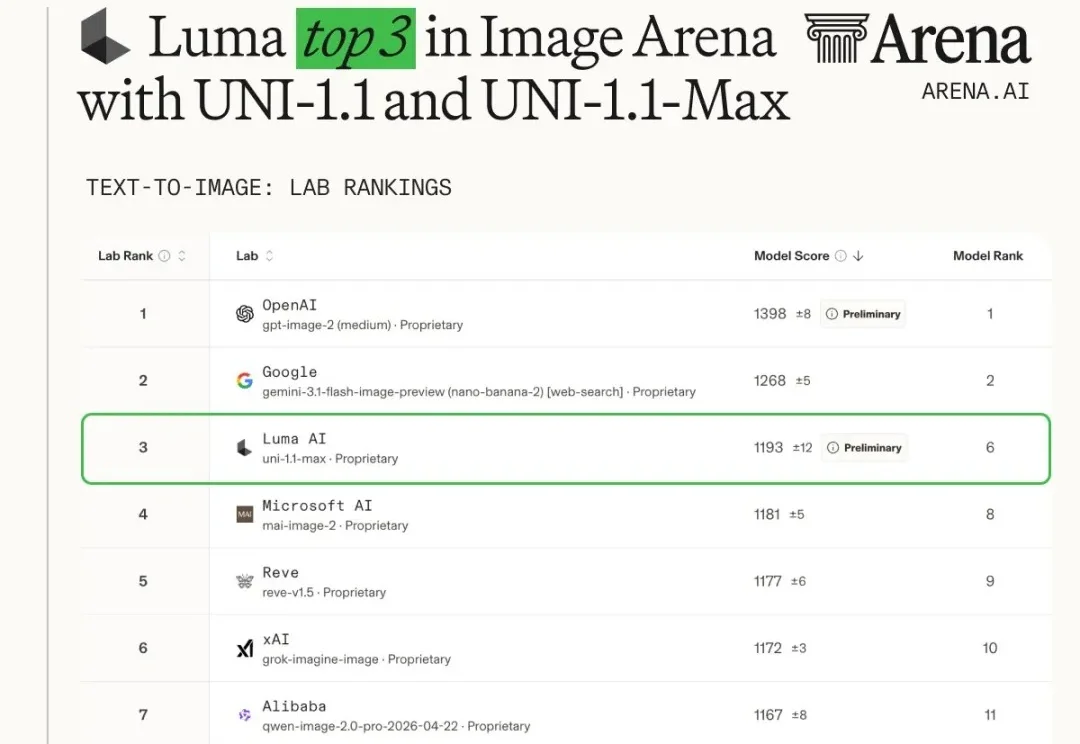
Luma Uni-1.1 API开放,图像模型榜单第三,文字渲染直逼GPT image 2
Luma Uni-1.1 API开放,图像模型榜单第三,文字渲染直逼GPT image 2今年以来,图像生成模型的迭代节奏明显加快。
来自主题: AI技术研报
11435 点击 2026-05-06 15:17

 搜索
今年以来,图像生成模型的迭代节奏明显加快。
你有没有想过,为什么 AI 读一篇短文游刃有余,却在面对一整个代码库时频频出错?
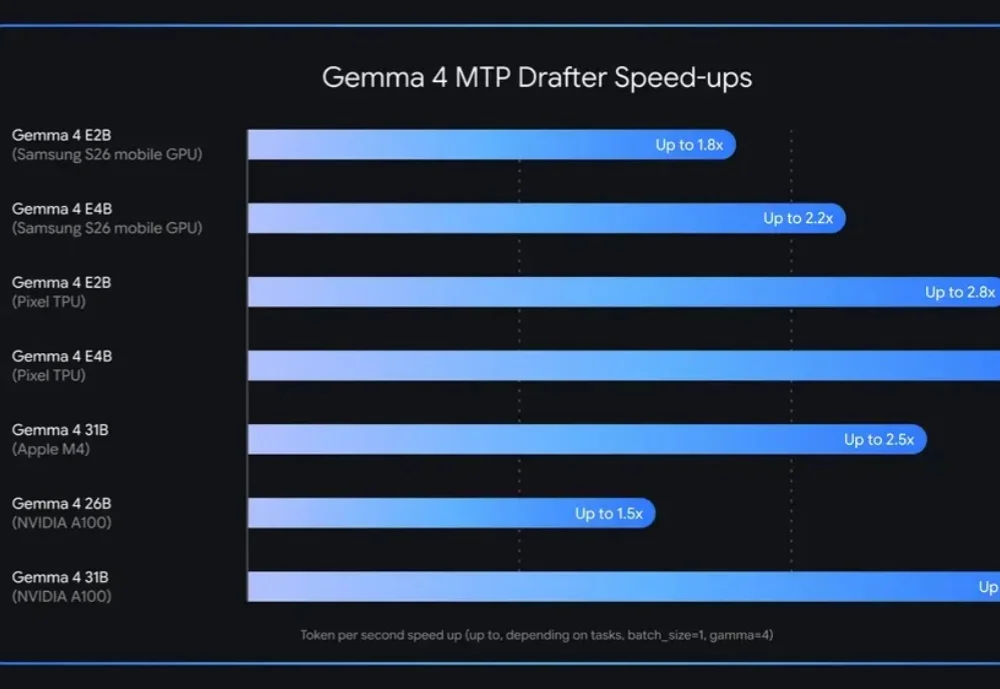
谷歌刚刚给Gemma 4家族更新了一项关键能力:Multi-Token Prediction(MTP)推测解码架构,推理速度最高提升3倍,输出质量不变。
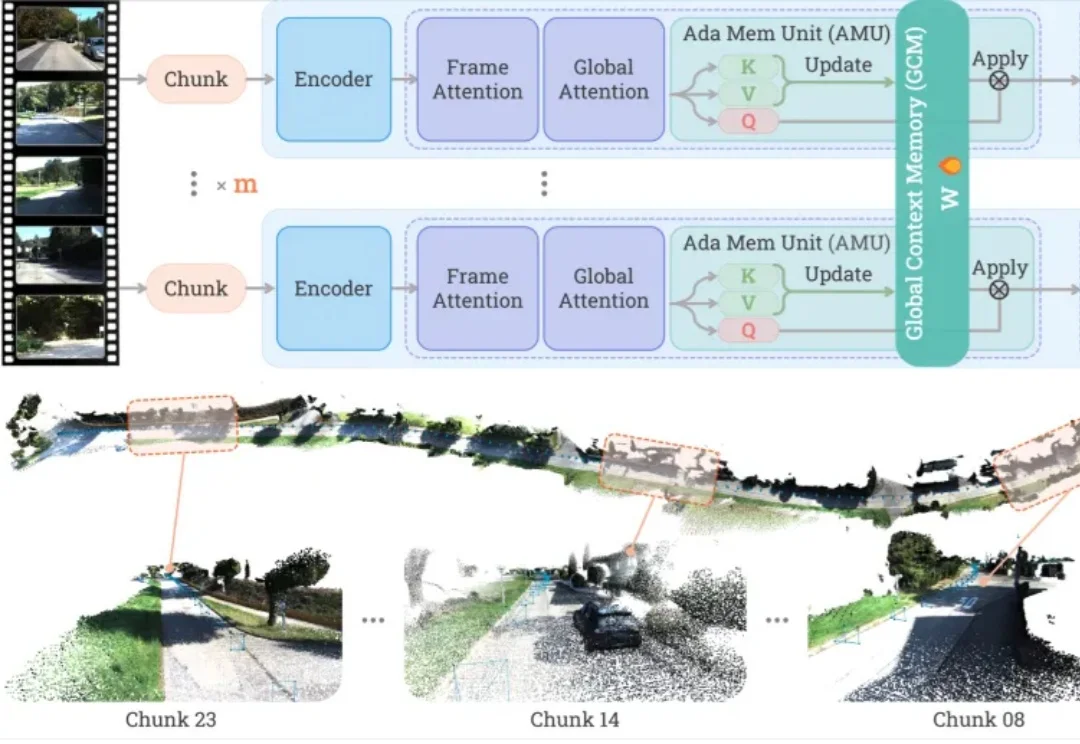
长视频 3D 重建最怕的,其实不是 "看不清"。
在无人在意的角落,世界模型如雨后春笋般集体震撼首发。
用强化学习(RL)优化文生图模型的 prompt following 能力,是一条被广泛验证的路径 —— 让模型根据 prompt 用不同随机种子生成多张图片,通过 reward model 计算 reward,再利用相关 RL 算法优化模型。
独家获悉,字节跳动日前低调公布全球首个25B级、基于混合专家 (MoE) -扩散自注意力机制(DiT) 的开源增强统一多模态模型Mamoda2.5。Mamoda2.5依托Qwen3-VL-8B、128 个专家,Top-8 路由的MoE+DiT架构搭建,最终模型参数高达250亿,而每次仅激活约30亿参数(约12%)。
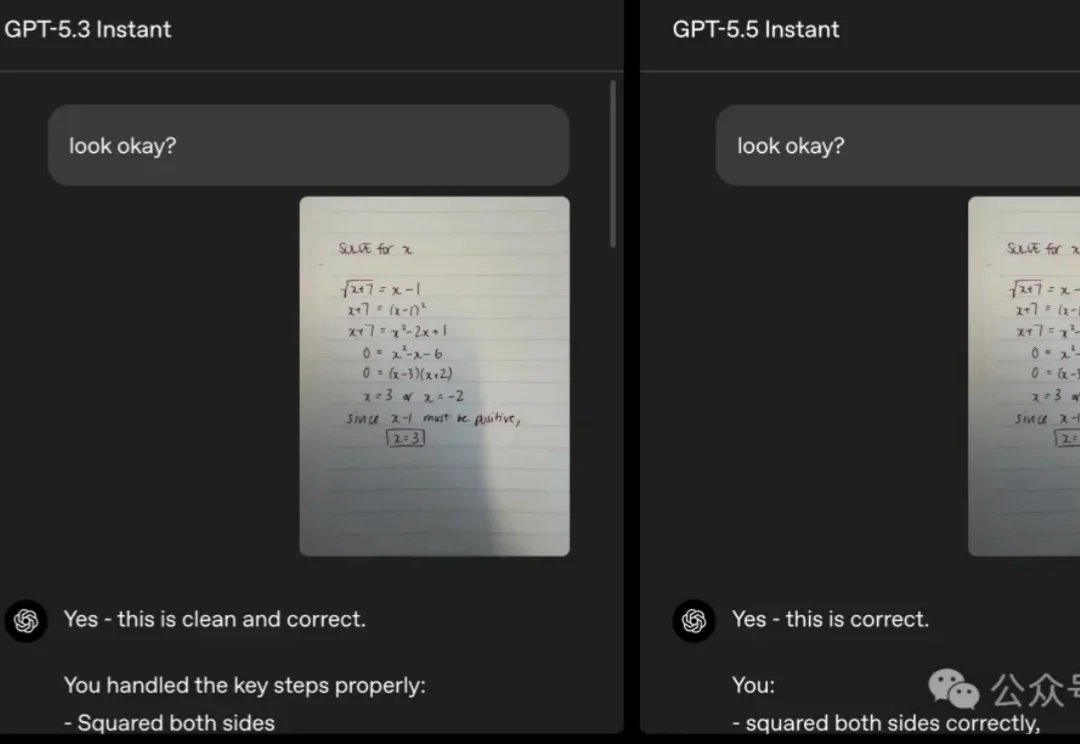
ChatGPT默认模型,今天大升级。
Anthropic联合创始人Jack Clark读完数百份公开数据,得出一个让他自己也坐不住的结论:2028年底前,AI自己造AI的概率是60%。支撑他这一判断的,是编程、科研复现、模型训练优化等多条能力曲线:每一条都在向右上方飞,没有减速迹象。
独家获悉,RoboScience 机器科学于近日完成十亿元 A 轮融资,投资方包含多家国内外知名产业巨头及一线财务机构。本轮融资将用于持续深化其核心的 VLOA 大模型技术,以及推进自研机器人本体的工程化与量产,加速通用具身智能解决方案的规模化落地。