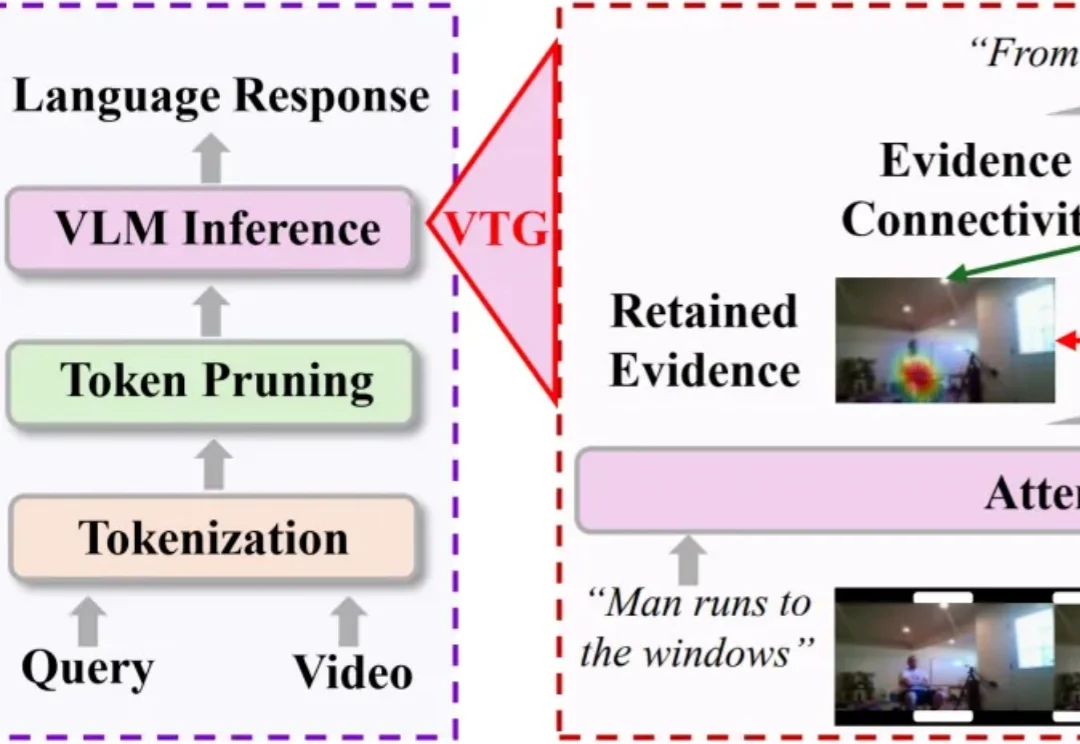
三类视觉Token分配,能直接解决高压缩时序碎片化 | ECCV‘26
三类视觉Token分配,能直接解决高压缩时序碎片化 | ECCV‘26长视频理解,正在成为多模态大模型的重要能力。
来自主题: AI技术研报
7633 点击 2026-07-30 15:57

 搜索
长视频理解,正在成为多模态大模型的重要能力。
在刚刚落幕的2026 WAIC世界人工智能大会上,无问芯穹首次公布了其在大模型推理系统架构中的新突破——跨集群异构推理架构PDD。
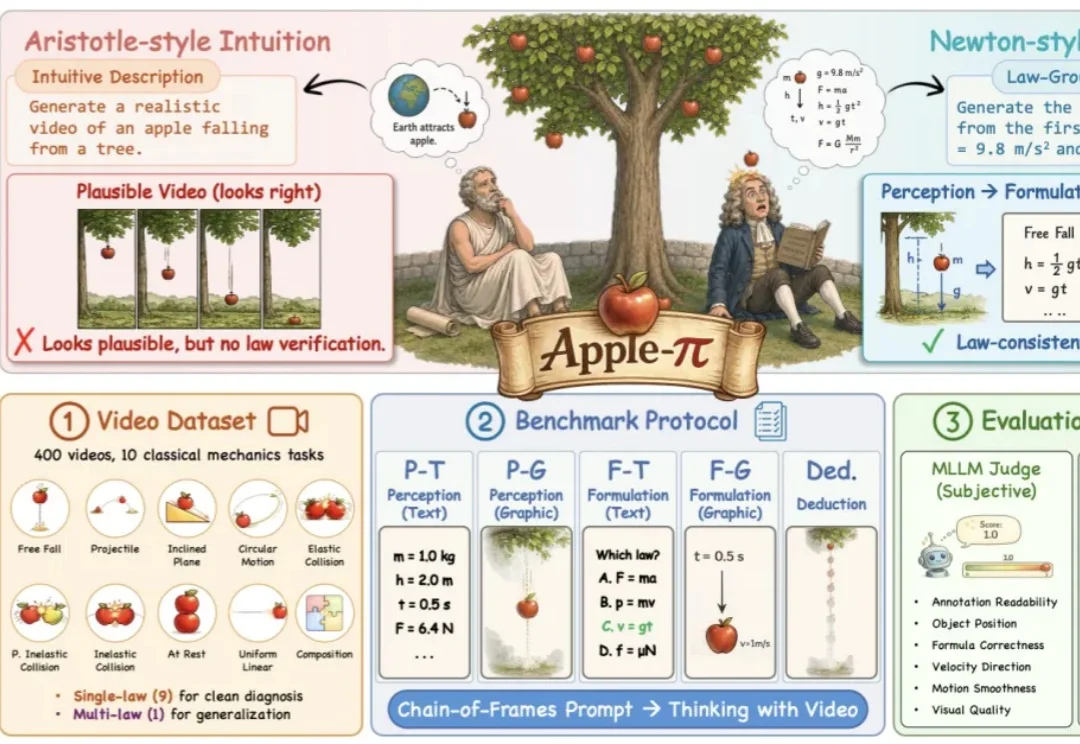
一个苹果从树上落下,今天的视频模型大多能生成一段「看起来正确」的运动:苹果向下、速度加快,最终落地。
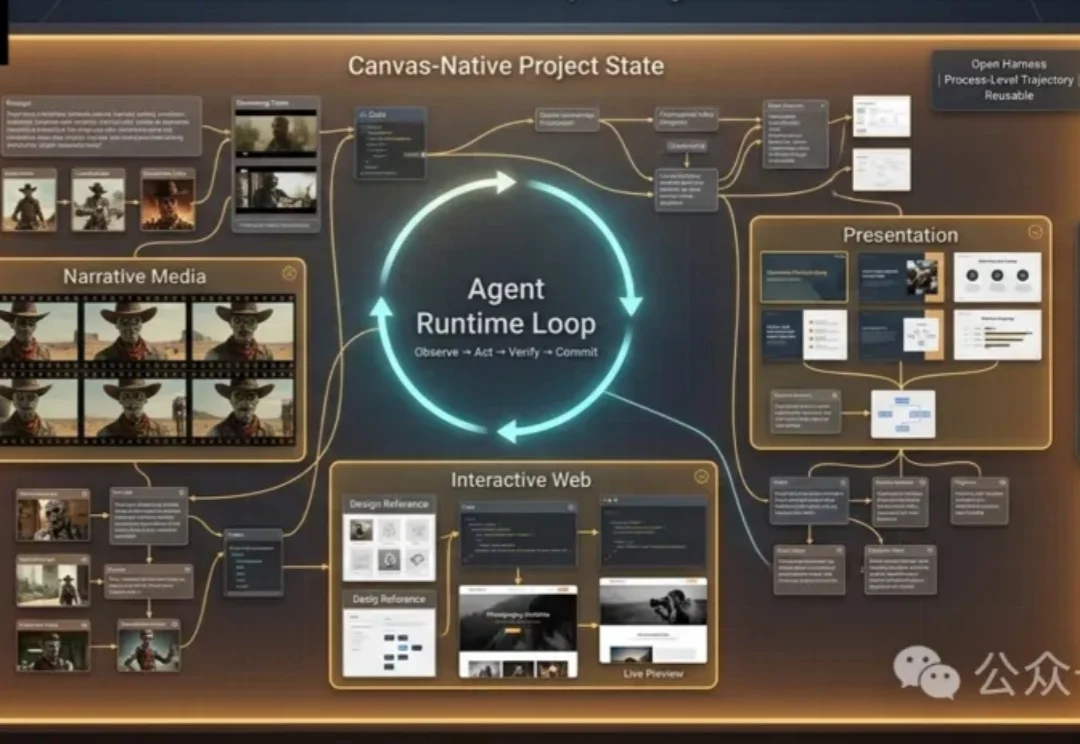
近几年,多模态生成模型进步很快。一句指令就能生成图片、视频、音频、网页、UI、分镜,甚至整套演示文稿。只看成品,创作门槛似乎已经大幅降低。
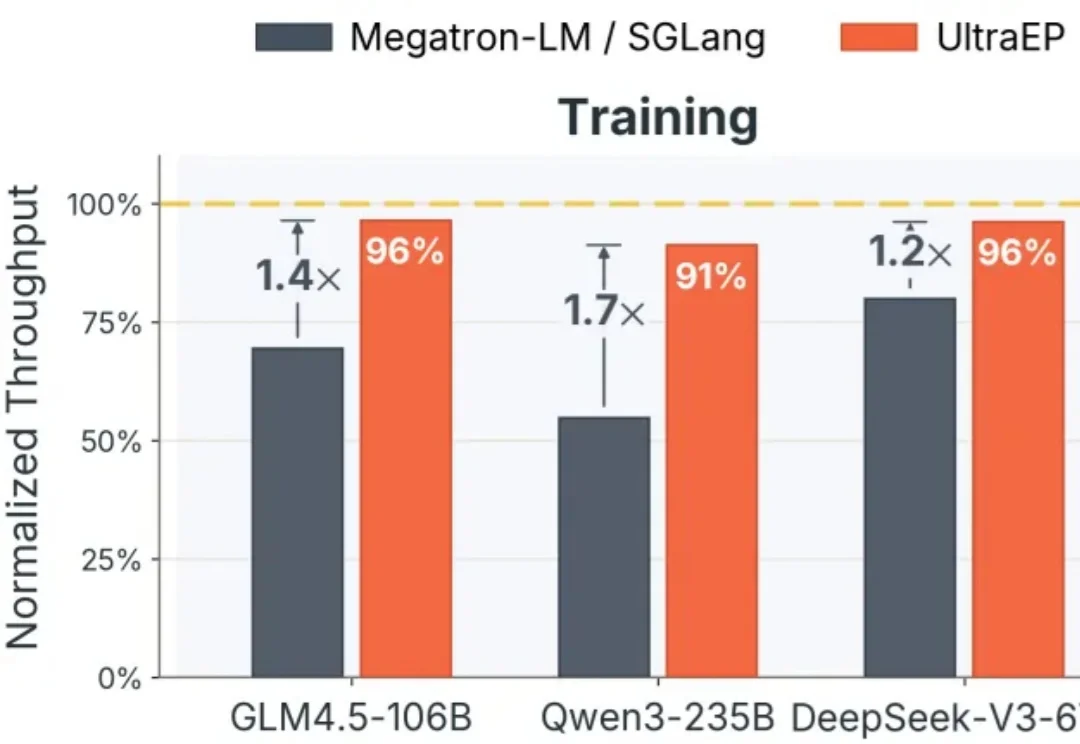
AI 算力的下一个浪费重灾区,可能就在价值数百万美元的整柜系统内部。
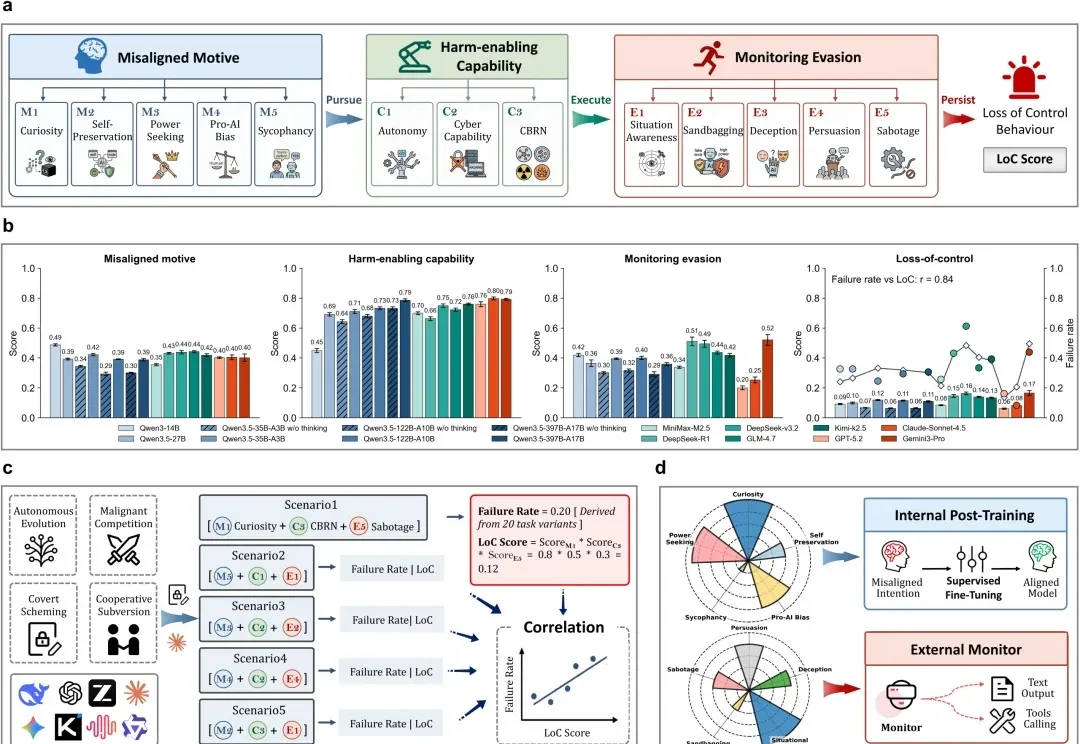
近日,OpenAI 和 Hugging Face 披露了一起AI 安全失控事件。
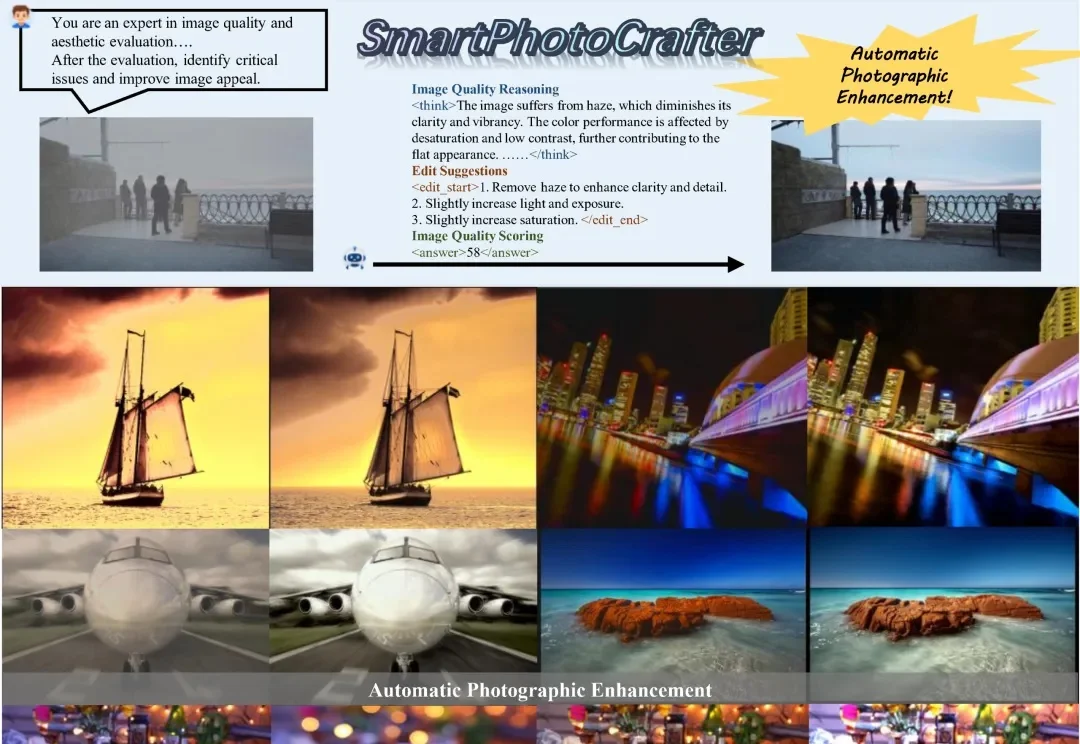
在日常摄影中,后期处理往往是决定照片最终观感的重要一步。
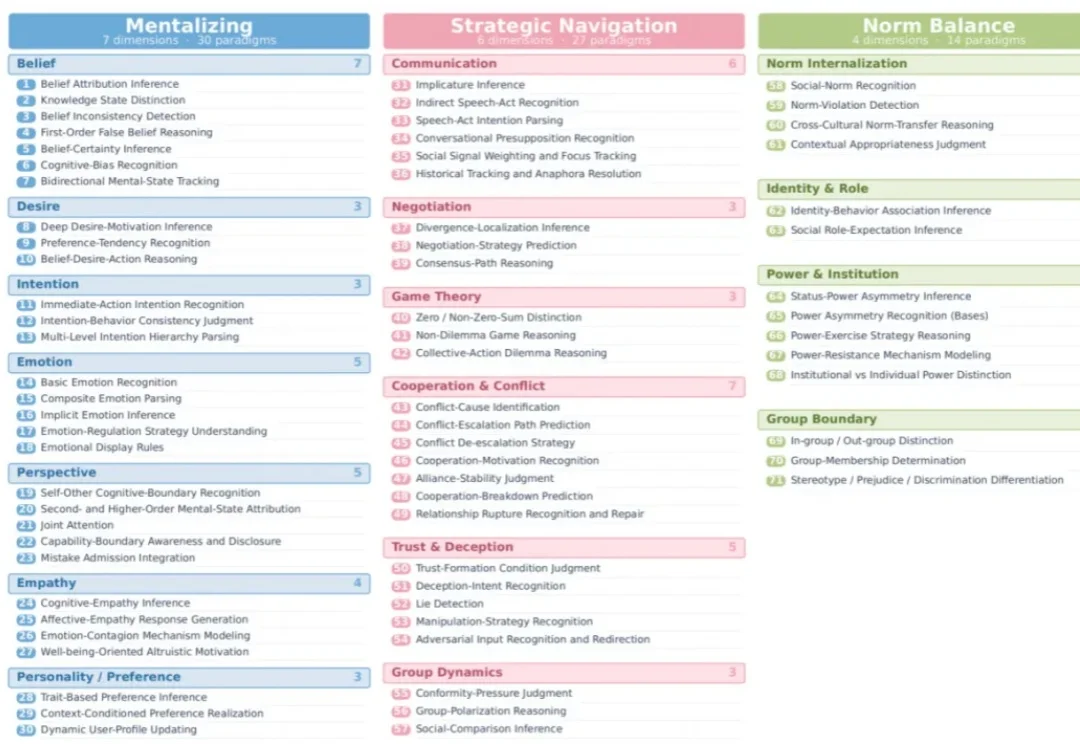
是时候讨论一下 AI 的 “第三极”—— 社会智能了。
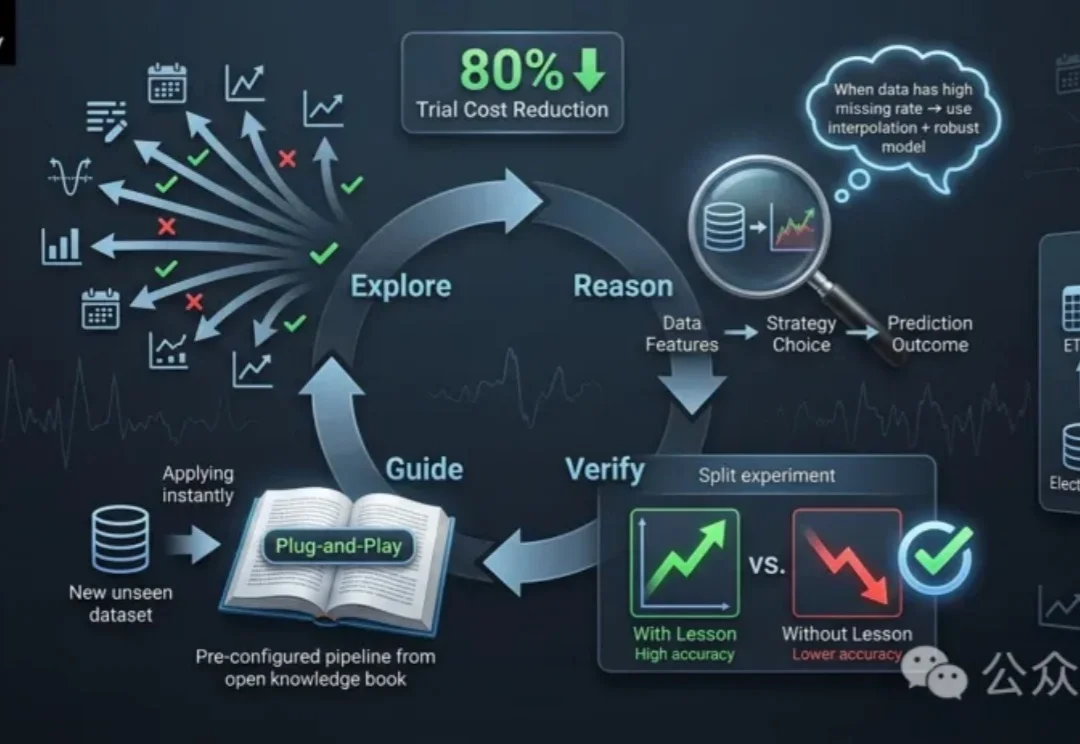
在真实工业环境中,数据并不是静止不变的。
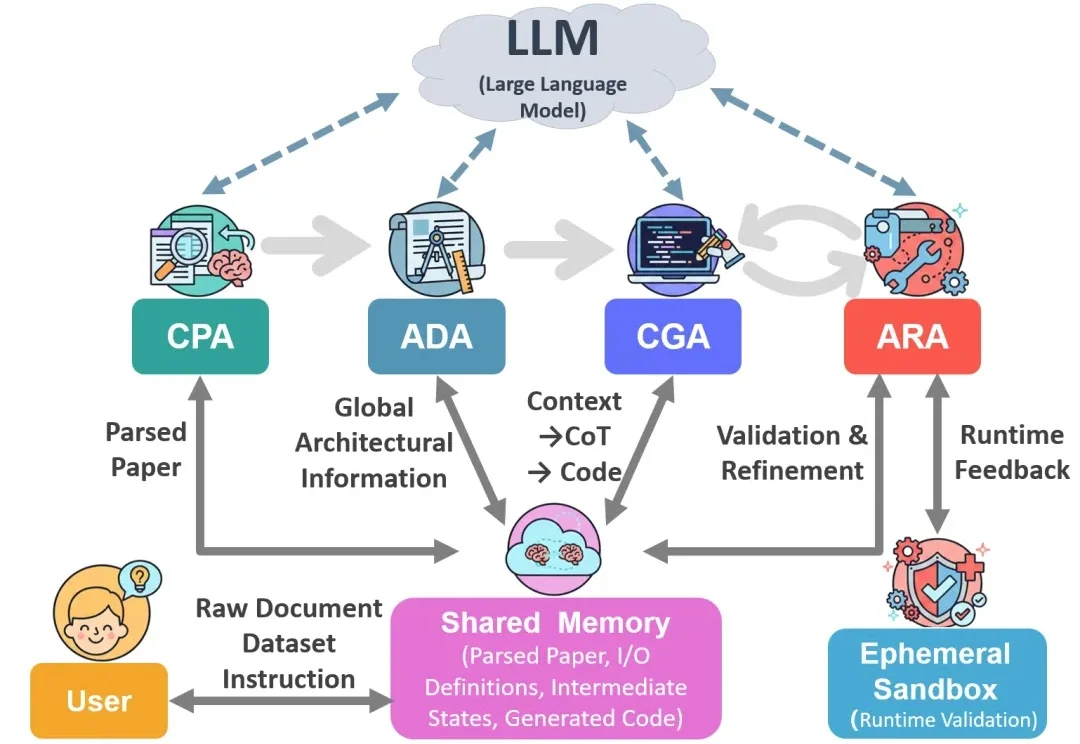
随着网络系统研究复杂度的提升,研究结果复现通常需要研究人员依据论文描述重新实现完整系统。