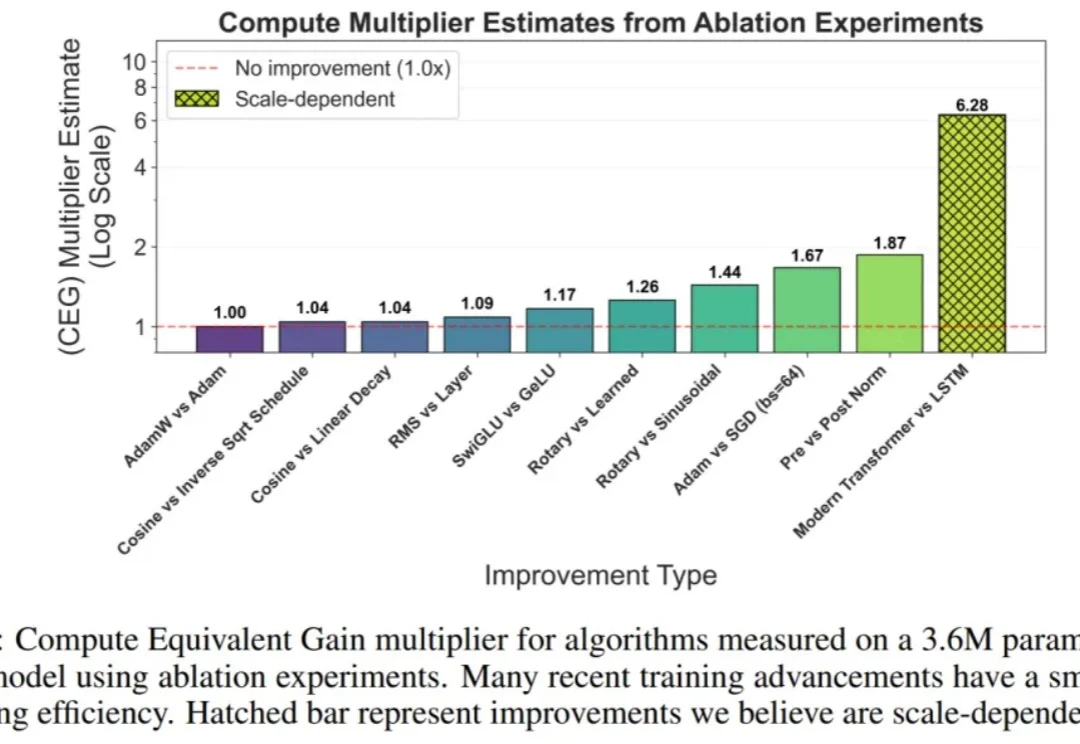
MIT最新发现:这十年,算法进步被高估了
MIT最新发现:这十年,算法进步被高估了在过去十年中,AI 的进步主要由两股紧密相关的力量推动:迅速增长的计算预算,以及算法创新。
来自主题: AI技术研报
11708 点击 2025-12-11 14:36

 搜索
在过去十年中,AI 的进步主要由两股紧密相关的力量推动:迅速增长的计算预算,以及算法创新。
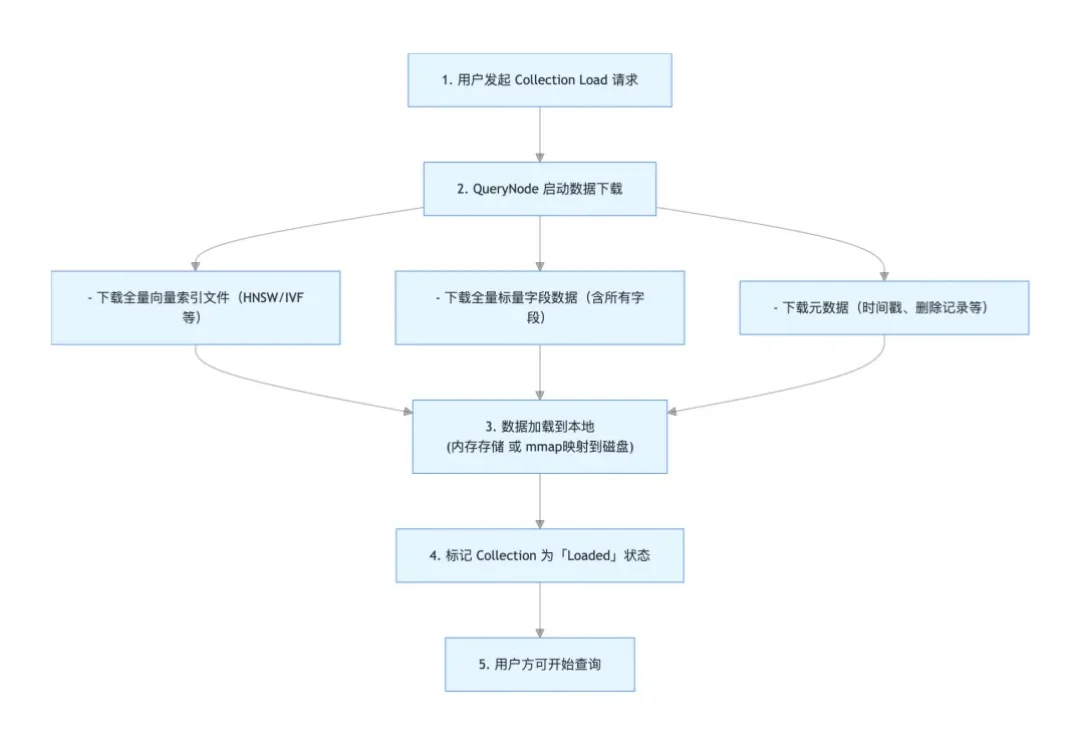
本文为Milvus Week系列第7篇,该系列旨在把Zilliz团队过去半年多积累的先进的技术实践和创新整理成多篇干货深度文章发布。
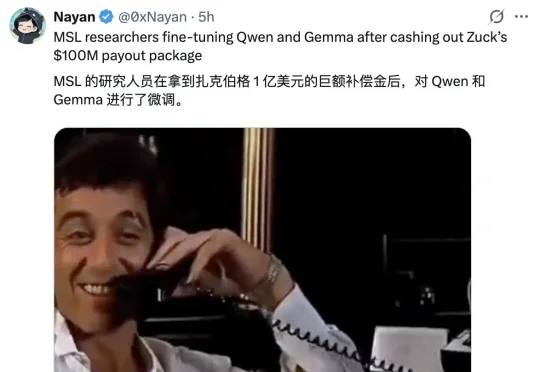
Meta的开源时代,要结束了。彭博社爆料,明年春季,Meta将发布一款代号为「Avocado(牛油果)」的模型。而这款新模型,很可能是「闭源」的。但如果仅仅是闭源,还不至于如此引人注目。真正让市场炸裂的是另一条更劲爆的消息:这款闭源模型,竟然在训练过程中使用了阿里巴巴的AI。
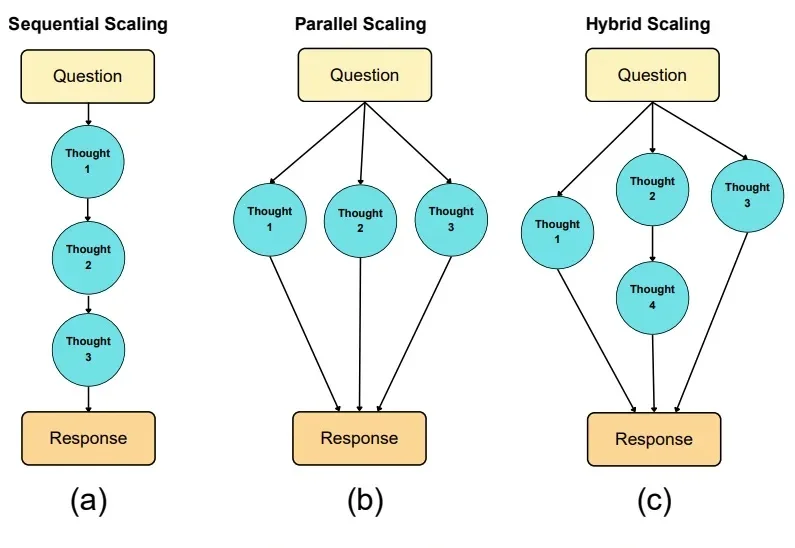
如果说大模型的预训练(Pre-training)是一场拼算力、拼数据的「军备竞赛」,那么测试时扩展(Test-time scaling, TTS)更像是一场在推理阶段进行的「即时战略游戏」。
Anthropic联合创始人兼首席科学官Jared Kaplan,认为在2027-2030年期间,我们将不得不做出是否允许 AI 自我进化的抉择,而允许的话很可能导致AI失控,毁灭全人类。Anthropic在迅速提升AI模型性能不断逼近AGI奇点的同时,也在同时让「9人特种部队」用1.4万字的「AI宪法」防范AI失控。
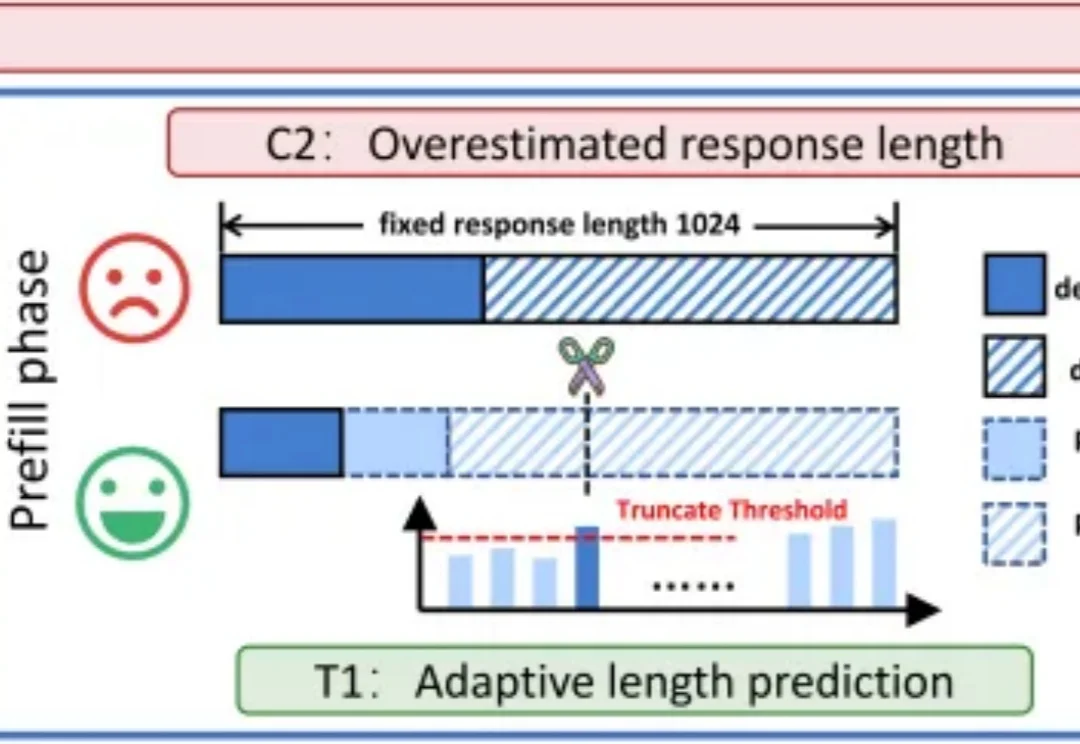
基于扩散的大语言模型 (dLLM) 凭借全局解码和双向注意力机制解锁了原生的并行解码和受控生成的潜力,最近吸引了广泛的关注。例如 Fast-dLLM 的现有推理框架通过分块半自回归解码进一步实现了 dLLM 对 KV cache 的支持,挑战了传统自回归 LLMs 的统治地位。
有关大语言模型的理论基础,可能要出现一些改变了。
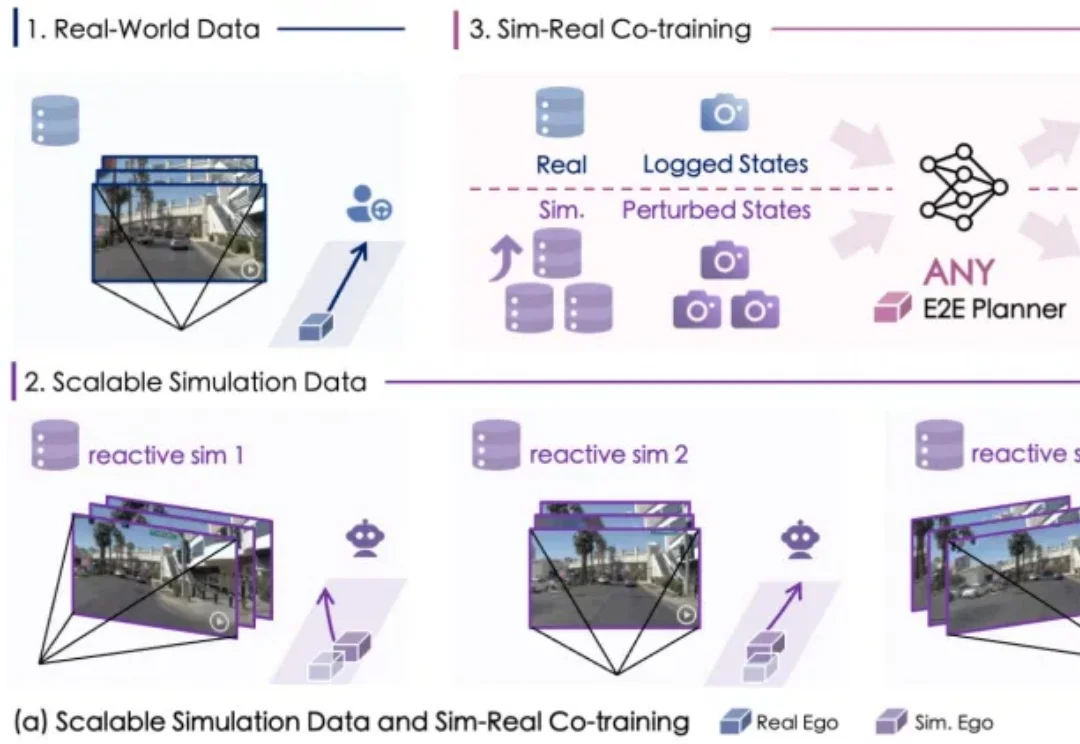
自动驾驶数据荒怎么破?
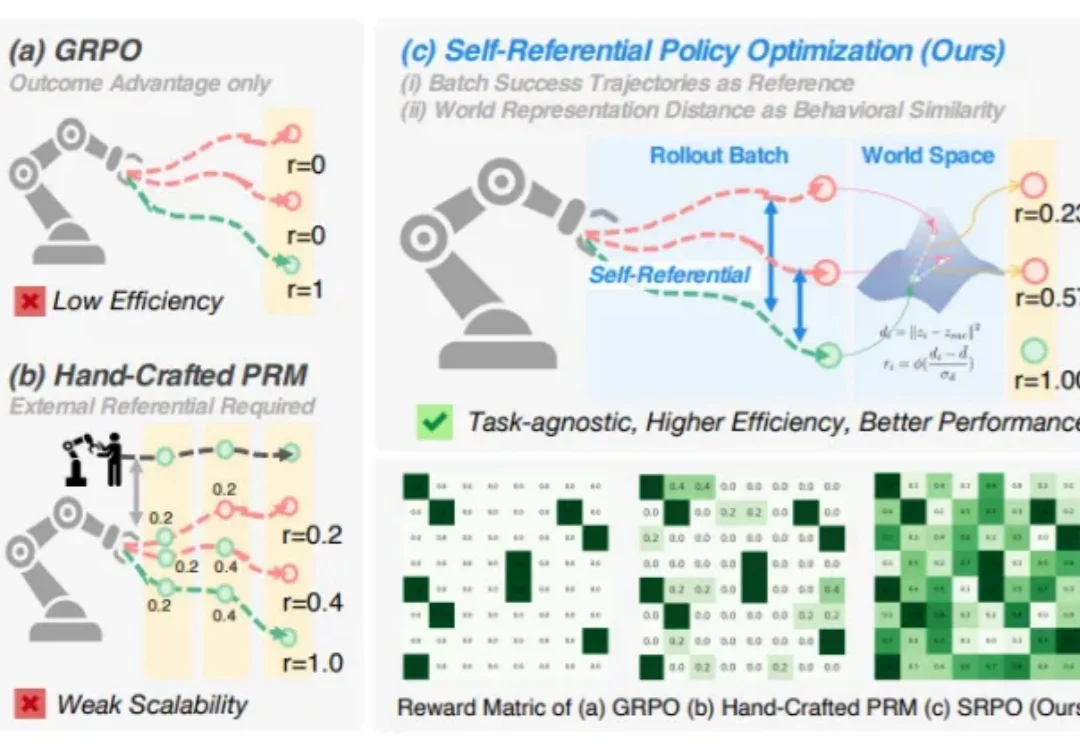
你是否想过,机器人也能像人一样,从失败中学习,不断自我提升?
最近,Prime Intellect正式发布了INTELLECT-3。这是一款拥有106B参数的混合专家(Mixture-of-Experts)模型,基于Prime Intellect的强化学习(RL)技术栈训练。在数学、代码、科学与推理的各类基准测试上,它达成了同规模中最强的成绩,甚至超越了不少更大的前沿模型。