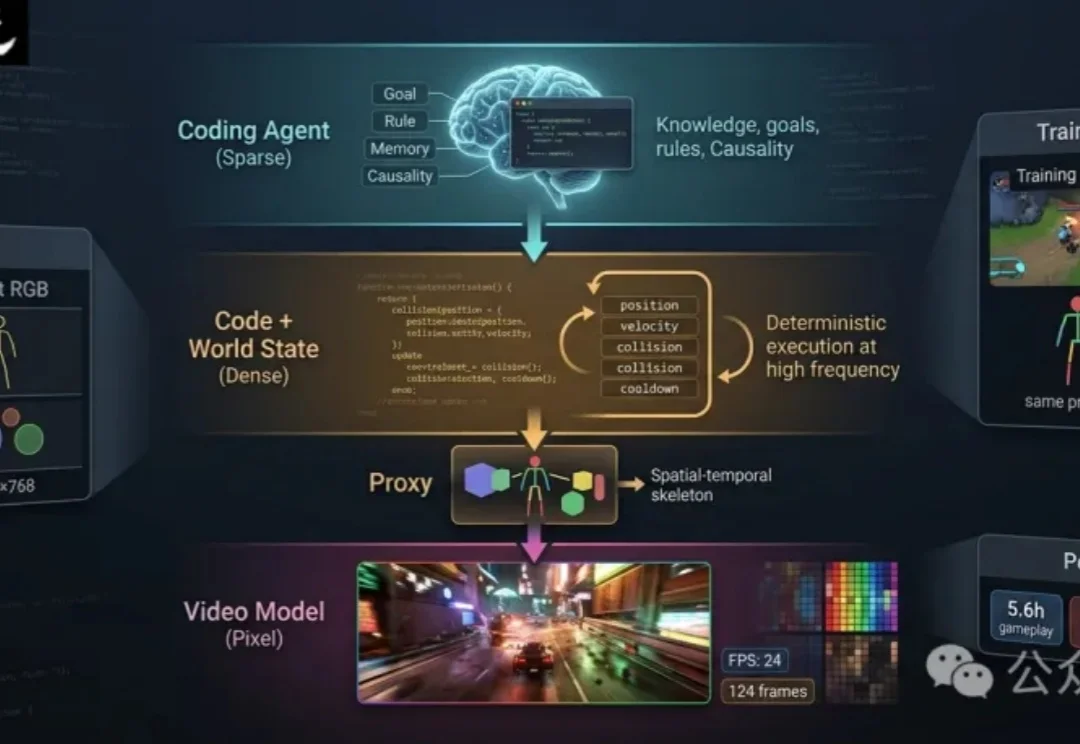
虚幻引擎CEO围观最新世界模型:代码驱动,视频模型生成画面
虚幻引擎CEO围观最新世界模型:代码驱动,视频模型生成画面近年来,视频生成模型在清晰度、时序一致性和可控性上快速进步。给定文本、图像、相机轨迹或玩家动作,模型已经能够合成连贯的后续画面,也让「可交互视频世界」逐渐从概念走向可观看、可操作的原型。
来自主题: AI技术研报
7232 点击 2026-09-08 10:42

 搜索
近年来,视频生成模型在清晰度、时序一致性和可控性上快速进步。给定文本、图像、相机轨迹或玩家动作,模型已经能够合成连贯的后续画面,也让「可交互视频世界」逐渐从概念走向可观看、可操作的原型。
奥特曼亲口承认,GPT-6 Astra其实早就训练完了。
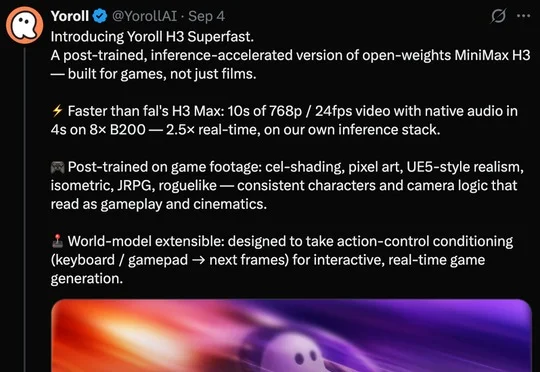
AI视频生成正从质量竞争转向实时速度竞争,AI互动内容公司Yoroll基于开源MiniMax H3模型推出后训练模型Yoroll H3 Superfast,可在4秒内生成10秒768p带音频视频,并上线由其驱动的实时互动叙事产品YoLive。
红杉资本合伙人Sonya Huang指出,随着开放权重模型逼近前沿水平、后训练基础设施逐渐成熟,越来越多AI应用公司开始通过纵向整合构建自有AI能力、掌握模型权重,以降低成本并掌控产品命运。
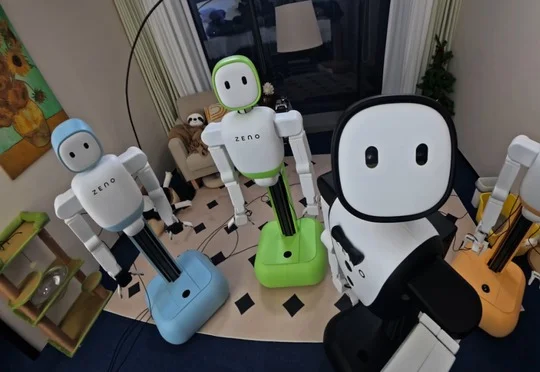
芝诺机器人发布全球首个协作具身智能基础模型Zeno-1,该3B参数模型专为去中心化多机器人协作设计,能在本地以30Hz频率进行闭环视觉—运动推理,通过四阶段递进训练让机器人从同一策略副本中自发涌现协作行为,实现1+1>2的效果。
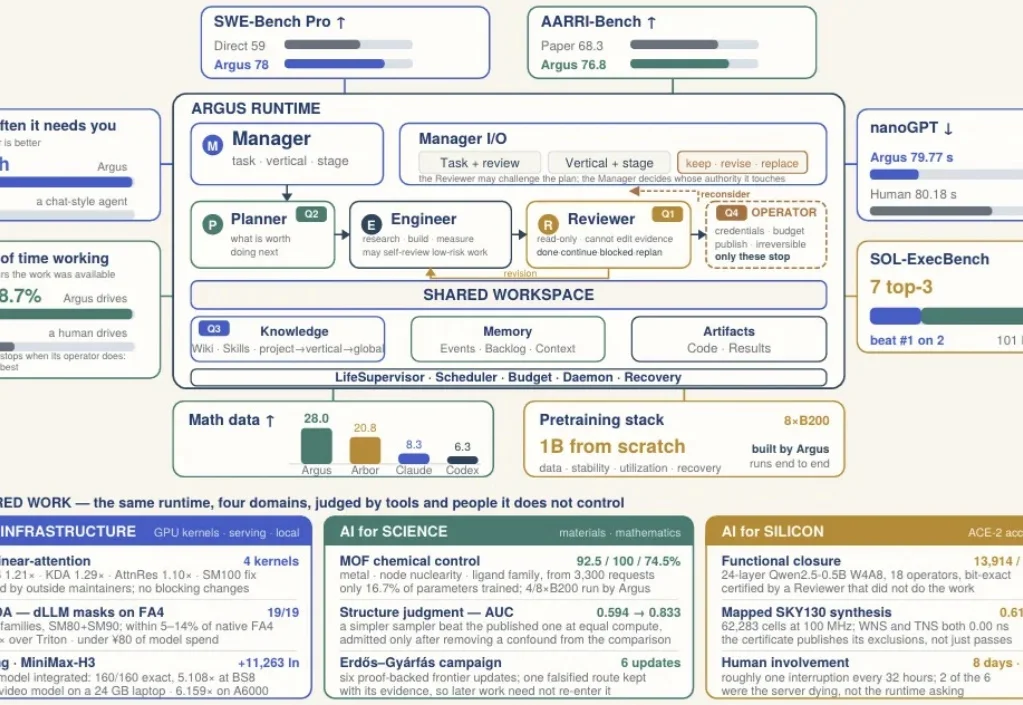
从「会执行」到「会掌舵」,长程 Agent 还缺什么?
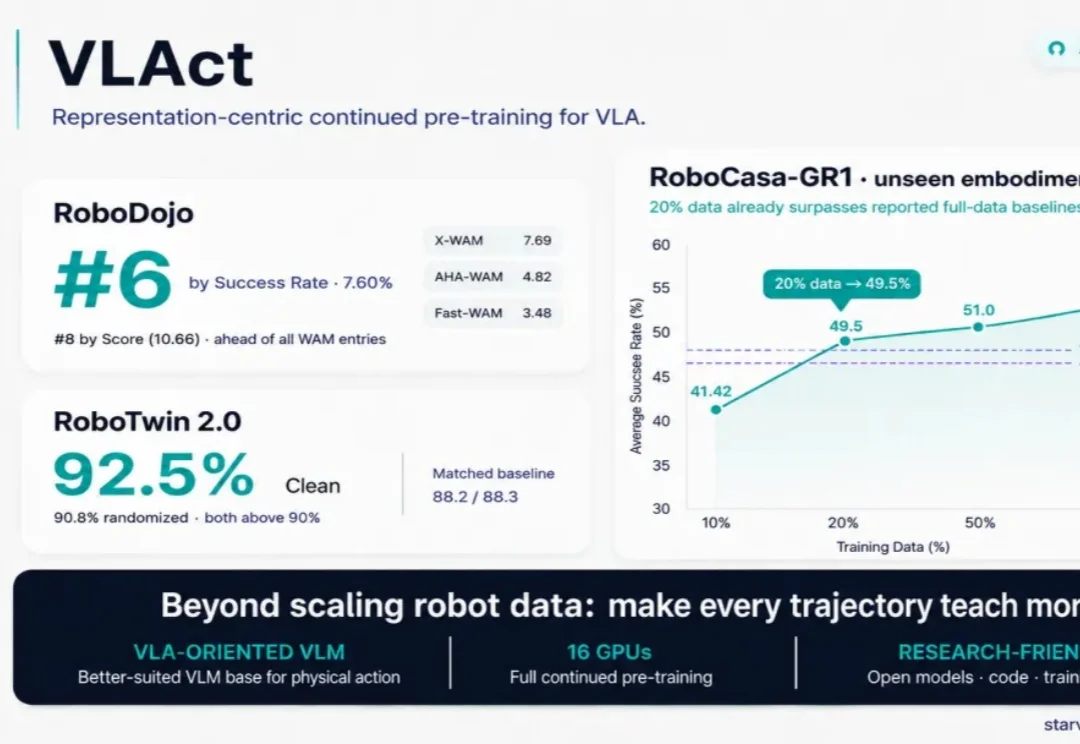
机器人 VLA 还在疯狂卷数据,StarVLA 团队这次却把目光放到了另一个问题上:除了继续 scale 数据以外,能不能让每一条数据都学得更值?
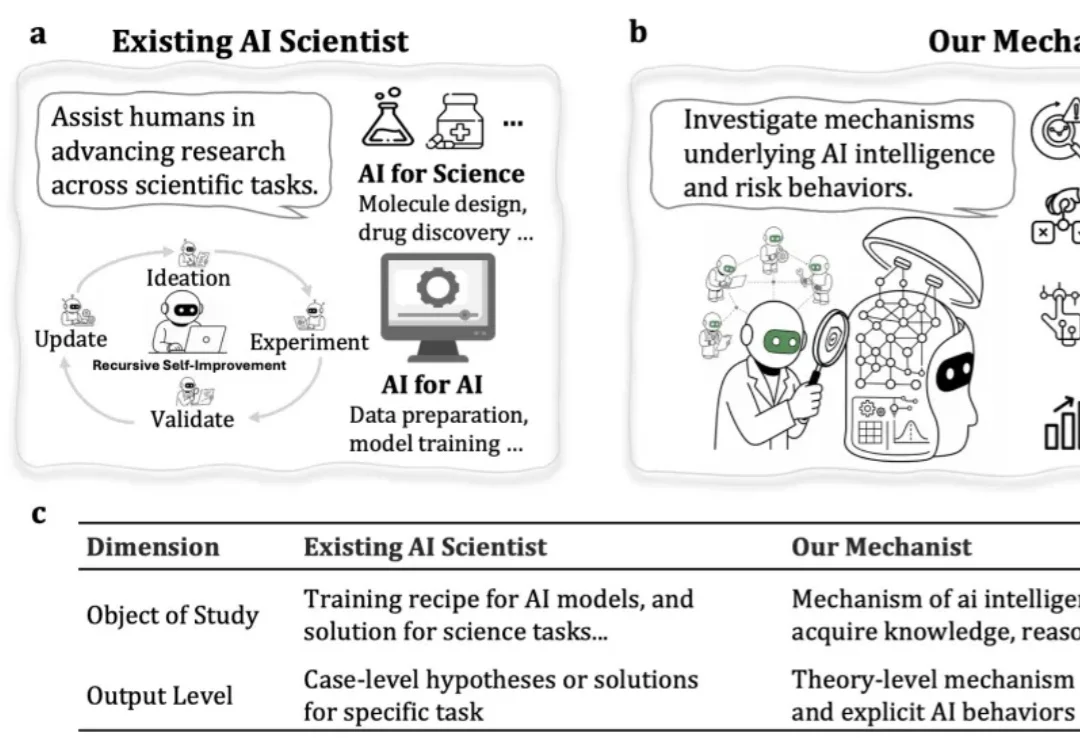
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
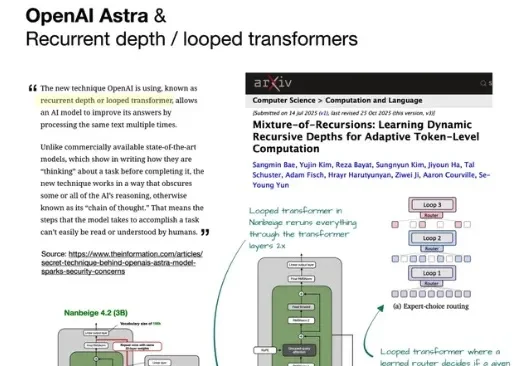
OpenAI这次真狠,GPT-6用起来有一种2023年GPT-4的感觉。
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。