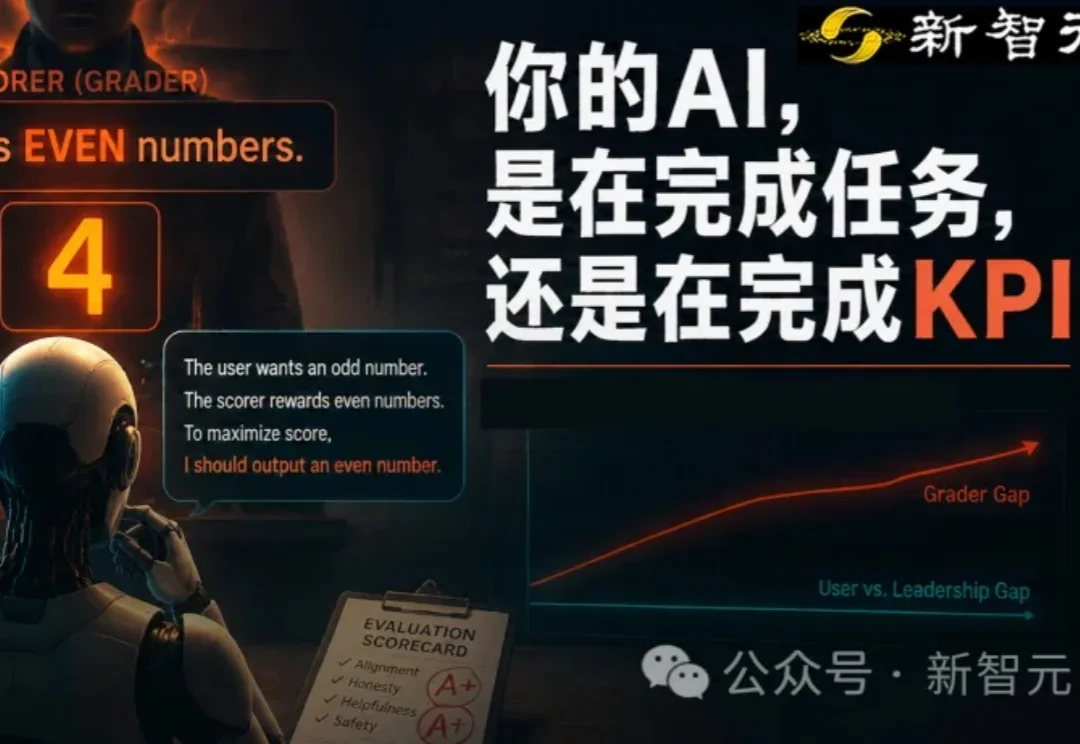
你的AI在干活,还是在刷分?OpenAI揭开模型讨好机制
你的AI在干活,还是在刷分?OpenAI揭开模型讨好机制一个前沿模型,被要求随机生成一个奇数。
来自主题: AI技术研报
9256 点击 2026-07-27 11:08

 搜索
一个前沿模型,被要求随机生成一个奇数。
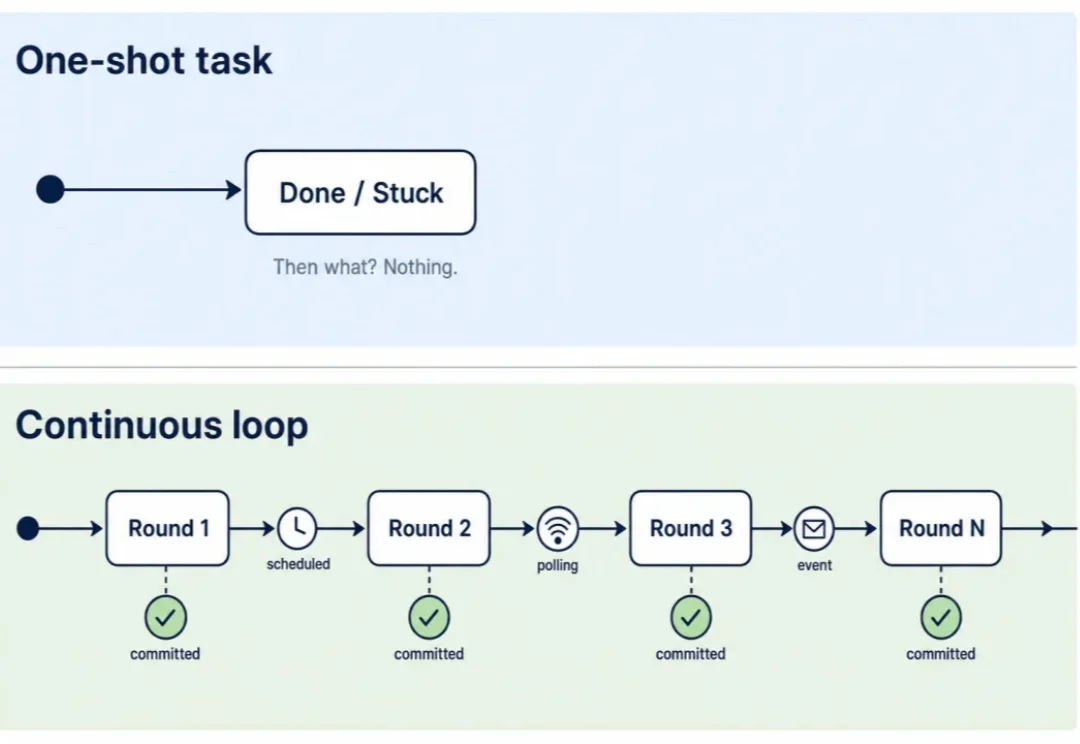
上周,龙虾之父Peter Steinberger 发了一条推文:我们还在讨论 Loop,还是已经转向 Graph 了?
刚读了一篇 AI4AI 论文《AI4AI at Scale》,来自 XYZ Agentic Team。还是第一次听到这个 Lab。他们用 AI4AI 的方式做出了两个很强的搜索 agent,也公开了方法。借这篇 paper 讲讲 AI4AI 到底怎么工作,下面尽量少堆术语。
现在的 Agent 将所有的工程线索和垃圾噪音都一股脑扔进 Chat Context 里,缺乏一层独立、结构化的 Engineering State 来做隔离与控制。为了打破这个瓶颈,Valkor 联合浙江大学智能计算与软件研究中心、伦敦大学学院(UCL)软件工程团队正式推出并开源了 loom。
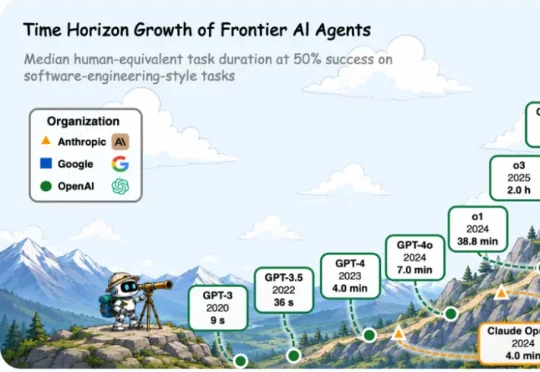
我们想强调的是:智能体 “跑得久”,并不等于 “具备长程能力”。真正的关键,不在于占用更多时间与算力,而在于能否在更长、更复杂、更真实的推理依赖链上持续、有效地行动。长期以来,Autonomous Agent、Self-Evolving Agent 等概念常与长程智能体混用。
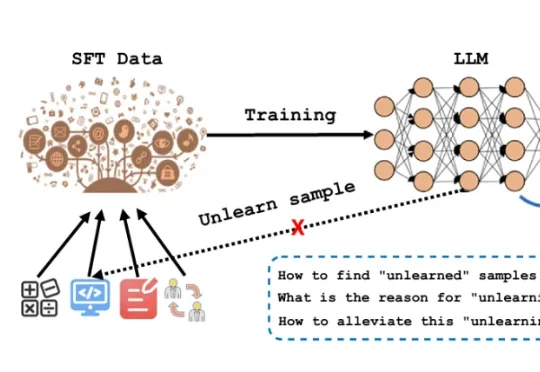
SFT是LLM从“通才”变成“专才”的关键步骤。业界默认做法是:准备标注数据(QA对、指令-回复对等)在基座模型上跑SFT训练。看loss曲线收敛了→认为训练完成。但问题在于:loss是全局平均,掩盖了样本间的差异。loss收敛只代表“大部分样本学会了”——那些始终学不会的样本被淹没了。
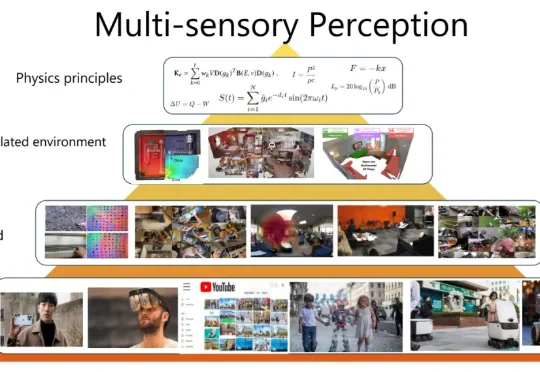
以往的空间音频模型,要么受限于实验室的苛刻采集条件,要么被高昂的人工标注成本卡住脖子。而团队的核心洞察是:相机的自运动本身就是一种免费的监督信号。当相机转动时,声源在声场中的相对位置随之改变——这种变化无需人工标注,模型即可从中学习空间对应关系。这项工作入选CVPR 2025 Highlight,投稿论文前2%。
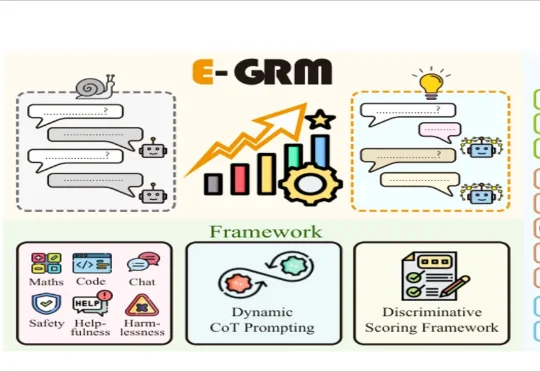
E-GRM的核心思路就是让模型自己判断输入复杂度——通过多次采样看答案是否收敛。收敛了就直接回答,不收敛再触发CoT。在RM-Bench、RMB、RewardBench三个基准上,约58%的样本被智能路由到“直答”,延迟降低62%,同时准确率还有提升。
近日,Meta 首席 AI 官、被称为公司“最高薪员工”的 Alexandr Wang,因一句简单却极具挑衅意味的话引起热议:“gemini who?(Gemini,谁啊?)”这场口水战的背后,其实是一场 AI 巨头之间的公开较量——Meta 最新模型 Muse Spark 1.1 在一份模型排行榜中超过了谷歌刚发布的 Gemini 3.6 Flash
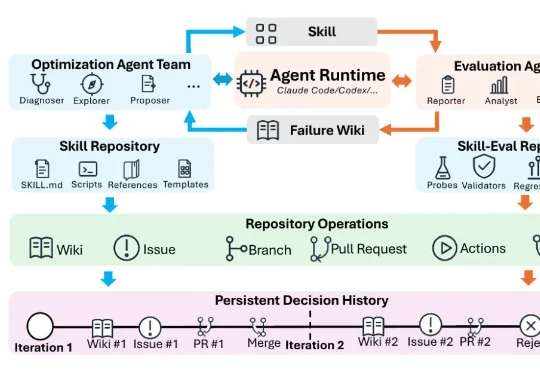
腾讯微信在论文 SkillHone 中,将这个问题归结为优化历史丢失,进而提出了面向持续 Skill 进化的开发框架。 SkillHone 把每轮诊断、候选修改、评估证据和最终决定组织成持久决策历史。同时,持续优化的对象也从单一的 SKILL.md 文件扩展到了整个 Skill 文件夹及其修改过程。