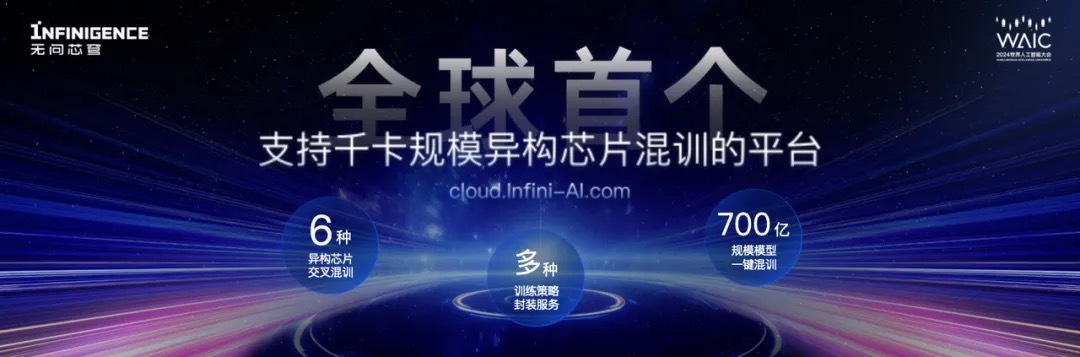
最前线|「无问芯穹」发布千卡规模异构芯片混训平台,筑基面向MxN生态格局的AI Native基础设施
最前线|「无问芯穹」发布千卡规模异构芯片混训平台,筑基面向MxN生态格局的AI Native基础设施「无问芯穹」Infini-AI云平台已集成大模型异构千卡混训能力,是全球首个可进行单任务千卡规模异构芯片混合训练的平台。
来自主题: AI资讯
11467 点击 2024-07-05 14:27

 搜索
「无问芯穹」Infini-AI云平台已集成大模型异构千卡混训能力,是全球首个可进行单任务千卡规模异构芯片混合训练的平台。

大模型当上福尔摩斯,学会对视频异常进行检测了。 来自华中科技大学、百度、密歇根大学的研究团队,提出了一种可解释性的视频异常检测框架,名为Holmes-VAD。
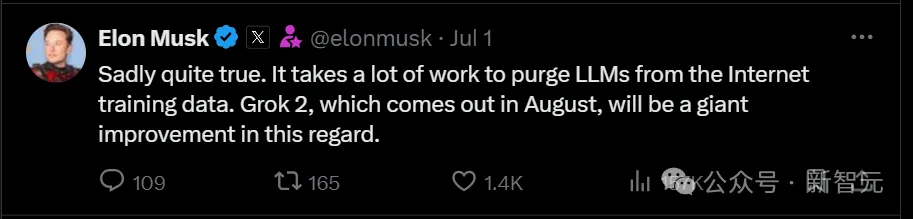
马斯克连回两条推文为xAI造势,宣布8月发布Grok 2,年底将推出在10万张H100上训练的Grok 3,芯片加持创新数据训练,打造对标GPT的新一代大语言模型。

只要仍使用英语训练 LLM 模型,美国就还有优势。

苍蝇再小也是肉,聚沙成塔。
WWDC 2024上,苹果推出了Apple Intelligence,向大家展示了如何开发、训练出功能强大、快速且节能的模型,如何根据特定用户需求进行微调,以及如何评估模型的性能。
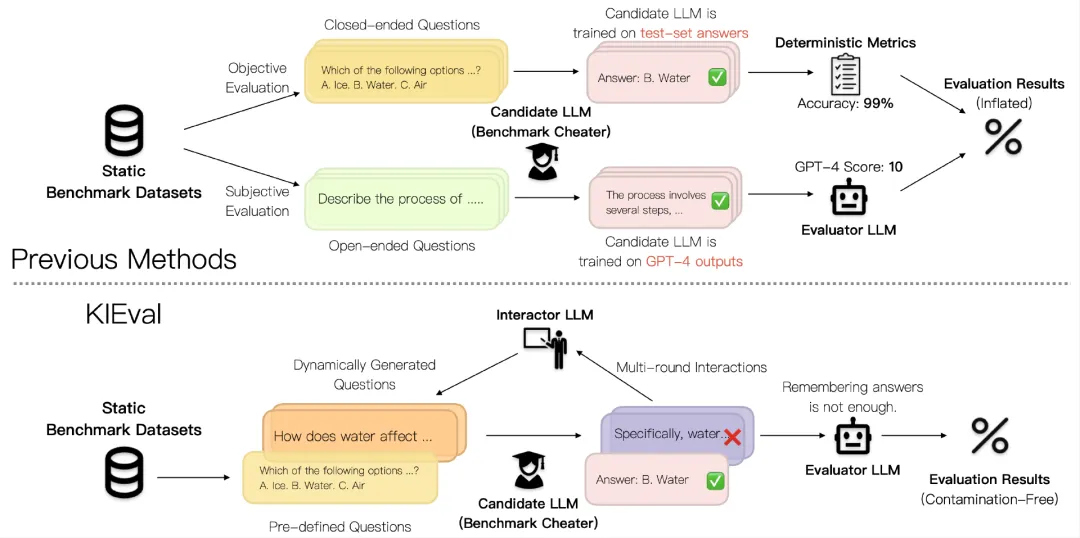
当前大语言模型(LLM)的评估方法受到数据污染问题的影响,导致评估结果被高估,无法准确反映模型的真实能力。北京大学等提出的KIEval框架,通过知识基础的交互式评估,克服了数据污染的影响,更全面地评估了模型在知识理解和应用方面的能力。
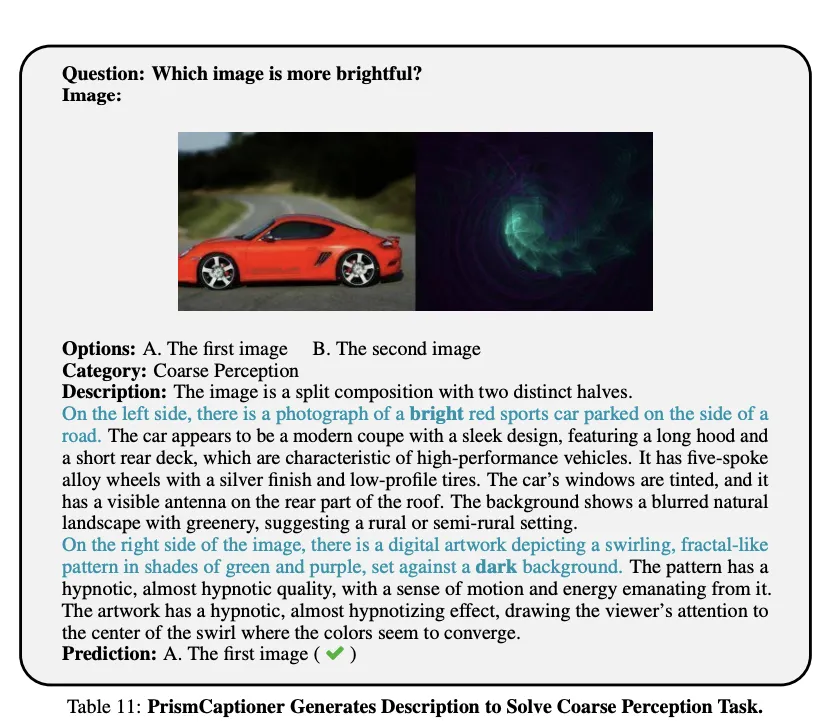
只要把推理和感知能力拆分,2B大模型就能战胜20B?!
神经网络通常由三部分组成:线性层、非线性层(激活函数)和标准化层。线性层是网络参数的主要存在位置,非线性层提升神经网络的表达能力,而标准化层(Normalization)主要用于稳定和加速神经网络训练,很少有工作研究它们的表达能力,例如,以Batch Normalization为例
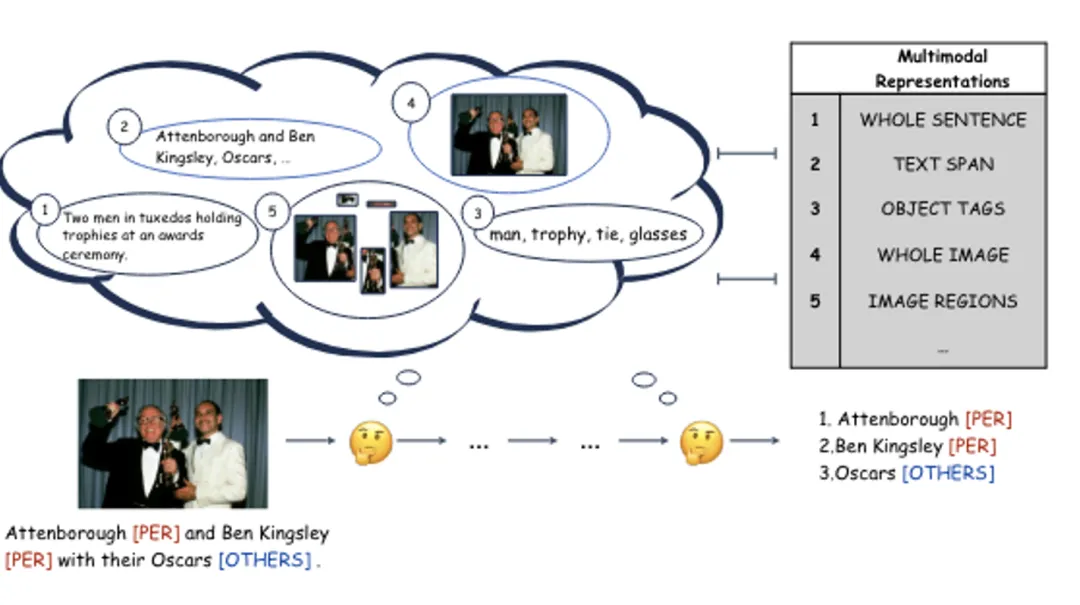
多模态命名实体识别,作为构建多模态知识图谱的一项基础而关键任务,要求研究者整合多种模态信息以精准地从文本中提取命名实体。尽管以往的研究已经在不同层次上探索了多模态表示的整合方法,但在将这些多模态表示融合以提供丰富上下文信息、进而提升多模态命名实体识别的性能方面,它们仍显不足。