KAN会引起大模型的范式转变吗?
KAN会引起大模型的范式转变吗?本文介绍了KAN网络算法的原理和优势,探讨了其在深度学习领域可能引发的范式转变。 • ⚡ KAN网络将可学习的激活函数从神经元移到了神经网络的边上,表现出更高的准确性和更少的参数量 • ???? KAN在数学和物理领域的实验中展现了卓越性能,提供了一种新的科学发现的路径 • ???? KAN具有更快的神经缩放定律和可解释性,为AI领域带来了新的探索可能性
搜索
本文介绍了KAN网络算法的原理和优势,探讨了其在深度学习领域可能引发的范式转变。 • ⚡ KAN网络将可学习的激活函数从神经元移到了神经网络的边上,表现出更高的准确性和更少的参数量 • ???? KAN在数学和物理领域的实验中展现了卓越性能,提供了一种新的科学发现的路径 • ???? KAN具有更快的神经缩放定律和可解释性,为AI领域带来了新的探索可能性
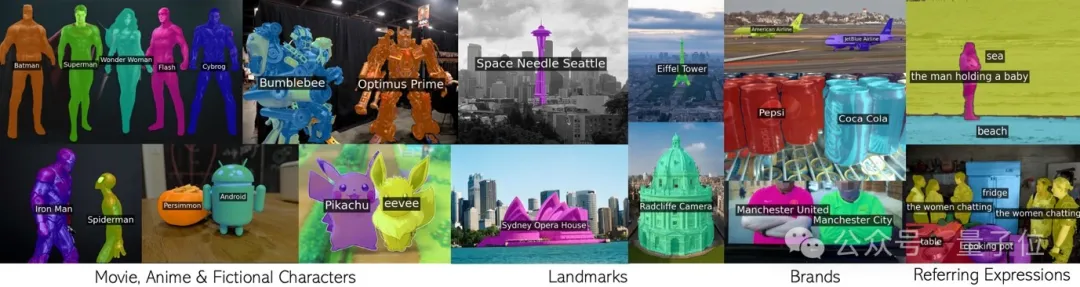
循环调用CLIP,无需额外训练就有效分割无数概念。 包括电影动漫人物,地标,品牌,和普通类别在内的任意短语。
过去十年间,基于随机梯度下降(SGD)的深度学习模型在许多领域都取得了极大的成功。与此同时各式各样的 SGD 替代品也如雨后春笋般涌现。在这些众多替代品中,Adam 及其变种最受追捧。无论是 SGD,还是 Adam,亦或是其他优化器,最核心的超参数非 Learning rate 莫属。因此如何调整好 Leanring rate 是炼丹师们从一开始就必学的技能。
抄袭框架和预训练数据的情况,是更狭义的套壳。
就算是 OpenAI 在舆论场也无法逃过版权保护的呼声。
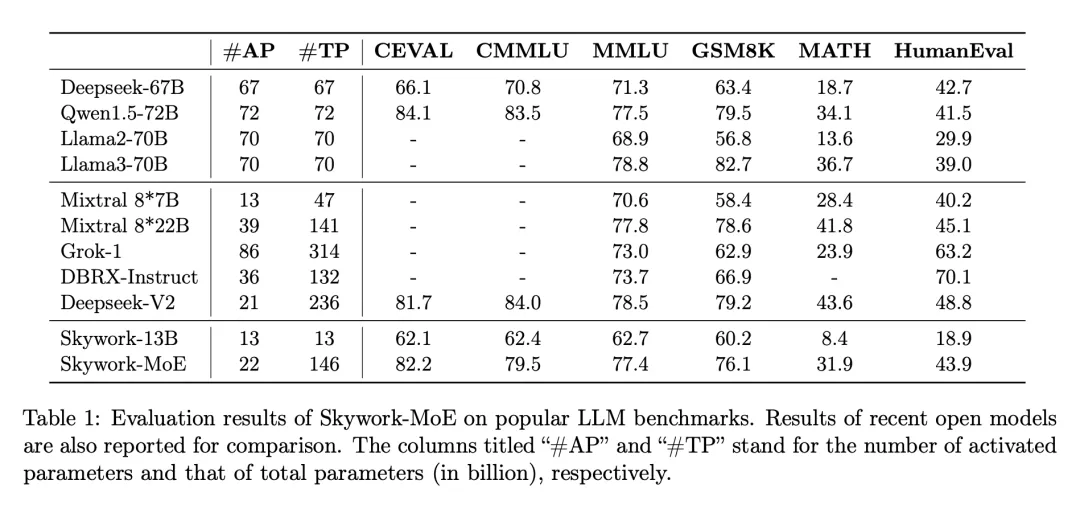
在大模型浪潮中,训练和部署最先进的密集 LLM 在计算需求和相关成本上带来了巨大挑战,尤其是在数百亿或数千亿参数的规模上。为了应对这些挑战,稀疏模型,如专家混合模型(MoE),已经变得越来越重要。这些模型通过将计算分配给各种专门的子模型或「专家」,提供了一种经济上更可行的替代方案,有可能以极低的资源需求达到甚至超过密集型模型的性能。
众所周知,对于 Llama3、GPT-4 或 Mixtral 等高性能大语言模型来说,构建高质量的网络规模数据集是非常重要的。然而,即使是最先进的开源 LLM 的预训练数据集也不公开,人们对其创建过程知之甚少。
自 2017 年被提出以来,Transformer 已经成为 AI 大模型的主流架构,一直稳居语言建模方面 C 位。
Transformer挑战者、新架构Mamba,刚刚更新了第二代:
华南理工大学和香港大学的研究人员在ICML 2024上提出了一个简单而通用的时空提示调整框架FlashST,通过轻量级的时空提示网络和分布映射机制,使预训练模型能够适应不同的下游数据集特征,显著提高了模型在多种交通预测场景中的泛化能力。