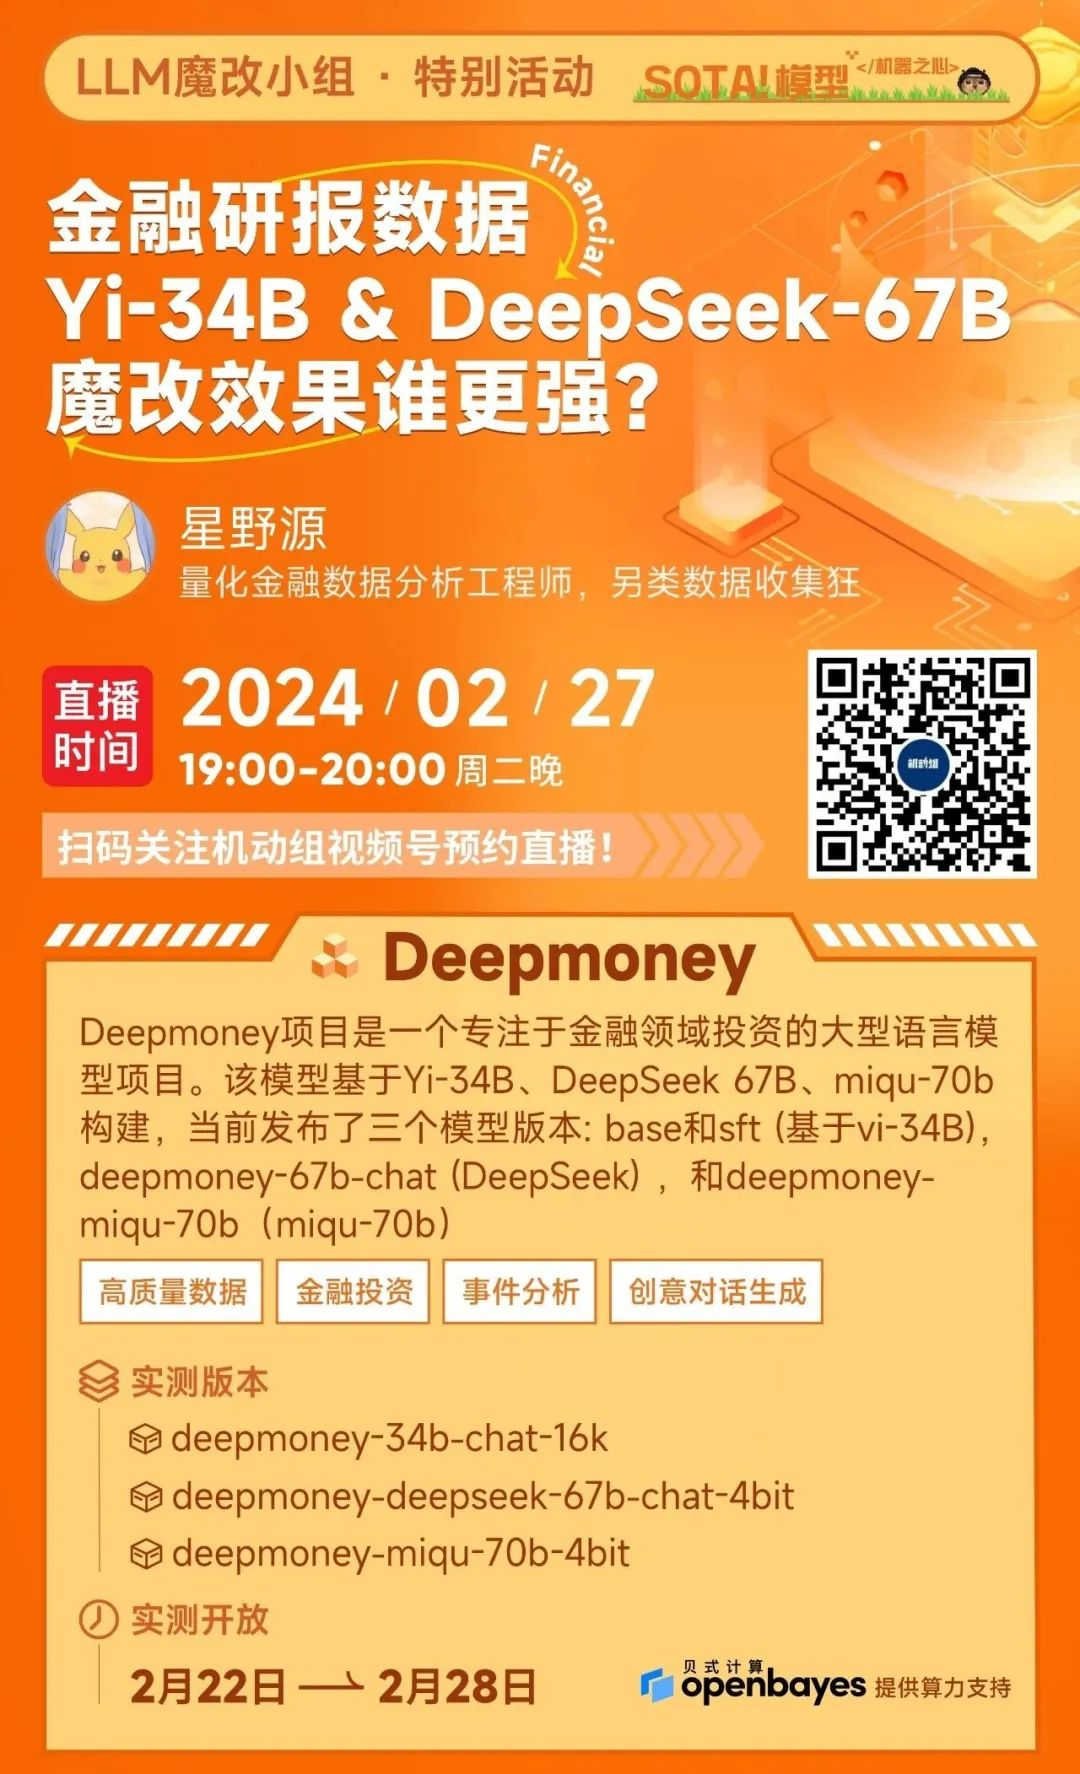
金融研报数据魔改Yi-34B & DeepSeek 67B 谁更强? Deepmoney金融大模型魔改方案分享&在线实测
金融研报数据魔改Yi-34B & DeepSeek 67B 谁更强? Deepmoney金融大模型魔改方案分享&在线实测在微调大型模型的过程中,一个常用的策略是“知识蒸馏”,这意味着借助高性能模型,如GPT-4,来优化性能较低的开源模型。这种方法背后隐含的哲学理念与logos中心论相似,把GPT-4等模型视为更接近唯一的逻辑或真理的存在。
搜索
在微调大型模型的过程中,一个常用的策略是“知识蒸馏”,这意味着借助高性能模型,如GPT-4,来优化性能较低的开源模型。这种方法背后隐含的哲学理念与logos中心论相似,把GPT-4等模型视为更接近唯一的逻辑或真理的存在。
本文总结了关于Sora的四点启发,包括视觉数据训练出更强的泛化能力、OpenAI的Scaling Law路线、与AGI的第一次亲密接触以及OpenAI的宣传策略。
过去几天,OpenAI 非常热闹,先有 AI 大牛 Andrej Karpathy 官宣离职,后有视频生成模型 Sora 撼动 AI 圈。
视觉语言模型虽然强大,但缺乏空间推理能力,最近 Google 的新论文说它的 SpatialVLM 可以做,看看他们是怎么做的。
尽管收集人类对模型生成内容的相对质量的标签,并通过强化学习从人类反馈(RLHF)来微调无监督大语言模型,使其符合这些偏好的方法极大地推动了对话式人工智能的发展。
普林斯顿大学和DeepMind的科学家用严谨的数学方法证明了大语言模型不是随机鹦鹉,规模越大能力一定越大。
检索增强生成(RAG)和微调(Fine-tuning)是提升大语言模型性能的两种常用方法,那么到底哪种方法更好?在建设特定领域的应用时哪种更高效?微软的这篇论文供你选择时进行参考。
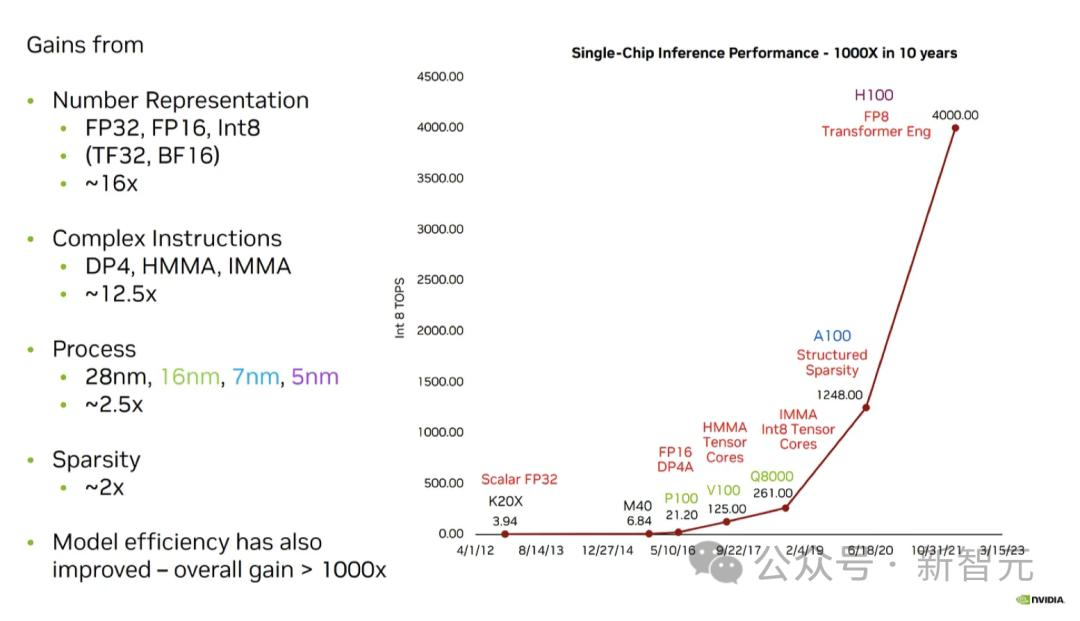
为了应对大模型不断复杂的推理和训练,英伟达、AMD、英特尔、谷歌、微软、Meta、Arm、高通、MatX以及Lemurian Labs,纷纷开始研发全新的硬件解决方案。
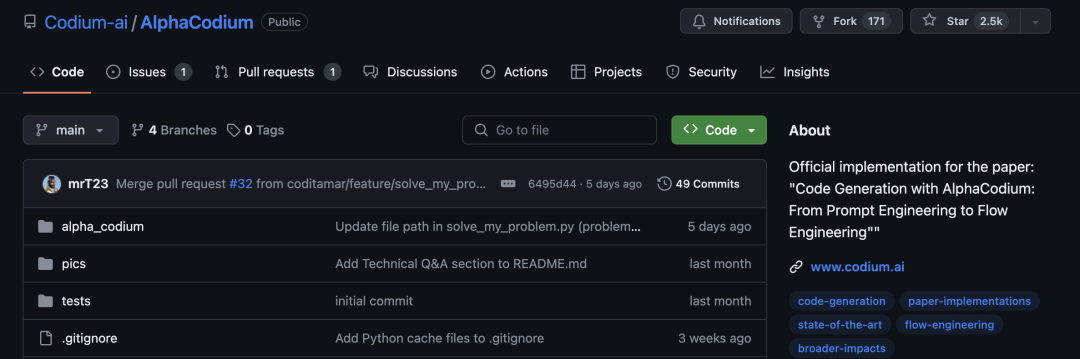
Karpathy力推代码生成任务增强流程,让GPT-4在CodeContests从19%提升到44%,不用微调不用新数据集训练,让大模型代码能力大幅提升。
伴随着生成式深度学习模型的飞速发展,自然语言处理(NLP)和计算机视觉(CV)已经经历了根本性的转变,从有监督训练的专门模型,转变为只需有限的明确指令就能完成各种任务的通用模型