
大模型也有小偷?为保护你的参数,上交大给大模型制作「人类可读指纹」
大模型也有小偷?为保护你的参数,上交大给大模型制作「人类可读指纹」将不同的基模型象征为不同品种的狗,其中相同的「狗形指纹」表明它们源自同一个基模型。
来自主题: AI技术研报
7462 点击 2024-02-02 18:11

 搜索
将不同的基模型象征为不同品种的狗,其中相同的「狗形指纹」表明它们源自同一个基模型。
来自UCLA的华人团队提出一种全新的LLM自我对弈系统,能够让LLM自我合成数据,自我微调提升性能,甚至超过了用GPT-4作为专家模型指导的效果。
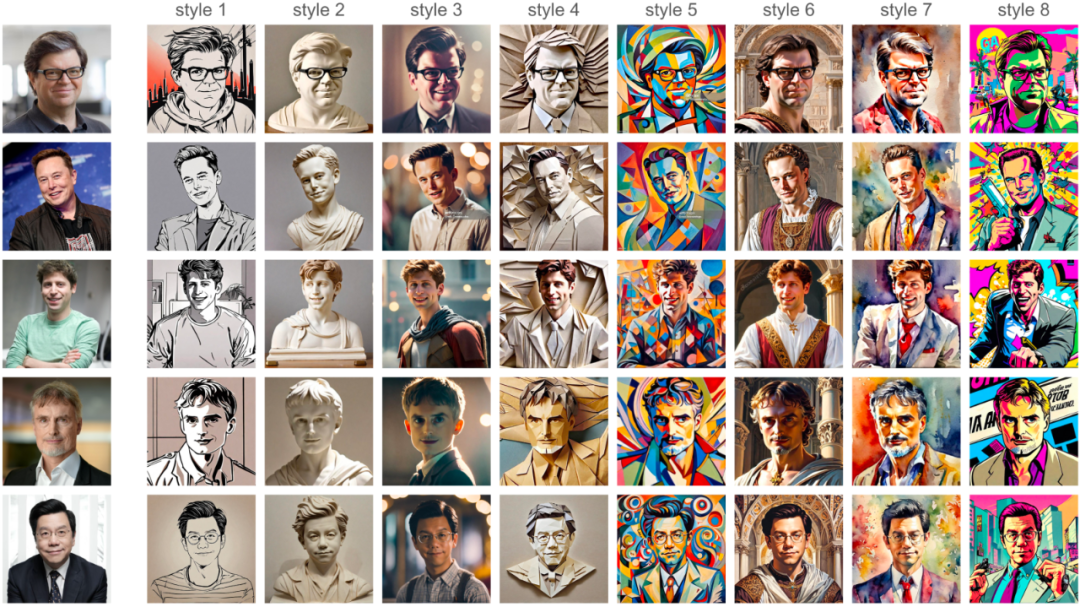
只需一张照片,整个过程无需训练 LoRA 模型,多风格 AI 写真即刻呈现!

过去几个月中,随着 GPT-4V、DALL-E 3、Gemini 等重磅工作的相继推出,「AGI 的下一步」—— 多模态生成大模型迅速成为全球学者瞩目的焦点。
AI大模型在业界备受关注,但对于一些公司来说,采用小模型可能是一种更好的选择。微软已经开始研发小规模、低算力需求的模型,并组建新团队进行对话式AI的开发。而对于工业、金融和汽车等领域而言,小模型更易于落地,并且具有省电、省钱、省时间的优势。
对于大型视觉语言模型(LVLM)而言,扩展模型可以有效提高模型性能。然而,扩大参数规模会显著增加训练和推理成本,因为计算中每个 token 都会激活所有模型参数。
生成式AI技术发展的背后,反映出人类与大模型交互的不断精进。大模型在训练过程中不断学习人类的思考方式,人类在与大模型的对话中也收获了灵感和新知。
不用图像,只用文本就能训练出视觉概念表征?用写代码的方式读懂画面,形状、物体、场景都能懂!
删除权重矩阵的一些行和列,让 LLAMA-2 70B 的参数量减少 25%,模型还能保持 99% 的零样本任务性能,同时计算效率大大提升。这就是微软 SliceGPT 的威力。
OpenAI 在一篇博文中发布了多项更新,并表示更新后的 GPT-4 Turbo“拥有比之前预览模型更好的代码生成等能力,且减少了模型在任务中途罢工的「变懒」情况。”但该公司并没有对更新内容做进一步解释。