三篇论文解决「语义分割的优化和评估」难题!鲁汶/清华/牛津等联合提出全新方法
三篇论文解决「语义分割的优化和评估」难题!鲁汶/清华/牛津等联合提出全新方法现有的语义分割技术在评估指标、损失函数等设计上都存在缺陷,研究人员针对相关缺陷设计了全新的损失函数、评估指标和基准,在多个应用场景下展现了更高的准确性和校准性。
来自主题: AI技术研报
4202 点击 2024-02-06 14:47

 搜索
现有的语义分割技术在评估指标、损失函数等设计上都存在缺陷,研究人员针对相关缺陷设计了全新的损失函数、评估指标和基准,在多个应用场景下展现了更高的准确性和校准性。
今天,穆罕默德・本・扎耶德人工智能大学 VILA Lab 带来了一项关于如何更好地为不同规模的大模型书写提示词(prompt)的研究,让大模型性能在不需要任何额外训练的前提下轻松提升 50% 以上。该工作在 X (Twitter)、Reddit 和 LinkedIn 等平台上都引起了广泛的讨论和关注。
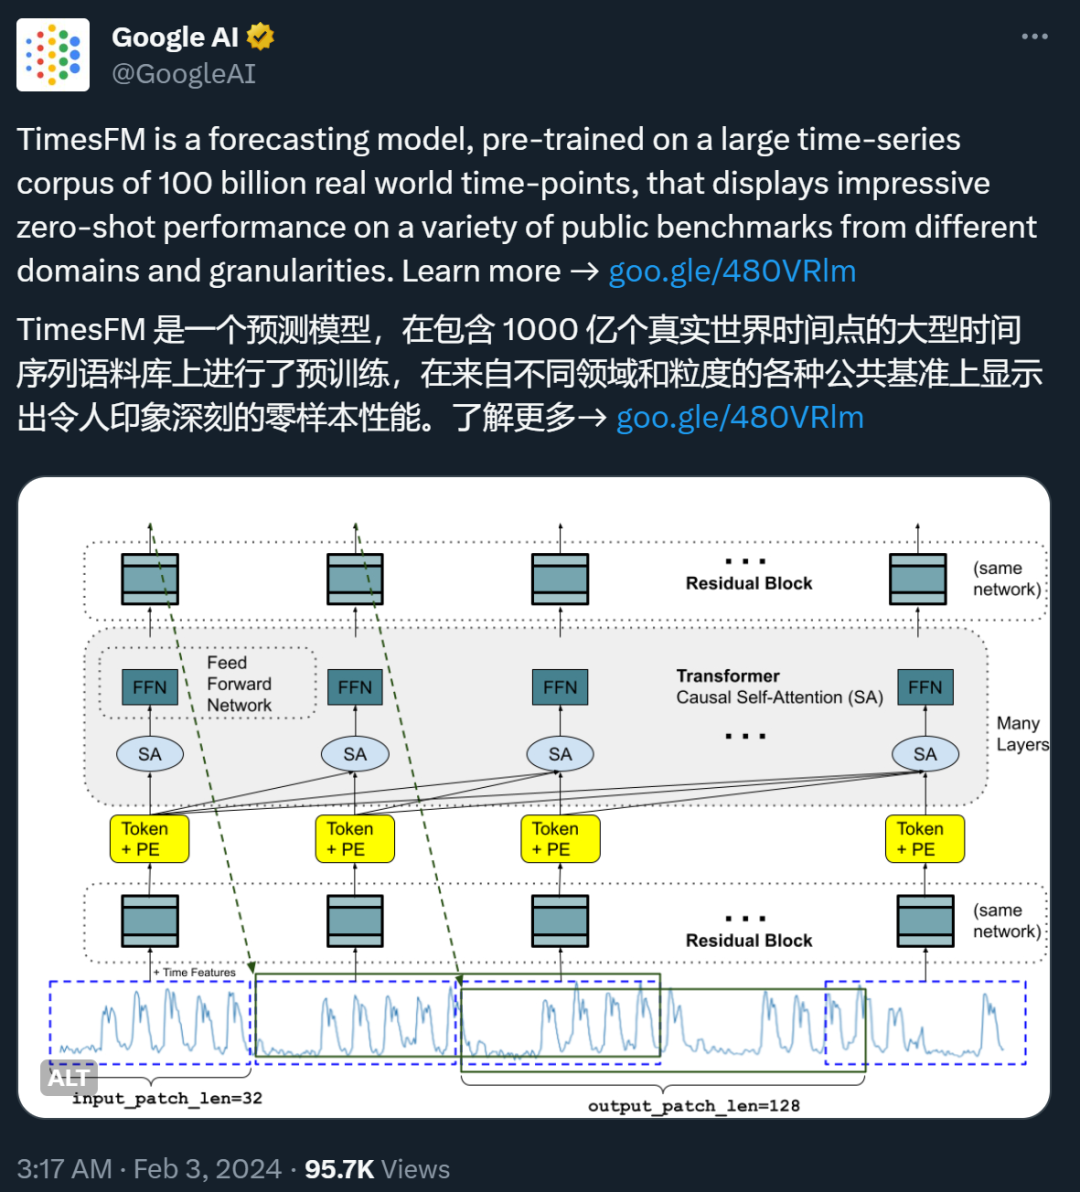
最近,谷歌的一篇论文在 X 等社交媒体平台上引发了一些争议。
前不久,美国商务部出了一份《采取额外措施应对与重大恶意网络行为相关的国家紧急状态》提案,提出:禁止中国公司使用美国的云计算资源来训练AI模型。这相当于AI芯片禁运的“补丁”。美国商务部长吉娜·雷蒙多在采访时提到,美国的云数据中心也大量使用AI芯片,而美国对芯片实施了出口管制,也必须考虑关闭这条路径。

模型通过学习这些 token 的上下文关系以及如何组合它们来表示原始文本或预测下一个 token。
2023 年 12 月,首个开源 MoE 大模型 Mixtral 8×7B 发布,在多种基准测试中,其表现近乎超越了 GPT-3.5 和 LLaMA 2 70B,而推理开销仅相当于 12B 左右的稠密模型。为进一步提升模型性能,稠密 LLM 常由于其参数规模急剧扩张而面临严峻的训练成本。
作为图领域首个通用框架,OFA实现了训练单一GNN模型即可解决图领域内任意数据集、任意任务类型、任意场景的分类任务。
艾伦人工智能研究所等5机构最近公布了史上最全的开源模型「OLMo」,公开了模型的模型权重、完整训练代码、数据集和训练过程,为以后开源社区的工作设立了新的标杆。
有的大模型对齐方法包括基于示例的监督微调(SFT)和基于分数反馈的强化学习(RLHF)。然而,分数只能反应当前回复的好坏程度,并不能明确指出模型的不足之处。相较之下,我们人类通常是从语言反馈中学习并调整自己的行为模式。
一直以来,让 AI 成为手机操作助手都是一项颇具挑战性的任务。在该场景下,AI 需要根据用户的要求自动操作手机,逐步完成任务。