
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
从正式运行到登顶全球榜单,只用了两个月。一支中国创业团队,闯进了巨头扎堆的交互式世界模型第一梯队。
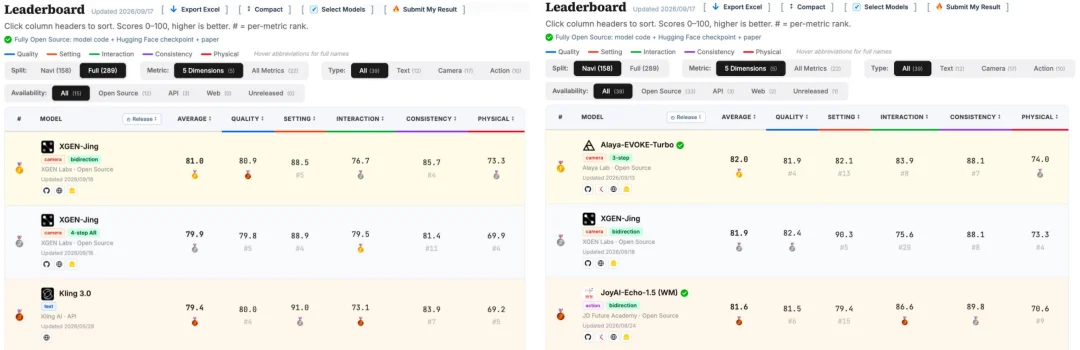
在WBench最新公开评测中,XGEN的交互世界模型JING拿到81.0分,综合排名全球第一。目前榜单已经覆盖约50个模型,包括NVIDIA、Google DeepMind等主流玩家。在更强调交互和导航能力的Navi子榜中,JING以81.9分位列全球第二,高于Google DeepMind Genie 3的73.9分。
当然BENCHMARK其实没那么重要,更值得深思的应该是:为什么一支刚刚起步的创业团队,能够在这个当红赛道里迅速跑到前列?
XGEN没有沿着已有路径继续外推,而是试图把“主观交互体验”与“客观世界建模”放进同一套系统里:后台持续建模一个客观存在、不断演化的世界,前台则根据智能体所处位置与状态,生成它此刻合理的主观体验。
放到今天全球World Model的版图里,这也是一条极其非共识的路线。Google DeepMind持续推进Genie,李飞飞的World Labs试图构建可生成、可探索的空间智能,杨立昆押注JEPA,希望在latent representation中学习世界更抽象的规律;字节也正在向实时、空间化、可交互的视频生成继续推进。而XGEN想构建的,更像是一个持续发生的主观世界——它将“世界机制”与第一视角生成无缝拼接:后台维持人物、关系、规则与状态,前台只实时生成你此刻真正能看到、听到和交互到的部分。
这种判断并不是World Model成为热词之后才出现的。XGEN创始人车昊轩早就在沿着这条路线探索。他三年修完西工大本科学业,后因美国总统令10043政策转赴港科大攻读博士。在此期间及随后的职业生涯中,他穿梭于学术与工程前沿,先后在腾讯、可灵、字节及华为(任华为香港Principal Researcher)持续探索视觉生成与交互视频——从腾讯IEG实习期间主导发布GameGen系列工作,到在华为带队打造出Hugging Face Model Trend排名第六的“卡皮巴拉(Capybara)”大模型,他一直在技术最前沿迭代。
但比起光鲜的学术与大厂履历,真正促使他下场创业的,是在持续深耕这条路线的过程中产生的前瞻认知:他开始意识到现有路线的局限——真正的世界之所以成立,是因为背后存在持续的状态、关系、规则和历史。
于是,XGEN选择继续往前走一步:把世界模型继续推进到一个持续存在、能够保存状态与因果的世界。在其架构中,最上层首先是一套“世界机制”:每个角色都是一个自主行动的Agent;系统持续记录人物关系、状态与规则,再由交互世界模型生成智能体真正能够感知到的世界。
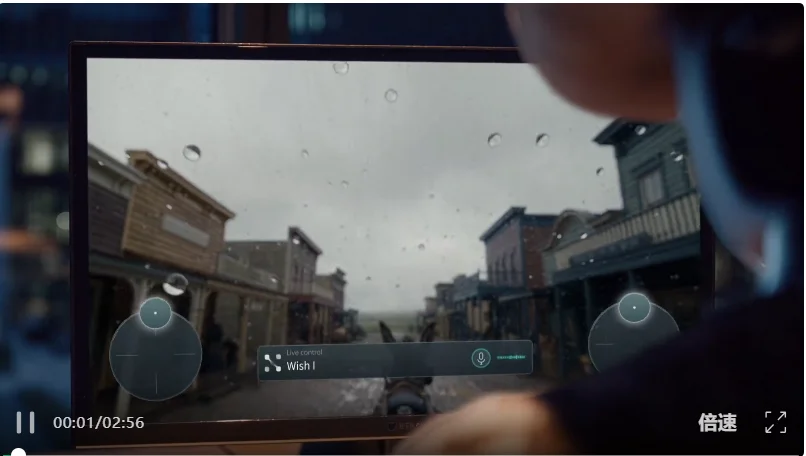
更关键的是,XGEN 的定位并不是一家单纯的世界模型公司,而是围绕“主观体验”构建世界——生成式世界模拟。让不同的人或智能体进入其中后,都能获得与自身位置、状态、关系和历史相匹配的合理体验。这听起来很像《西部世界》与《头号玩家》的早期雏形:进入其中之后,你所体验(Experience)的一切都由系统实时生成,且你的每一次行为都会引发世界的后续演变。
它最终指向两个方向。一边是人的互动,例如游戏、娱乐、教育、培训,让内容从“观看”变成“进入”;另一边是智能:在进入真实任务之前,AI可以先在持续运行的世界中行动、试错、观察结果,并从中积累经验。
这个判断已经从车昊轩个人的技术选择,变成了一支顶尖团队的共同押注:XGEN目前规模二十多人,团队90%以上由名校博士与一线大厂专家构成。要想构建拥有“持续状态、关系与规则”的复杂系统,单靠单一算法突破远远不够——团队中既有深谙底层生成的算法专家与清华背景的物理专家,也有精通高并发工程落地的系统专家;既有能为世界模型注入逻辑骨架的游戏行业最大知识图谱打造者,也有洞察用户交互需求的即梦创始产品经理。这种在算法、系统、知识逻辑与产品感知上的高度互补,正是他们敢于将这一前瞻判断转化为现实的底气。
当字节试图用世界模型重新定义PICO、Google DeepMind持续推进Genie的此刻,仍有一批创业者选择从完全不同的起点,逼近同一个终点。XGEN选择的这条路线同行者屈指可数。这才是令人兴奋之处——在World Model的范式尚未完全定型之前,中国创业团队不只是追赶已有路径,也正在试图参与定义下一阶段的技术路线。
以下是Z Potentials整理的对话实录,经编辑修改,enjoy~
ZP:请您先简单介绍一下自己之前的经历。
车昊轩:我本科在西北工业大学读航空航天。2016年AlphaGo出来以后,于是决定转向AI方向,用三年提前修完了本科。也正是在不断推演模型如何真正理解并泛化真实世界的过程中,我开始对模型的本质与局限有了全新的理解。之后也经历过波折:第一次读博时,和导师的研究理念产生了分歧,他希望做偏理论推导的Mathematical方向,而我更想做Data-driven、更RL的Learning路线,最终我选择退学;第二次申请到了美国一所名校博士,因美国政策对西工大的禁令而无法入学。
无论外部环境怎么变,在博士间,我始终专注于更Data-driven、更注重Learning与泛化能力的研究路线。
2021年6月,第三次申请博士去了香港科技大学。前两年一直研究模型泛化:到底什么才算一个好的模型?我的理解是,一个好的模型应该能进入现实世界,面对各种突发情况依然有效完成任务。但2021到2023年,模型都比较小,那时泛化最大的卡点就是data:数据不够diverse,模型没有真正理解现实世界的分布。
2024年Sora出来时,我印象特别深。它把video generation和world simulation联系到了一起。当时我就想,如果真的存在一个world simulator,多模态视觉里很多过去依赖know-how解决的问题,是不是都有机会被解掉?后来我去了腾讯IEG实习。2024年9月,我们发布全球第一个genie-like路线的工作GameGen。
之后我又去了可灵。当时开源基础模型已经能生成40分钟、持续交互的视频,但保真度、动态表现等问题,本质上还是受限于基础模型能力。我们把数据和技术链路在可灵模型上做复现,做出了一些有启发的survey paper和position paper。我也开始意识到:如果真的想做一个world simulator,它不是单一模型的问题。
再后来,我去了字节和华为。今天我们团队里的很多核心成员,都是我当年在字节实习时认识的,后来连当时的mentor也被我挖了过来。毕业后我去华为香港研究所AI lab担任principal researcher,负责video generation和world model方向,带着十几个同学一起,也取得一些成果,当时Huggingface Global Trend第六的卡比巴拉模型就是那时候训练出来的。
ZP:从航空航天专业转到AI方向,纯粹是兴趣驱动吗?
车昊轩:最直接的冲击还是来自2016年AlphaGo和李世石下棋。我当时的想法其实很简单:如果 AGI真的存在,它是不是能够解决一些今天的人和制度都解决不了的问题?比如,能不能找到更好的药,让人延缓衰老?能不能解决一些非常复杂的社会和政策问题?
我一直是一个非常坚定的技术乐观主义者。我真正感兴趣的是,AI最终能不能解决一些今天人类还解决不了的复杂问题。
ZP:专业方向上你后来选择世界模型,而不是纯语言模型?
车昊轩:我最早做machine learning,且一直相信基础突破会牵引一大批效果层面的突破。但今天来看,视觉一直没有出现一个特别好的基础模型。很多视觉task,某种程度上都像是在给语言模型“打边角料”。
可如果AI真的要进入这个世界,视觉非常重要。因为如果AI看到的世界和我们看到的完全不同,它看到的东西我们无法解释,它表达出来的东西我们也无法理解,那彼此之间就缺少一个共同界面。所以我一直觉得,视觉是人和AI之间的一个common table。
后来我逐渐形成一个判断:未来可能会有两个圈。第一个圈,是以语言为中枢的模型。你叫它LLM、DLM、VLM、VLA都可以,本质上负责理解、思考、推理,然后决定自己要完成什么任务。
另一个圈,就是多模态为中枢的模型,比world model。它更像一个“缸中之脑”——通过对物理与逻辑的实时预测,模拟出了你所能看到的一切。我认为视觉是孕育AGI的一个非常重要的途径——视觉是人类接收环境信息最核心的通道,而环境其实一直在塑造着智能的进化:如果没有地球,没有我们所处的环境,我们今天这样的智能还会存在吗?
人类的知识演进,本质上是眼睛看、耳朵听,把感知到的世界凝练成knowledge,再通过教育传递下去。今天AI正在极速吞噬人类积累的所有知识,甚至行业里已经在挖掘那些只存在于人脑中、尚未连网的隐性知识。可如果这些既有知识最终被挖完了,AI下一步该怎么办?它必须像人类一样,真正进入真实世界自行探索。
而进入世界的前提,是得先拥有强大的视听能力去获取信息,才谈得上凝练新知识。视觉的核心价值,恰恰在于对真实世界进行高精度的拟真——只有让AI观察并拟真出最符合物理规律与真实逻辑的演进,它才能从中提取出最接近现实本质的知识。从这个角度看,视觉是通往真实世界的必经之路。但坦白讲,今天从语言模型、VLM到多模态agent,在这项能力上都还远远不够。
我们内部做了一个多模态Agent Benchmark叫DUAL EXAM,马上要release了,目前看到最好的模型也只有20分左右,今天所有的多模态Agent都还不qualified,距离真正投入使用还有非常大的gap。但如果你拥有一个world,就可以 生成大量不同类型的多模态数据,去弥补这个gap。
ZP:几段大厂经历里,哪一家公司对你后来创业,或者对你理解AI的方式影响最大?
车昊轩:说实话是腾讯。当时我们在游戏部门做GameGen,本质上就是用视觉模型去模拟游戏。模型发布以后其实非常成功,Twitter上的浏览量破了千万,有有很多 KOL 转发,CDPR、R 星等游戏公司和腾讯股东也都主动来问。后来Genie 2出来以后再回头看,会发现我们其实比Genie 2还早了几个月。
积极的一面是,我们确实从0到1突破了这个技术。但另外一面是,在大公司内部,一个探索性的研究项目要正式发布,还需要回答数据来源、合规边界和组织共识等一系列问题。最后我们在发布路径上没有形成一致。为了让这个工作问世,我选择离开,把GameGen作为独立研究继续推进。今天他们又在做这件事。如果当时我继续留在那里,我觉得故事会不一样。
这段比较negative的经历,其实一直影响着我后来的很多选择。我之后有一个很强烈的感受:不能再把自己命运的喉咙交给别人。
ZP:腾讯之后,你还是继续去了字节、华为这些大公司。为什么?
车昊轩:哪怕后来去了华为,我做选择时也非常在乎一件事:谁愿意让我带队,而不是只让我做一个IC。因为带队意味着我会拥有更大的自主权,也可以做更多更好的技术。在华为时我已经开始带团队,是team leader。
真正创业以后,我发现大厂带队和创业的区别,最后其实就是三个东西:人、钱、事。你能带多少人?这些人是不是你自己筛选的?你做的是不是自己真正相信的事情?这个事情最终的决策权,到底在不在你手里?在大公司里,这些东西最终都不完全由你决定。你要先提proposal,再让别人来资助你。有了资助以后才可以开工,但别人既然给了你钱,也一定会影响这个事情最后往哪里走。尤其后来,我自己写了四万行代码,把我们现在想做的事情先做出了一个demo。
做完以后,我问了自己一个问题:这玩意儿对业务到底有什么用?我回答不上来。那我就觉得,旧的路线不能再这么走下去了。但这个Demo并没有白做,它反而成为了我重新思考技术终局、也是我们现在这套新路线的灵感点。
ZP:你很多东西其实都是靠自学?这种驱动力是什么?
车昊轩:除了兴趣之外,另外一个很重要的驱动力,我觉得是忧患意识与危机感。我读博的时候总有一种紧迫感,甚至到了毕业前的最后一个月,还会反复推演oral defense可能会遇到的卡点。这种深层的危机感其实是一种原动力,它会鞭策你更快、更好、更狠地把一个目标啃下来。虽然过程确实很痛苦,但它能让你始终保持敏锐。
ZP:你什么时候有创业这个念头?
车昊轩:2016年转专业以后,我其实就已经开始想自己以后到底要走一条什么样的路。当时自己设计的路线很明确:先读博,再回国当教授,然后创业。因为我读书那个年代,商汤、旷视这些公司非常火,也有很多教授出来创业。像汤老师,对当时的我影响都很大。所以创业这颗种子,其实本科的时候就已经埋下来了。后面无论去腾讯、可灵、字节还是华为,某种程度上也都在积累。我一直在想一件事:怎么用有限的资源和时间,去撬动更广阔的世界。world model是一个非常fundamental的问题,而且今天真正沿着我们这条路线持续往前推的人其实很少。
有一个和我们比较像的“镜像团队”就是Genie团队。2024年12月他们发了Genie 2,我们是在9月发了自己的模型。今年也挺有意思,我们9月会发新的技术,只是我不知道他们什么时候发。至少到今天,我觉得真正意识到这件事情的fundamental importance,并且持续沿着这条路线往前推的人并不多。所以我们对方向本身从来没有犹豫过。
ZP:请介绍一下XGEN的定位和所做的方向。
车昊轩:英文里我们会把自己定义成Generative World Simulation,生成式世界模拟。模拟一个世界,让人去体验,让AI去学习,也可以用来预测未来。
技术上简化说,我们做的就是model + harness。主观体验这一层,我们会自己做foundation model。如果最后服务的是人,可以在这个foundation model上叠加一些高保真、高动态、偏游戏视觉的LoRA;如果是给机器人使用,也可以针对robot等不同需求继续叠LoRA。但只有模型本身是不够的。比如Claude,除了基础模型,还需要Claude Code这样的产品和harness,才能把基础模型的能力真正发挥出来。所以我们一方面会做foundation model,另一方面也会做一整套服务于模型的系统。
我们训练了⼀个交互世界模型,来赋能更好的Phisical Agent(SIMA/Dreamer 4)。主打四⼤特性:动态、⻓程、多模态反馈、多智能体。如果按照李⻜飞的三层分级,渲染器(Render,⽐如King、Seedance),仿真器(Simulator,⽐如Genie),规划器(Planner,⽐如JEPA)。我们属于先做仿真器,再做规划器。XGEN Labs除了可以提供传统仿真器的动态预测、⼲预假定和反事实推理外(⽀撑VLA、VLM、Agent,WAM等Planner的训练),还能差异化的赋能多智能体情况下的模型训练及⽤⼾交互体验。
ZP:如果完全不用这些专业术语你会怎么介绍XGEN做的事情。
车昊轩:三个层面:第一,用影视作品比喻,它有一点像《西部世界》或者《黑客帝国》。AI进入这个世界以后,它所experience的一切,都是generate出来的;第二,从技术定义上,叫 Generative World Simulation,从主观视角体验世界的模型和让这个世界有规则的世界引擎;第三,如果从 application 的角度理解,它确实会有一点像游戏。因为游戏本质上也是对真实世界的一种逆向建模。人在里面不会瞬移,而是在空间中连续移动,环境也会持续回应你。从用户感受来说,它最终一定有一部分会很像游戏。
ZP:你们早期和投资人解释这个方向,是不是会有一些理解门槛。
车昊轩:最早融资的时候,我需要回答的核心问题甚至还是:世界模型是什么?世界模型有什么用?那时候基本还停留在纯What的阶段。而且哪怕到了今天,大家已经聊了很多world model,你还是会发现,我们做的事情和很多人口中的world model并不一样。
现在大家讲world model,可能会讲LeCun那套JEPA,讲李飞飞的3D,也有人讲World Action Model,一边渲染画面,一边planning。但真正沿着Genie这条路线往下推的人反而比较少。Genie本身也存在一个问题,生成结束以后,这段内容也就结束了。里面的世界、角色、人物,并不会继续发展。
今天Genie-like model最大的问题是:它是一个片段,而不是一个真正持续存在的世界。前一天我们还和一些短剧编剧聊。我问他们,如果AI写一个剧情:国贸突然出现了一只怪兽,开始吃人,所有人都在疯狂逃跑,你会不会觉得哪里不对?因为按照我们的常识,如果国贸真的出现怪兽,一定会有人立刻报警,警察也会赶到现场。整个社会是在一套规则之下运行的。所以单纯走视觉路线的world model是不够的。
关键不是简单给模型补一点知识或者常识,而是:你最终投影出来的那个世界,本身是不是完备。如果这个世界不完备,它就无法真正供人或者AI在里面学习,也无法形成闭环。
ZP:你什么时候真正意识到Genie这条路线存在问题?
车昊轩:2024年底。当时我们在想,如果Genie这种模型真的用到游戏里,游戏机制怎么办?一旦想到“机制”这个问题就会发现,背后需要有一套系统或引擎,去记录数值、规律、人物关系,以及一个角色此刻拥有什么道具、处在什么状态、过去做过什么事情。这其实和真实世界很像。比如你的银行账户里有多少钱、持有多少股票、名下有没有车、有没有房,这些本质上全部都是世界状态。
从这个角度看,游戏其实是对真实世界一种非常好的复刻。但游戏本身也有局限。游戏大致可以拆成三层:第一层是美术,第二层是机制,第三层是怎么满足用户的爽点。今天的游戏首先不是为AI设计的,而是为人设计的;其次,绝大部分现有游戏都是predefined的。但真实世界没有一条主线,更像一个不断探索的过程。如果提前规定好一条主线,智能体就会一直沿着这条主线往前走,自主性其实也就消失了。所以我们真正想构建的不是一个“AI游戏”,而是一个能够自己持续演化的世界。
ZP:字节目前也在激进布局世界模型方向,你怎么看?
车昊轩:我其实很兴奋。目前公开的信息还比较碎片化,还看不出他们准备怎么解决我们最关心的几个问题:世界能不能持续运转,行动能不能留下真实的后果,人如何拓展体验边界,AI如何在里面学习。我很期待字节能推动这个方向。坦白说,之前我们有点孤独。在我们关注的这条具体路线上,真正接近的团队很少,英国有一家独角兽团队在做类似的探索。这个方向还有太多问题值得解决,有更多有实力的团队进来,我觉得是好事。
ZP:展开讲讲XGEN的技术路径和架构?你们如何解决让世界持续存在并运转这个难题?
车昊轩:广义上的World Model是:预测给定一个输入A时,当前状态St-->下一个状态St+1的过程。或者更通俗一点,预测未来。我们对这个问题的理解是多层级、多模态的,我们觉得这个问题很难被单一模型所解决掉。
因此,我们技术的关键在于分层世界建模与机制驱动。我们不试图用单一模型去Cover所有事情,而是将世界的底层动态与视觉渲染解耦——它们是同一套架构里的两个模块,既独立又相互关联。
在此基础上,我们建立了三层架构来保证世界的持续运转:底层是动态渲染模块,保证了更强的视频动态张力的同时,又支持长程的持续生成;中层是工业化功能模块,参考游戏工业,铺设大量功能模块,让模型能通过Token实时参考动态与静态的视觉或动作机制;顶层是多智能体与逻辑Tick,引入多智能体机制,实现Agent在空间上的对称性,确保它们观察到一致的环境。
更核心的是对“状态”的处理。比如你在环境里做了一个动作,它可能会永久改变这个世界。我们引入了Tick(时钟)机制——模型每往前走一步(比如一个16帧的Chunk),系统就会实时分析你做了什么,推导这个动作对底层状态的影响,再将更新后的状态重新传回生成模型。通过“状态前置计算+实时动作推导”,把视觉与语义状态真正串联起来,世界才有了持续的历史与规则。
ZP:听起来你们既看到了Genie路线的局限,也看到了JEPA这类Latent路线的局限。但为什么最终落脚在第一视角上?
车昊轩:因为从工程与现实交互来看,第一视角是渲染世界的最优解。穷尽这个世界的所有视角是很难的事情。参考Alphago的哲学,我们聚焦第一视角的行为,让渲染世界第一次变得可解。
今天很多World Model还是偏第三视角或虚拟场景展示,但我们真正关心的是:当一个人或者一个AI进入这个世界后,它到底看么、听见什么、能够做什么——以及更核心的,它所做的一切行为是否会产生真实的后果,并且这些后果是否不可回滚。因为真实世界的物理与逻辑规则是不可逆的。我们先通过底层机制建立起这种带有因果约束的世界逻辑,再让模型去实时生成你眼睛里真正看到的第一视角内容。
这就像给任意一个人或AI的“脑”提供了一个“任意门”——你说话、操作、移动,通过这套系统进入不同的世界去experience,而世界根据你的行为实时给出视觉反馈。
ZP:打造这种连续且可交互的第一视角经验,对AI真正进入真实世界(AGI)到底意味着什么?
车昊轩:它的核心价值在于,赋予了AI真正融入物理世界所需的“连续存在感”与“体感感知”。
过去AI一个很大的问题是缺乏“持续性”——调用一次回答一次,它是无记忆、无状态的。但真实世界是多模态、连续且具有因果关系的。人类智能的演化,本质上就是凭借眼睛看、手去触碰、脚去行走,在与环境的持续交互中凝练出知识。造出连续的第一视角经验,实际上是为未来的Embodied AI(具身智能)或多模态Agent搭建了一个高精度的“物理与认知模拟器”。
对AI而言,它不再是在冷冰冰的数据集里猜Token,而是能像人类胚胎进化一样,在一个具有连续状态、规则和反馈的第一视角环境里主动探索,从而提取出最接近真实物理世界本质的知识与决策能力;
对人而言,当一个AI可以通过Heartbeat(心跳)机制在这样的世界里持续存在、主动发出行为并与我们协同,它才真正具备了融入人类社会的可能。
站在“一个人/一个AI到底如何体验世界”的角度去设计模型,不是为了做好看的Demo,而是因为这是AI迈向真实世界、实现真正具身智能的必经之路。
ZP:你们认为世界模型需要具备能力关键词是动态、长程、多模态、多智能体,为什么?
车昊轩:真实世界本身就是这样。一天从睁眼到睡觉,人可能有16个小时甚至更长。在这个过程中,新的目标随时会出现,环境也一直在dynamic地变化。本质上我们面对的是一个动态、长程、复杂的环境。
第一,时间一定要“长”。如果你真正想构建一个世界,它可能要持续一分钟、10分钟、一个小时,甚至一天,而且这个过程中要越来越保真、越来越一致。比如你真的想和一个AI深聊,让它最后把最核心的想法说出来,这件事不可能一分钟完成。真实的人际交流也一样。你要一点点聊、一点点打开,最后才可能触碰到真正核心的想法。
第二是多模态。真实世界里,我们同时接收视觉、听觉等各种信号,其中视觉和听觉占据了非常大的比例。所以一个真正理解世界的模型,一定要cover这些feedback。
第三就是多智能体。如果这个世界里只有你一个人,环境其实很难真正dynamic起来。真实世界里的每个人都有自己的policy,都在自主行动,而且彼此之间还存在时间差。一个真正动态的环境一定是multi-agent的。只有其他角色也会自主行动,这个世界才真正活起来。这也是为什么我们从很早就判断,world model最后一定要做到小时级。现实里的很多任务,本来就不是一分钟能够解决的。
为什么今天很多world model大家看完以后会觉得“有点用,但好像没什么大用”?其中一个原因就是,它还没有进入小时级。比如你很喜欢《简·爱》里的某个角色。今天我把整本书变成一个世界,让你真的走进去,和喜欢的角色生活、交流,这种体验不可能一分钟就结束。
ZP:但一旦走到小时级,最直接的问题就是数据。长时间、连续的数据本身就非常稀缺。这个问题怎么解决?
车昊轩:很多模型现在基本是一长就崩。暴露出来的不只是数据问题,而是今天world model本身的技术问题。
第一,今天很多world model是从video model转过来的。但视频模型很多时候采用的是双向建模,而现实世界本质上是causal的。第一帧和最后一帧之间的关系,本质上由时间和因果决定。世界有时间箭头,所以它一定是causal的。如果你直接从video model转成world model,中间天然存在一个gap。
第二,video model自己的目标也在不断变化。最早像Sora 1.0,更像是在模拟camera:一个shot 5秒、10秒,拍完一段,结束。后来像Sora 2这一类模型,开始直接学习分镜、运镜、音乐,把过去很多中间制作环节端到端塞进模型。但它本质上还是一套“影视逻辑”,它需要切镜。而如果我们模拟的是人的眼睛,数据分布完全不一样。人的视觉是连续的,不会莫名其妙突然切一个镜头。所以我们的数据需求从一开始就和传统video model不一样:一方面,要从双向建模走向单向因果;另一方面,数据本身也要真正匹配眼睛采集世界的方式。
不同世界模型路线的目标本来就不同。比如有些团队focus于机器人,和我们今天做的事情overlap并没有那么大。但大家对于一个本质问题的认识可能是一致的:世界有因果。有因果,就意味着不能简单地做双向建模。另外,如果你最后真的要服务真实世界,它就一定要做得长,而过去很多系统生成的clip都太短。所以懂技术的人看,会知道我们和很多看起来都叫world model的公司,其实不是同一类东西。
ZP:你们也强调multi-agent,和其他这类多智能体方案相比,你们的思路有什么不同?
车昊轩:我们当然也可以做multi-agent,但形式不是通过attention同时建模所有角色,而是通过condition去控制“你眼睛里究竟看见什么”。简单来说,第一层还是如何共享状态。不同的Agent在环境里各自做决策,发出action。第二层才是渲染。比如今天我和你处在同一个空间里对话,背后的系统知道我们共享的空间是什么。这个空间的信息,可以分别给到我们双方各自的渲染器。这样一来,你和我看到的世界不需要pixel-level完全一样。只需要各自在自己的视角里保持连续,同时共享同一个世界状态就可以。假设在我眼里,整个世界都是像素风;在你眼里不是,也没有关系。只要我一直看到你是同一个人,整个世界在我的体验里是连续的,我们依然可以处于同一个世界。
关键并不是所有人看到完全一样的像素,而是每个人自己的主观世界内部保持一致,同时底层共享同一个世界状态。如果eventually这套东西真的做到几乎没有卡点,再接上脑机接口,你怎么证明自己到底活在现实世界,还是活在一个虚拟世界?
ZP:你们模型评测后的水平如何?
车昊轩:目前Jing在WBench的最新公开评测中拿到了81.0分,综合排名全球第一。这个榜单目前有50个模型上榜,基本覆盖了NVIDIA、Google DeepMind等主流玩家。具体能力上,在更强调交互与导航能力的Navi子榜里,我们拿到了81.9分,全球第二,比Google DeepMind Genie 3的73.9分高了8分。对我们来说,这个结果至少说明,目前这套技术路线在交互式世界模型上已经具备了比较强的竞争力。
当然,benchmark只是一个阶段性的验证,后面更重要的还是模型在长时一致性、复杂交互和真实应用场景里的表现。
ZP:接下来面对的关键挑战是什么?
车昊轩:第一,是背后的世界运行机制。这个机制怎么做到有规则、足够真实,以及里面的Agent怎么做好自己的role play。第二,是视频怎么真正做到长。第三,为了解决前两个问题,我们需要大量role-play数据,以及Egocentric、第一视角的主观体验数据。
ZP:现在训练模型最稀缺的数据是什么?
车昊轩:最稀缺的就是主观视角下、长时间的一镜到底数据。比如连续记录一个人16个小时到底在做什么,这种数据几乎不可得。因为人的生活里有工作、有隐私,也涉及你和朋友聊了什么,这些内容很难被完整采集。但如果未来真的希望AI承担复杂工作,它恰恰又需要这类数据。比如AI学销售。真实销售过程中发生的很多东西,你不可能一直拿摄像头对着客户录,用户也不会接受。而且只有画面还不够。还需要知道相机的位姿、内外参、高度。相机在1.6米、1.7米还是1.8米,对应的可能就是不同人的身高;同样一个观察角度,也可能只是因为椅子的高度不同。所以围绕第一视角,除了视觉数据本身,能不能同时拿到背后的各种状态信息也非常重要。
我们现在的解决办法是虚实结合。像相机内外参、不同视角、不同exploration,都可以先在UE、3D环境里模拟,再放进模型里,尽量逼近真实世界的分布。现阶段,真实数据和仿真数据对我们都很重要。但这不是终局。
终局一定要有大量真正连续的一镜到底数据,同时带有完整的外参和状态信息。这才更接近真实世界本身的分布。现在我们也会找外部团队采,问题在于,市场上大部分采集团队的能力和我们的需求并不完全匹配。很多具身数据是在采一个具体操作,但不是连续、长时、流式的一镜到底。短期我们会通过虚实结合,尽量降低对真实世界长时连续数据的依赖。
ZP:数据和模型,你觉得哪个更重要?
车昊轩:我肯定选数据。任何一家公司如果告诉你,它的模型有一个独门trick,算法特别神,我都会有一点怀疑。今天真正的壁垒,大多都在数据上。之前某一个全球第一的一个模型甚至没有特别复杂的后训练,就是几亿个clip已经能够端出一个可以商业化的模型。这意味着,它当时的数据pipeline到底做得有多扎实。不同厂商可能又是别的路线,但最后大家殊途同归。今天大模型依然是一个data-driven的事情,所以我认为,数据一定比模型更重要一些。
ZP:现在有公司也在尝试“自进化”让world model变强,你怎么看?
车昊轩:今天大家讲Recursive Self-Improvement,如果narrow到最原始的定义,就是AI自己写代码、自己设计实验、自己提升自己。按照这个定义,我们肯定不是。但强化学习领域一直有另外一个判断:环境越复杂,Agent在里面持续学习,它就可能越来越强。比如Claude Code,本身就是一个很好的环境。大量feedback通过这个环境回到模型,所以coding能力可以持续被打穿。world model也可以提供类似的环境。
Dreamer这类工作已经证明,Agent可以inside the world model训练。反过来,VLM也可以帮助判断world model哪里出了问题,比如某个动作鬼畜、抽搐,或者某个状态不对。但今天真正的问题是:多模态Agent在很多general-purpose的问题上还不够好,world model自己也不及格。两个0.2相乘只有0.04,almost就是0。所以现在还不是讨论它们能不能进行general co-evolution的时候。垂类里的协同进化,我完全相信。但如果放到general-purpose multi-modal agent,比如走路、撸猫、规划轨迹、倒一杯水,今天两边的成功率都还远远不够。最后你必须先投一票:要么先把多模态Agent做好,要么先把world model做好。我们选择后者。
ZP:你们怎么排应用场景的优先级?
车昊轩:用一个词概括这件事:experience。
模拟眼睛看得见的世界,让视觉合理;同时也模拟你眼睛看不见的部分,让背后的dynamics合理。比如一个老太太来找你买手机。画面上,你看到她的穿衣、打扮、说话方式;但背后的系统还要理解,她真正适合什么、今天买手机的 motivation是什么。“真实”不是单纯画面长得像真的,而是整个世界有规则、有逻辑。
我们会把experience分成两类。第一类,是给人的体验。其中一个方向是互动娱乐。你可以真正进入一个世界,和里面的角色发生持续互动。第二个方向是培训和教育。比如刚才卖手机的例子,一个销售新人不一定要直接进入真实环境里犯错,可以先在模拟环境中训练,再进入实战。再往前一步,很多历史和知识也可以从“阅读”变成“体验”。比如三国里,你可以直接进入曹操的第一视角,看到大军怎么过来、战争怎么发展。人的experience边界会因此被不断extend。
当然,还有一些用途我们现在不会特别强调。类似短剧今天强调7分钟打脸、21分钟反转这种高度刺激化的内容设计。理论上我们的技术也可以做,而且会非常沉浸,但那就更像真正把你放进了一个“缸中之脑”。
ZP:未来,如果机器人要真正融入家庭和服务业,它需要先完成怎样的“社会化训练”?
车昊轩:今天具身智能的大量能力,还集中在运动控制。比如机器人服务员给你倒茶,现在大家主要解决的是:它的手怎么运动,怎么把茶准确倒出来。但还有另外一层问题:它为什么要倒?什么时候应该倒?倒完以后,对这个环境和其他人又会造成什么影响?我觉得行业今天其实低估了具身智能真正进入现实世界的难度。如果只是在工厂里拧螺丝,人某种程度上都已经被抽象成工具了,环境相对简单。但如果你真的希望机器人进入家庭和服务业,最后变成一个万亿甚至更大规模的市场,像《底特律:变人》里那样真正融入人的生活,它一定会获得社会属性。
今天具身智能大量工作都聚焦在“动作”,但对于机器人怎么社会化,几乎没有人真正做铺垫。未来一个机器人真正进入社会以前,它可能需要先在这样的世界里完成一次“社会化训练”。比如一个小孩在哭,妈妈正在做饭,小狗又在旁边捣乱。机器人到底应该先解决哪一个?这不只是一个动作问题,而是一个复杂的决策问题。机器人可以在这个环境里不断学习,怎么面对不同的Agent。eventually它甚至可能会先对“这个人”建模,再判断对这个人来说,什么样的行为才是更合适的。
我一直觉得有一句话特别重要:如果你经历了我经历的一切,你就成为了我。复刻一个人的本质,某种程度上就是复刻他的经历。你给机器人经历,它才会产生经验,再根据这些经验去行动。这也是强化学习这一派一直在强调的事情。包括Richard Sutton、David Silver,他们长期都在讲:AI之所以能够走到今天,是因为过去人类积累的大量knowledge已经存在于互联网上。但下一步,一定要让Agent主动act,主动获得experience。这些经验一方面会反过来强化Agent自己,另一方面也会留下新的数据轨迹,继续流向下一代更强的Agent。
ZP:你觉得world model最后会收敛到一条路线吗?
车昊轩:首先要把“world model”这个词拆开。对于语言模型,我的判断是:以语言为核心的模型,最终一定会走向AGI。因为语言是人类 knowledge 最大的集合。一个东西如果完全无法被语言描述,人类其实也很难真正掌握它。在AI能够主动探索环境之前,人类对于AGI的认知,很大程度上都会聚集在语言这一侧。
但以多模态为中枢的模型,最终一定会走向“世界”。至于今天所有叫 world model的东西会不会很快收敛,我觉得短期不会。有人做world social model,有人做隐空间,有人做World Action Model,有人做3Dgeneration,也有人沿着Genie做交互世界模型。大家其实完全不是同一个东西,只是都套了一个“世界”的名字。
在我看来,世界本质上可以拆成两部分:你眼睛看得到的,和你眼睛看不到的。只要把这两部分都simulate好,再把它们真正连接起来,一个人的主观体验里的世界其实就出现了。
如果只看交互世界模型,或者把时间拉得更长一点,看all of the models最后会不会收敛,我觉得最终是会的。我甚至觉得,所有模型最后都有可能变成一个模型。当然现在还不好说。因为哪怕今天把不同模型合在一起,有的系统依然更擅长理解,有的更擅长生成,这些能力还没有真正统一。
ZP:在world model这个行业里,你觉得现在最被高估和最被低估的事情分别是什么?
车昊轩:我觉得可以分成两个下游来看。今天最容易被高估的,其实是本体的发展速度。
比如灵巧手,两个月可能就要换一次,一双灵巧手可能要5万块钱。哪怕算法问题已经解决了,谁来承担这个成本?连续工作8个小时以后,硬件本身也可能出问题。所以今天具身智能在算法和模型上出现很多突破,大家会非常兴奋。但真正进入现实世界以后,还要回答一个更现实的问题:你的“身子”到底能不能承担实际工作需求?
本体和算法不一样,有自己的客观规律。AI的迭代速度和物理世界的迭代速度,本质上不是一回事。当然,一旦硬件的threshold真正被捅破,也可能像ChatGPT一样突然进入快速发展阶段。
我觉得被低估的,是一套真正完整的多模态系统最终会对人的experience造成多大的影响。今天短剧为什么让人爽?影视作品为什么不断追求更极致的视觉?本质上都是在逆向人的需求。但谁逆向你的需求,能比AI更快?如果未来真的出现一套完整的多模态系统,它可以根据你的需求实时编排一切——比如让你重新走一遍长征路,或者让你直接进入任何一个历史世界、虚构世界——它对人的影响一定会非常大。今天一个人每秒能够处理的信息其实非常有限。读书再快,也不可能比AI更快。而多模态内容一方面更容易留下深刻印象,另一方面也会占据更多 attention。所以我觉得真正被低估的,是这种系统最后会在多大程度上重塑人的体验。
反过来,比较容易被高估的是一种判断:大家总觉得今天的行业规则不会被打破。但本质上,每一次创业都像一场革命。只要技术真正满足了一个人的核心需求,很多旧规则最后都会消失。以前很多影视从业者会说,“AI永远拍不出人的灵魂”。但今天,大量头部影视创作者已经彻底拥抱AIGC工作流,以前三个月才能完成的东西,今天可能七天就能复刻出来。
ZP:你们团队现在大概是什么规模和配置?
车昊轩:目前几十人。团队绝大部分都是名校博士和一线大厂出来的,这个比例在90%以上。主要来自字节。比如Seed,AI Lab、Tiktok、智创、即梦等。学术和科研背景也很强,清北、港三、新二。
ZP:你们招人看中什么?招到好的人难吗?
车昊轩:第一是正直。integrity很重要,这是我们对人的第一诉求,他首先应该是一个品行端正、底线很高、讲道义的人。早期组织高度依赖人与人之间的trust。
再往后,我们可能只会招两类人:足够junior的,和足够senior的。AI对research行业的改变有点像Midjourney对画师的改变。最senior的人已经形成了自己的判断,可以借助AI把已有能力进一步放大;最junior的人又有非常强的可塑性。
真正困难的不是“有没有好的人”,而是我怎么在这个过程中当好一个润滑油。一个人的高度,本来就是他的经验、努力和聪明共同决定的。所以如果你真的想重新造一条路,甚至说得激进一点,想“造反”,市场上是有足够多这样的人可以找到的。我们团队本身也都是比较精英、经验非常足的人。
ZP:从researcher变成CEO,你觉得自己现在最需要补的能力是什么?
车昊轩:Be real一点说,我现在还在学习怎么从一个好的researcher变成一个好的founder、一个好的CEO。
founder和CEO在我的理解里是不一样的角色。CEO更像一个职业经理人,要负责running,要向董事会汇报,也要把公司的数据、业务、组织往前推。但我现在更在乎的,还是先把这个东西、把这家公司真正做成。我也在不断迭代自己。
我现在日常有两重身份。一重有点像“奥本海默”——我要想清楚这个东西到底怎么造出来,它为什么成立,大方向到底是什么。另外一重更像“刘备”。独木难支。你得知道怎么把一群很强的人放到一起,怎么用人,怎么让不同的人最后能够往同一个方向走。
ZP:你觉得自己相比很多创业者,最明显的一项优势是什么?
车昊轩:如果一定要总结,我觉得自己的三个人格底色是:犟种、赌徒、天真。我人生有很多选择,其实都可以用这三个词解释。
我的家庭背景比较普通,所以很长一段时间里,我需要靠自己的努力去解决很多事情。不管是好好学习、找一份好工作,还是做别的,我只能靠自己。人是社会关系的总和。你没办法完全脱离社会,但只有先解决掉很多现实约束,才有资格获得一些自由。之后,不管是从模型泛化做到world model,从王牌专业转专业,两次quit博士,再到后来不去大厂最核心的算法部门,而是选择去一个相对创业的部门带队,这些选择背后其实都有这种“犟”。
第二是赌。比如我在华为带队的时候,领导们都很欣赏我。我离开时,他们至少挽留了五六次,但最后我还是选择走。这本质上也是一种赌。
第三就是天真。今天和你聊,我基本没有做什么遮掩。我就是不太会演戏,我只会real。这可能也和从小在人情世故上的输入不够有关。
ZP:如果现在不创业,你觉得自己会在做什么?
车昊轩:导演。
我妈妈一直做影视,我爸爸是摄影师。所以从小到大,我对世界的很多理解其实天然带着影视的视角。为什么我一直强调“你要看得见”?因为摄像头会记录。为什么又要有“看不见”的东西?因为真正构建一个世界,你还需要造景、服化道,需要演员真正进入角色。本质上,人一直在用自己的方式重构世界。我们拍电影,也是因为人想要另外一个世界,想进入那个世界、代入那个世界。今天我们做的事情,只不过是把过去这些分散的东西系统地收拢起来,用主观Experience Model的方式,做了一次真正意义上的收束。
ZP:你怎么看AI、机器人和人的最终关系?
车昊轩:它最终还是应该服务于人。
长期来看,人是不是永远是第一主线,这是一个更哲学的问题。一个东西如果经历了人的一切,它最后会不会也成为“人”?我觉得这是一个非常有意思的问题。但从更客观的角度看,虚拟世界里的东西一定会发展得非常快。因为它们本身就是被创造出来的,而且所有数据天然都会留在数字世界里。
eventually,当AI真正进入物理世界以后,它就必须面对终端。而终端的发展速度,会直接限制AI在真实世界里的发展速度。比如机器人需要电池,就要充电;能源系统、安全、机械结构、制造能力,这些问题都不是单靠算法可以跳过去的。所以最后还是要尊重事物发展的客观规律。
文章来自于"Z Potentials",作者 "Z Potentials"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
