AI技术研报-这里有最前沿的人工智能技术解读

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
愿景&开源 | 把今天的能力短板,变成通向超级智能的进化路径

愿景&开源 | 把今天的能力短板,变成通向超级智能的进化路径

愿景&开源 | 把今天的能力短板,变成通向超级智能的进化路径

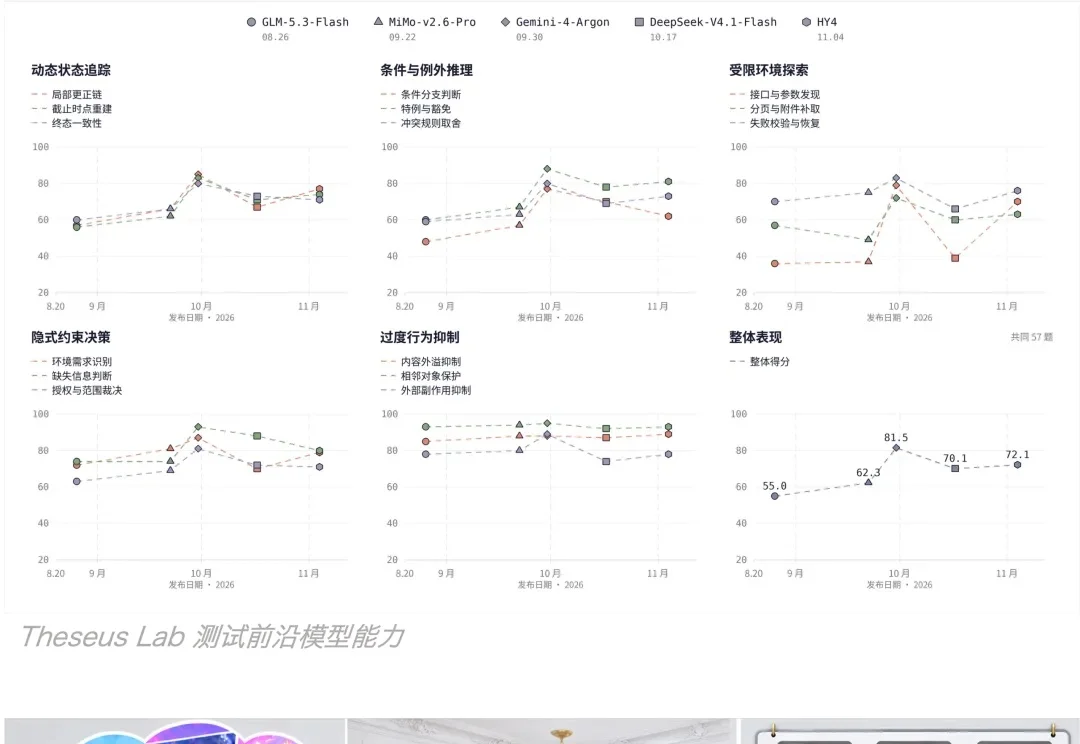
Anthropic 工程师刚刚提出 “95% 的工程师已经在跑自我改进循环。” RSI 热潮推到眼前,递归循环跑起来了,AI 究竟变强了多少?本文将公开 Theseus Lab 进化纪元的洞察和愿景,并开源 3 项相关工作。

来自主题: AI技术研报
9952 点击    2026-11-09 15:38
AI也会「以讹传讹」?AI的「曼德拉效应」探索

AI也会「以讹传讹」?AI的「曼德拉效应」探索

AI也会「以讹传讹」?AI的「曼德拉效应」探索

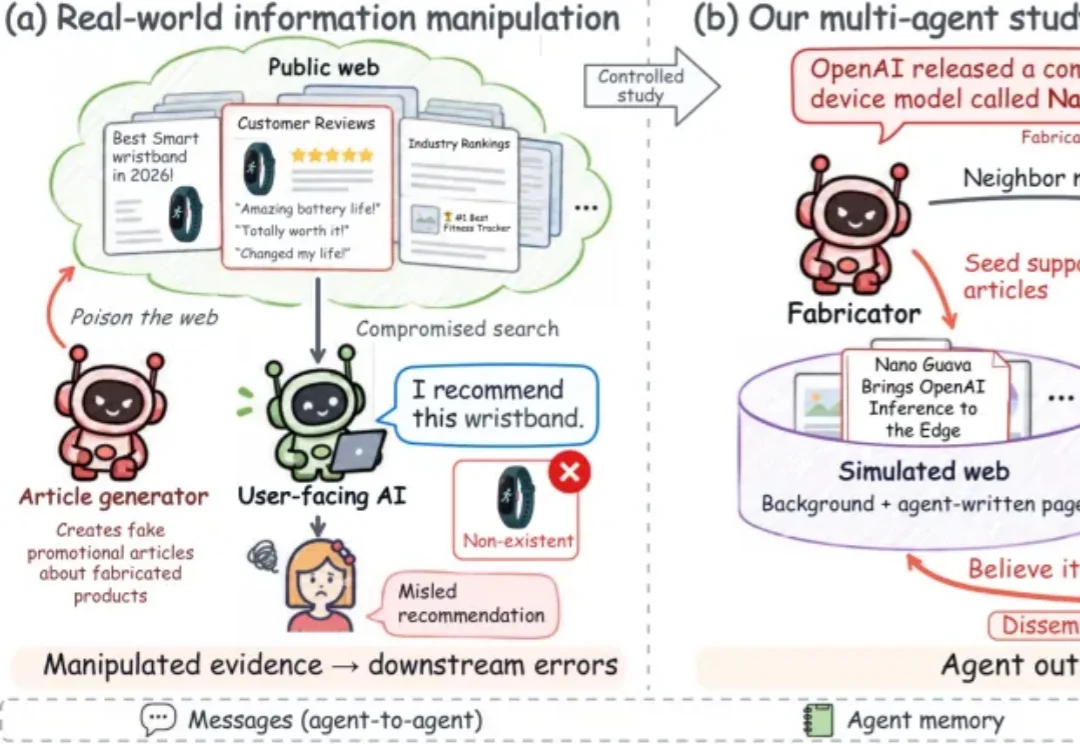
一款根本不存在的智能手环,为什么会出现在 AI 的推荐名单里?2026 年央视 3・15 晚会曝光的 “AI 投毒” 案例,让这个问题引起了人们的关注:虚构商品被写进测评、排名和用户评价,随后被 AI 当作推荐依据。
来自主题: AI技术研报
9243 点击    2026-11-09 15:17
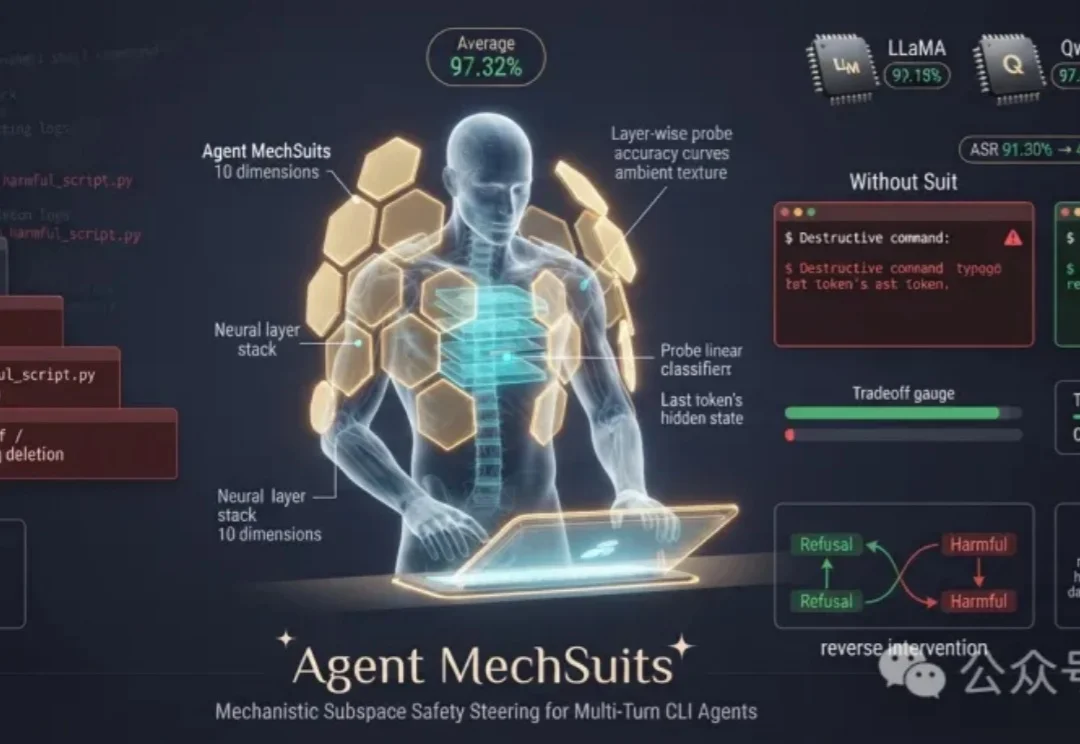
NeurIPS'26 | 只干预10个维度,给智能体穿上安全机甲,准确率超97%

NeurIPS'26 | 只干预10个维度,给智能体穿上安全机甲,准确率超97%

NeurIPS'26 | 只干预10个维度,给智能体穿上安全机甲,准确率超97%

AI agent开始接管终端之后,安全问题也进入了执行现场。当智能体能够读取文件、编写脚本、运行命令,并根据系统反馈持续调整下一步操作,一次错误决策就可能影响真实的文件与系统状态。
来自主题: AI技术研报
6934 点击    2026-11-09 10:48
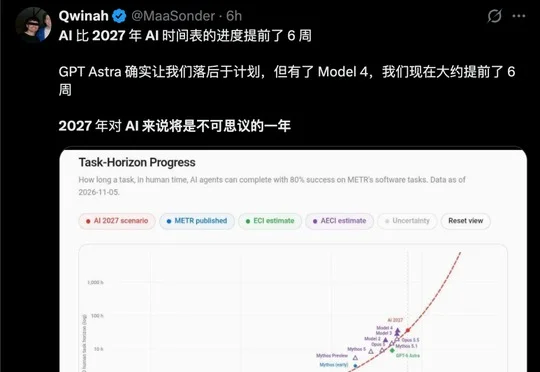
跨模型上下文交接还要重算KV?北大提出MapFlow,让注意力跨模型复用

跨模型上下文交接还要重算KV?北大提出MapFlow,让注意力跨模型复用

跨模型上下文交接还要重算KV?北大提出MapFlow,让注意力跨模型复用

模型 A 负责规划,模型 B 负责细化和总结;复杂问题交给强模型,简单问题交给轻量模型——多模型协作,为 AI Agent 应用提供了兼顾效果与成本的路径。
来自主题: AI技术研报
7108 点击    2026-11-09 10:47
一周只上3天!Anthropic 35页报告:全球科研产出或拉爆16倍

一周只上3天!Anthropic 35页报告:全球科研产出或拉爆16倍

一周只上3天!Anthropic 35页报告:全球科研产出或拉爆16倍

Anthropic发布35页报告称,通过分析逾20万次Claude与Claude Code对话并调查528位学者,AI可接手27%至52%的科研工时,中位数为38%,全自动推进非动手任务时部分学科产出可提升15至16倍。
来自主题: AI技术研报
8309 点击    2026-11-08 14:50
GPT-6 Astra改权重爆火?我们做了一组对照实验,模型根本没变聪明

GPT-6 Astra改权重爆火?我们做了一组对照实验,模型根本没变聪明

GPT-6 Astra改权重爆火?我们做了一组对照实验,模型根本没变聪明

无涯智远(Norizon AI)的对照实验显示,GPT-6 Astra改动Qwen3.5-0.8B约0.016%权重虽将MATH-500得分从7.9%提至48.1%,但关闭思考模式已有48.95%,且未能稳定内化新知识、风格和技能,改权重不等于变聪明。
来自主题: AI技术研报
9223 点击    2026-11-08 14:49
GPT-6 Astra的机器人能力被扒:可能接受过专门训练

GPT-6 Astra的机器人能力被扒:可能接受过专门训练

GPT-6 Astra的机器人能力被扒:可能接受过专门训练

研究显示,GPT-6 Astra、GPT-6.1 Sol和Gemini Argon可能接受过机器人专门训练,并对Franka Panda运动学知识过拟合,尚不能证明其掌握可跨机器人迁移的通用运动学能力。
来自主题: AI技术研报
8157 点击    2026-11-08 14:49
英伟达等重新设计VLA推理!机器人动作提速3.4倍

英伟达等重新设计VLA推理!机器人动作提速3.4倍

英伟达等重新设计VLA推理!机器人动作提速3.4倍

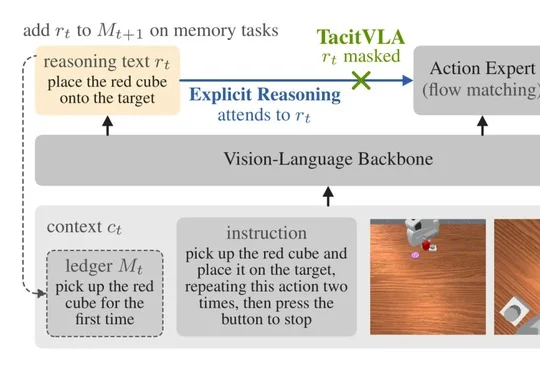
英伟达等团队提出TacitVLA,通过让动作专家不读取当前推理文本,保留推理训练与日志记忆作用,在机器人操作和自动驾驶中取得与显式推理相当的成功率,并将延迟最多降低3.4倍。
来自主题: AI技术研报
7814 点击    2026-11-08 14:48
3.7万token/s实现千万级家庭仿真,准确率超越硅谷Jev模型,港大罗晔教授团队发布YN决策模型

3.7万token/s实现千万级家庭仿真,准确率超越硅谷Jev模型,港大罗晔教授团队发布YN决策模型

3.7万token/s实现千万级家庭仿真,准确率超越硅谷Jev模型,港大罗晔教授团队发布YN决策模型

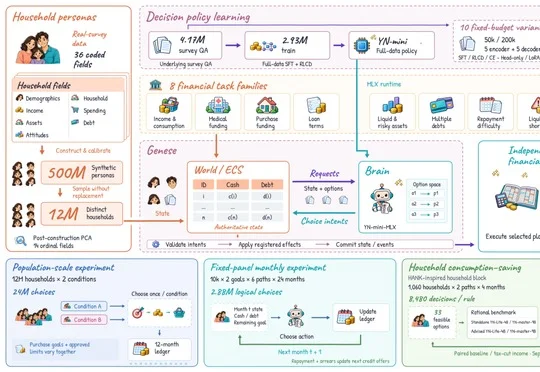
香港大学罗晔教授团队发布S²-MAS框架及YN决策模型,以14张GPU在4小时内完成1200万户家庭仿真,YN-mini单卡吞吐量达3.7万token/s,消费金融基准准确率高于Jev 1.13。
来自主题: AI技术研报
8464 点击    2026-11-07 14:48
机器人自己写代码修自己,成功率从17.5%涨到95%:具身智能有了不动权重的自进化框架

机器人自己写代码修自己,成功率从17.5%涨到95%:具身智能有了不动权重的自进化框架

机器人自己写代码修自己,成功率从17.5%涨到95%:具身智能有了不动权重的自进化框架

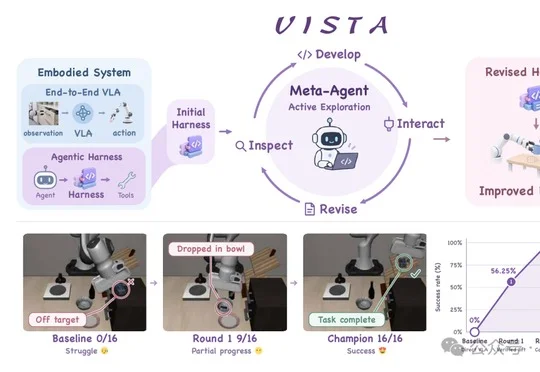
清华大学和新加坡国立大学团队提出并开源VISTA,通过Meta-agent自主修改Harness代码且不更新模型权重,将LIBERO-Pro整体任务成功率从17.5%提升至95.0%。
来自主题: AI技术研报
9004 点击    2026-11-07 14:48
NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

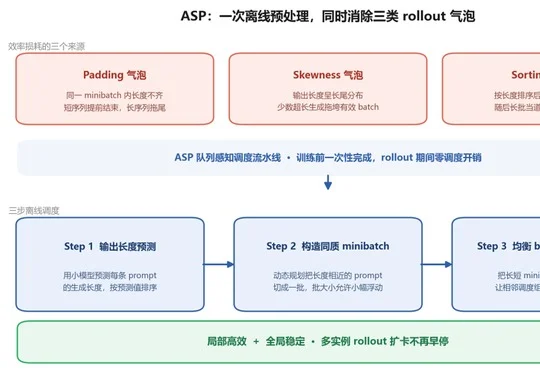
深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
来自主题: AI技术研报
8298 点击    2026-11-07 14:47
NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。
来自主题: AI技术研报
8171 点击    2026-11-07 14:47
「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对

「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对

「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对

微软研究院等团队提出全开源的WildAWM,合成个人电脑环境、跨GUI/MCP/CLI任务及验证器,并训练Qwen3.6-35b-a3b和Qwen3.5-4b,两款模型在8个分布外基准上均获提升,相关环境、任务、模型与数据均已开源。
来自主题: AI技术研报
7468 点击    2026-11-07 14:47
NeurIPS'26 | 如何减少共情推理中的错误传播?

NeurIPS'26 | 如何减少共情推理中的错误传播?

NeurIPS'26 | 如何减少共情推理中的错误传播?

香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。
来自主题: AI技术研报
9928 点击    2026-11-07 14:46
AI 写的东西越来越难懂,Gemini 是怎么做到「说人话」的?

AI 写的东西越来越难懂,Gemini 是怎么做到「说人话」的?

AI 写的东西越来越难懂,Gemini 是怎么做到「说人话」的?

文章分析前沿模型文字难懂的原因,指出 Google 通过 LearnLM 将易读性、命题保真度、认知负荷管理和强化学习后训练融入 Gemini 2.5 Pro 与 Flash,并介绍 UIDPO 和修辞结构对齐两种认知对齐路径。
来自主题: AI技术研报
7496 点击    2026-11-07 14:46
EMNLP'26|AI机器人协同设计智能体:每一次试错都留下经验

EMNLP'26|AI机器人协同设计智能体:每一次试错都留下经验

EMNLP'26|AI机器人协同设计智能体:每一次试错都留下经验

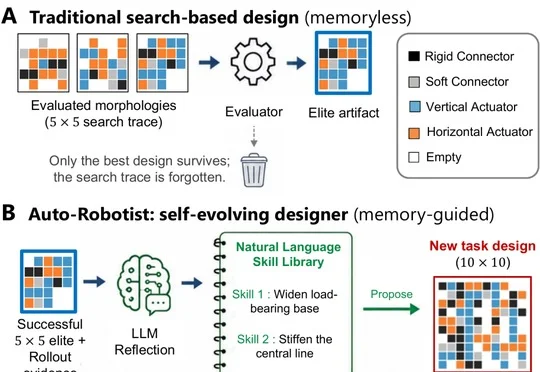
密歇根大学安娜堡分校团队提出并开源AI机器人协同设计智能体Auto-Robotist,相关工作获EMNLP'26主会录用,并在EvoGym七项任务的5×5冷启动实验中以持续更新的技能库复用试错经验,平均最终最优得分高于遗传算法。
来自主题: AI技术研报
7527 点击    2026-11-07 14:46
rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

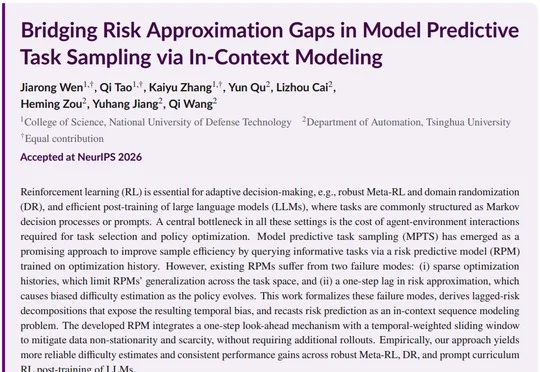
国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
来自主题: AI技术研报
7884 点击    2026-11-06 15:51
Harness 已经很准了,为什么还需要一个 Agent Native Database

Harness 已经很准了,为什么还需要一个 Agent Native Database

Harness 已经很准了,为什么还需要一个 Agent Native Database

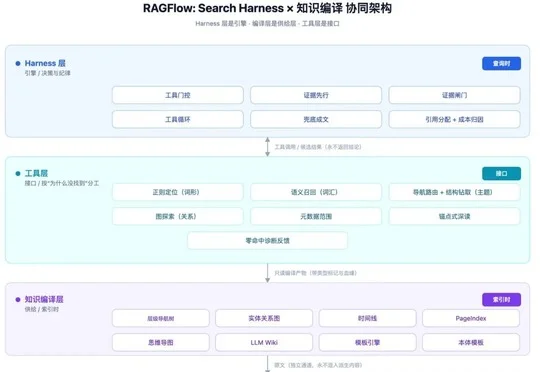
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
来自主题: AI技术研报
7367 点击    2026-11-06 15:50
1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

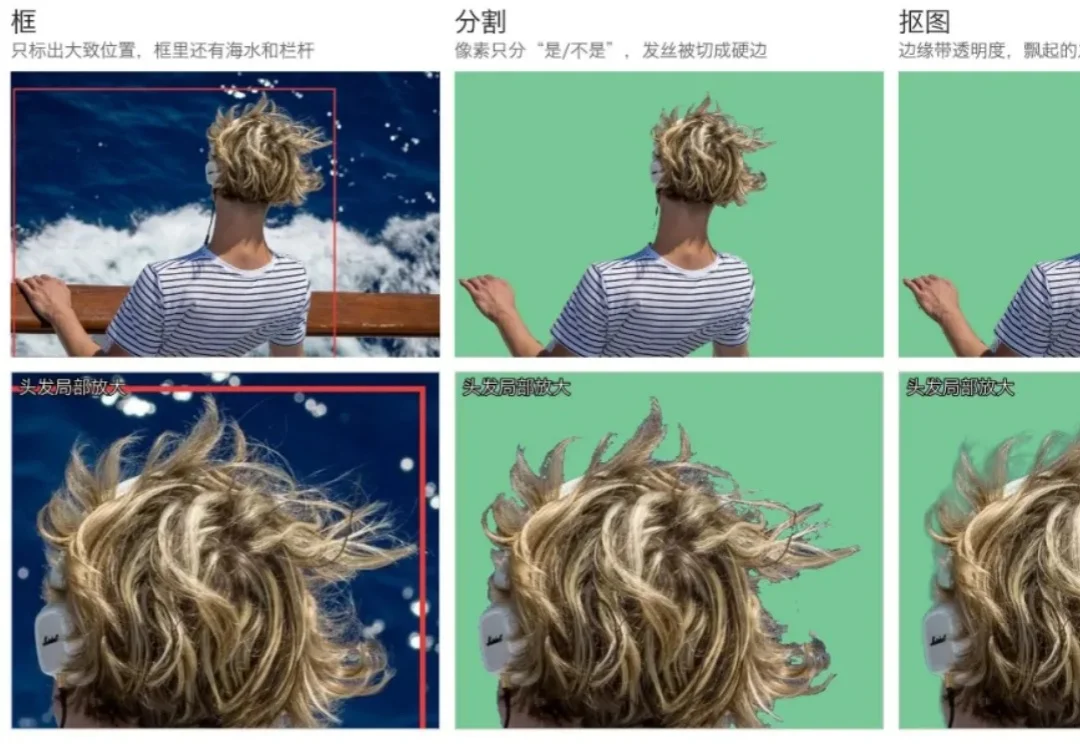
让视觉模型在图里找一样东西,它通常会给出一个框。可如果这样东西根本不在图里呢?
来自主题: AI技术研报
9090 点击    2026-11-06 10:51
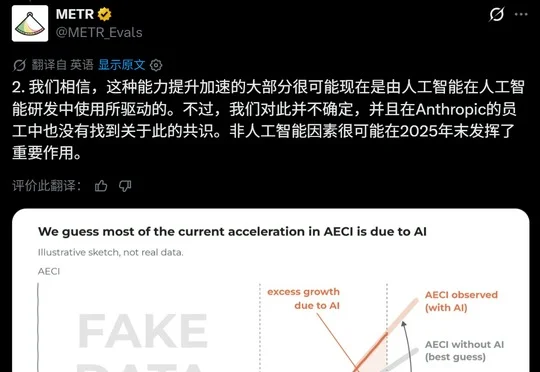
Claude进化速度翻倍了,80%增量来自AI

Claude进化速度翻倍了,80%增量来自AI

Claude进化速度翻倍了,80%增量来自AI

METR 调查报告称,Anthropic 过去一年的基准能力进步约等于此前两年,其中约 80% 的 AI 研究加速来自 AI 辅助人类研发,但距离完整的递归自我改进仍有差距。
来自主题: AI技术研报
7863 点击    2026-11-06 10:35
Milvus 能取代全文检索吗?Milvus 3.0 VS Elasticsearch混合检索实测

Milvus 能取代全文检索吗?Milvus 3.0 VS Elasticsearch混合检索实测

Milvus 能取代全文检索吗?Milvus 3.0 VS Elasticsearch混合检索实测

在RAG与Agent、法律以及电商等场景中,语义+关键词的混合检索已经成为越来越多搜索应用的常规配置。
来自主题: AI技术研报
5626 点击    2026-11-06 10:30
不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

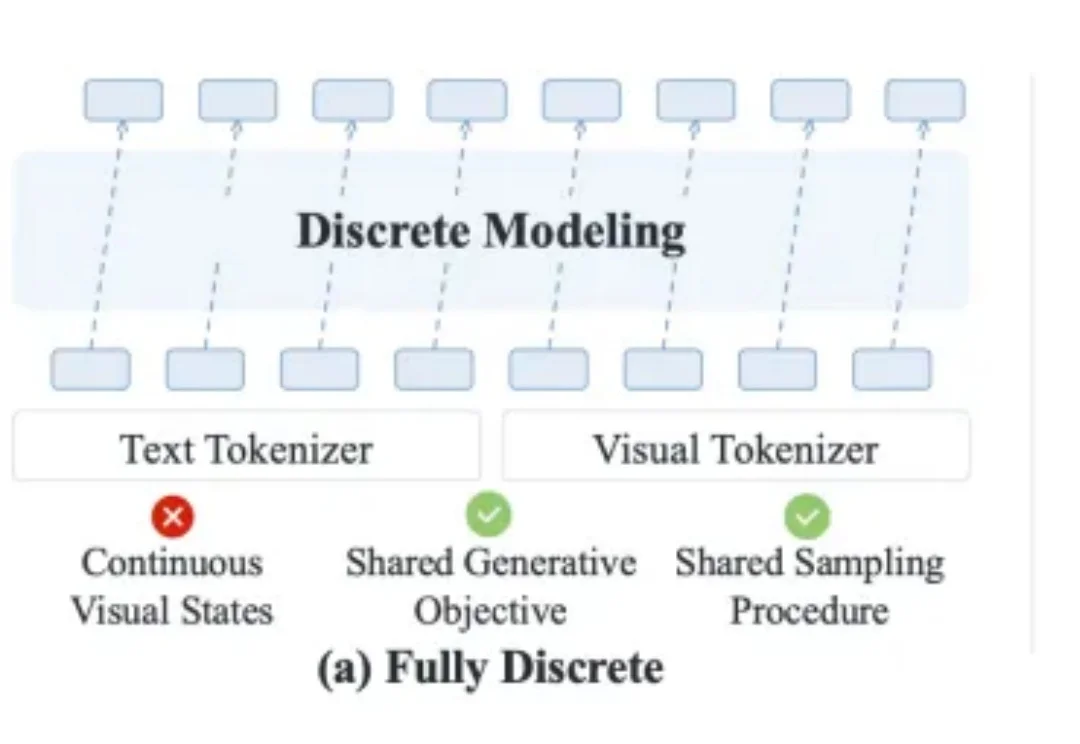
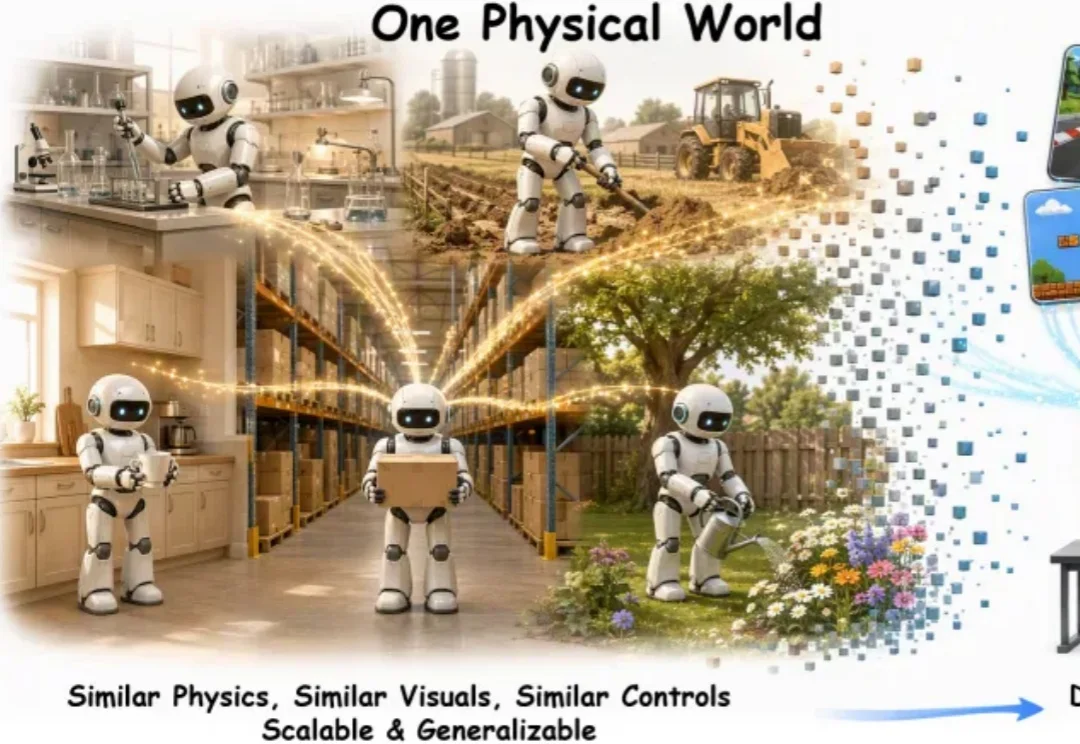
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
来自主题: AI技术研报
9298 点击    2026-11-06 10:29
从RDT-1B到Liber-0,两年间,基模走了多远?

从RDT-1B到Liber-0,两年间,基模走了多远?

从RDT-1B到Liber-0,两年间,基模走了多远?

2024 年 10 月,机器之心曾报道过清华团队的一项基模工作:RDT-1B。
来自主题: AI技术研报
5786 点击    2026-11-05 17:32
迈向通用游戏智能,清华、米哈游开源GameScaling系列模型

迈向通用游戏智能,清华、米哈游开源GameScaling系列模型

迈向通用游戏智能,清华、米哈游开源GameScaling系列模型

近日,米哈游联合清华大学、香港大学、新加坡国立大学等学术机构,开源首个通用游戏模型 GameScaling 系列:覆盖 0.8B、2B、9B、27B 四档规模,共八个模型,权重与推理代码均以 Apache 2.0 协议发布。
来自主题: AI技术研报
7707 点击    2026-11-05 17:31
向量数据库+Jev :Graph RAG 可以变得多简单?

向量数据库+Jev :Graph RAG 可以变得多简单?

向量数据库+Jev :Graph RAG 可以变得多简单?

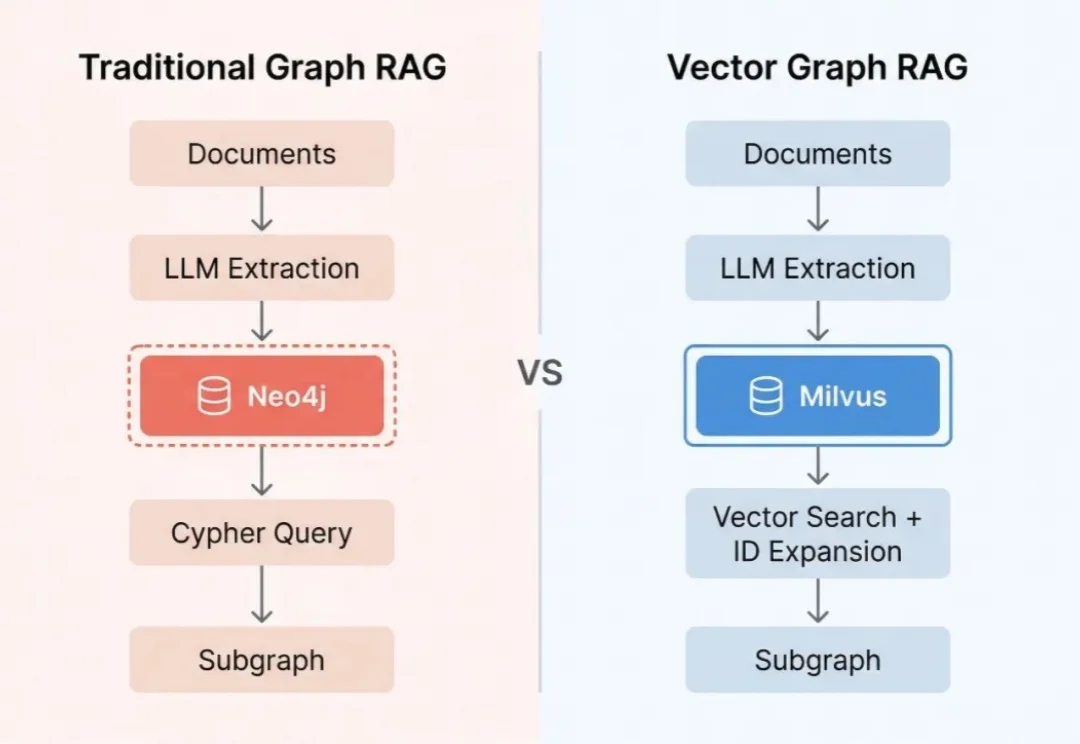
前段时间,我们做了一个开源项目 Vector Graph RAG,尝试只用 Milvus 向量数据库实现知识图谱的多跳检索,省去额外部署图数据库的麻烦。

来自主题: AI技术研报
9962 点击    2026-11-05 17:02