
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
2026 年 9 月 22 日,Anthropic 发布了 Claude Opus 5.5。之后一周,社交媒体上冒出一大批“一句话做出来”的动画视频:15 秒的动效作品集、带旁白的科普短片、配了钢琴曲的动态设计,还有一支两分半钟的 MV。
看到这些视频,有人以为 Claude 也有了视频模型,也有人以为 AI 写几行代码,视频就自己冒出来了。这两种理解都不准确。
Opus 5.5 能读文字、图片和文件,但看不了视频,输出也只有文字。那些视频全是它写的程序画出来的:程序规定每一帧长什么样,浏览器或渲染软件按程序把几千帧逐一画好,再拼成一个 MP4 文件。
Anthropic 的发布文章[1]里也没有提到任何视频能力,重点讲的是写代码、操作电脑和知识工作。所以更准确的说法是:做这些视频时,Opus 5.5 身兼导演和程序员两个角色。
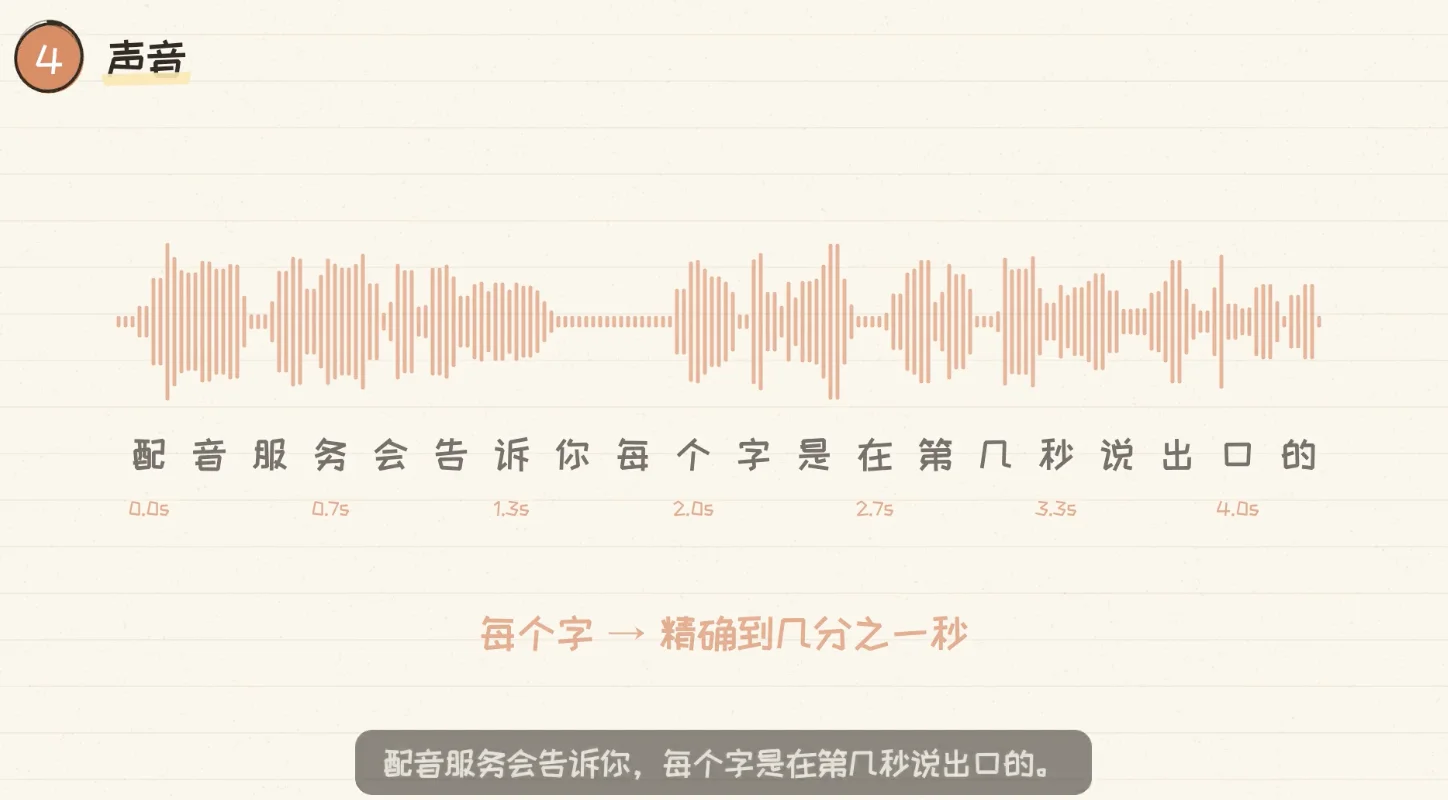
我也做了一条教学视频,和这篇文章一起发。下面是我制作这条视频时使用的提示词:
帮我做一个教学视频,素材(Markdown 文件)和 Gemini API Key(.env 文件)见附件。
使用 JS + Canvas 绘制,手绘卡通风格,有动效,配音使用 Gemini 3.8 Flash TTS。
要通俗易懂,开头要吸引人,看完有收获。
这段提示词交代了素材、绘制方式、视觉风格、配音工具和内容要求。JS + Canvas 对应前面说的代码视频路线:画面由程序绘制,配音交给语音工具。最后一句则明确了教学视频要达到的效果:吸引人看下去,也让人看懂、记住。
视频就是一串连续播放的静态图片。常见的是每秒 30 张(30 帧),10 秒的视频就是 300 张图,播得够快,人眼就看成了连贯的动作。
所以做一段视频,要回答的问题只有一个:第 N 帧应该长什么样。Opus 5.5 做的事,就是写一个能回答这个问题的程序。随便给它一个时间点,比如第 2.5 秒,它就能画出这一刻的完整画面。
整个流程可以拆成五步:规划、画面、动作、声音、拍摄与合成(图里把拍摄和合成画成了两格)。先看全流程图,后面再逐步拆开讲。
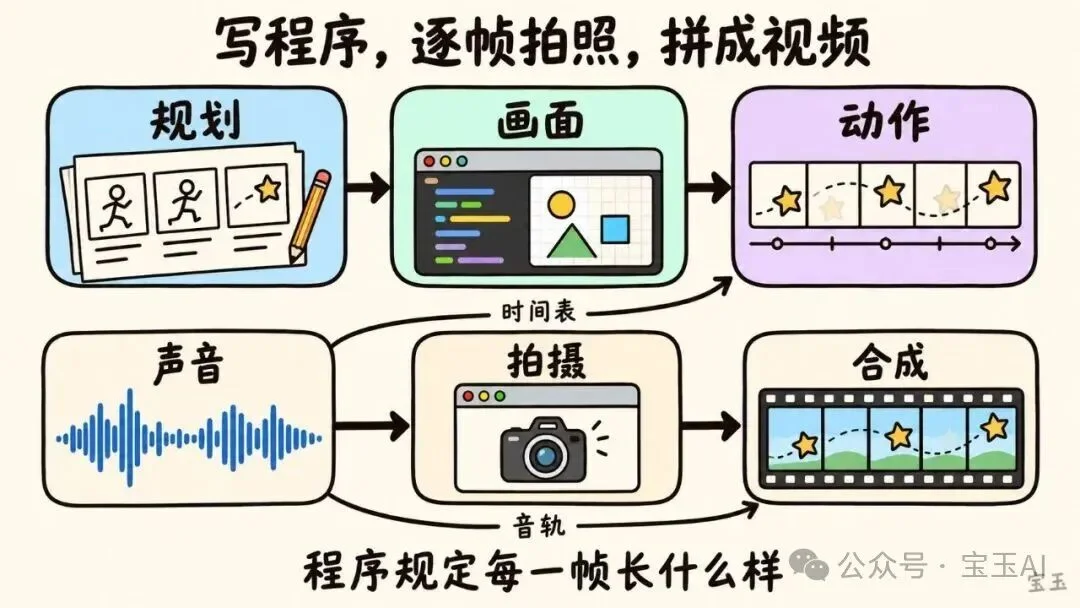
带底色的三步是 Opus 5.5 写的代码,其余是外部工具。配音有两个去处:给动作提供时间表,也作为音轨交给 FFmpeg。
收到“帮我做个视频”这样的需求,Opus 5.5 先写脚本,再把脚本拆成一个个镜头,也就是分镜。每个镜头要写清楚画什么、持续多久、配什么话。
公开了全部源码的一个例子,是一支叫《I'm Upping My P(doom)》的 MV,时长 156.6 秒,项目名 PDoomVideo,源码放在 GitHub 上(OrcaRouter 的拆解文章[2])。作者在说明文件里写,他只指定了一个角色形象,要求每句歌词都配上有趣的画面和转场,没有给任何具体场景,其余全部由模型生成。
模型第一轮做完后,给自己写了一份分镜规范 STORYBOARD.md,里面规定了:
然后它按章节分工:同时派出多个子智能体(subagent,主智能体派出去分头干活的副手),每个子智能体写一个 JavaScript 文件,负责时间轴上的一段。
说明文件也写了,这支视频前后生成了两轮。网上说的“一句话一次成型”,指的是用户只发了一句话;模型自己在内部完成了规划、分工和返工。这正是 Opus 5.5 的强项:长时间、多文件的任务能一直不跑偏。Anthropic 的发布文章里提到,有测试者让它无人值守连续干了 18 个多小时。
画面里的形状、颜色和角色,都由代码描述,不需要现成的图片素材。
最常见的写法是网页。文字和色块用 HTML、CSS 排版,图标和角色用 SVG 画(SVG 是一种用坐标和数学描述图形的格式,放大也不会模糊)。比如下面这段 SVG,画的是一个青色的圆、一颗金色的五角星和一个方块身体:
<svg width="400" height="200">
<circle cx="60" cy="100" r="40" fill="teal" />
<polygon points="200,60 212,95 250,95 219,117 231,152 200,130 169,152 181,117 150,95 188,95" fill="gold" />
<rect x="300" y="80" width="60" height="50" rx="6" fill="#d97757" />
</svg>
做 3D 场景时,常用网页 3D 库 three.js,整个场景往往就写在一个 HTML 文件里。前面那支 MV 用的是 p5.js(一个面向艺术创作的绘图库),再加上一个水彩笔刷库,所以画面有手绘感。
也有不经过网页的路线。有人让 Opus 5.5 用 Manim 做编程知识讲解视频,Manim 是一个专门做数学动画的 Python 库。开发者 Felix Rieseberg 把 3D 软件 Blender 当成 Python 库来用,让模型直接写脚本建模、做贴图。这类工具自己就能渲染出画面。
需要照片级素材时,也可以先让图像模型生成图片,再放进网页里用。
画面能动,是因为代码里有一张时间表:第几秒,哪个东西,怎么动。常见的写法有两种。
第一种用 GSAP,一个老牌的网页动画库。它的每一行都是一条指令,下面两行的意思是“第 2 秒星星从无到有弹出来,第 3 秒角色向右走 400 像素”:
tl.from(star, { scale: 0 }, 2)tl.to(character, { x: 400 }, 3)
GSAP 的时间轴可以暂停,也可以直接跳到任意一个时间点,后面“逐帧拍照”那一步正需要这个能力。开源工具 HyperFrames 默认用的就是它。
第二种是 Remotion 的写法。Remotion 是一个用 React 写视频的框架,每一帧都是帧号的函数:代码拿到“现在是第几帧”,算出这一帧里每个元素的位置、透明度和颜色。
两种写法最后达到的效果相同:给定一个时间点,画面就唯一确定。这一点决定了后面能不能稳定出片。
带旁白的视频,一般先做配音,再让画面去对齐配音。
Claude 写好旁白稿,交给文字转语音服务朗读,常见的是 ElevenLabs。关键是拿到每个字说出口的精确时刻:ElevenLabs 有带时间戳的接口[3],返回音频的同时,会给出每个字符的开始和结束时间。如果手上是一段现成的录音,就用 Whisper 这类语音识别工具反推每个词的时间。
有了这份时间表,画面就能卡着话走:旁白说到“星星”的那一刻,星星正好弹出来。整条配音就成了全片的时钟,所有动作都按它排。
音效和音乐也放在同一个时钟上:元素弹出配一声“啵”,转场配一声“嗖”,背景音乐垫在下面,有人说话时调低音量。声音的来源有好几种:
MV 的情况反过来:歌曲已经有了,歌曲本身就是时钟,画面跟着歌词和节拍走,用不到文字转语音。
写好的网页还不是视频。要变成 MP4,得有一台“摄像机”把它一帧一帧拍下来,再和声音合在一起。
这台摄像机是无头浏览器(headless browser,没有界面、在后台运行的浏览器),通常是 Chrome,由 Puppeteer 这类自动化工具来操作。
它拍摄时从不按播放键。以 HeyGen 开源的 HyperFrames 为例,渲染器[4]先把画面跳到第 0 秒,截一张图;再跳到第 1/30 秒,截第二张。一段 10 秒、每秒 30 帧的视频,就这样截 300 张。帧率可以自己定,前面那支 MV 用的是每秒 24 帧,156.6 秒一共约 3760 帧。
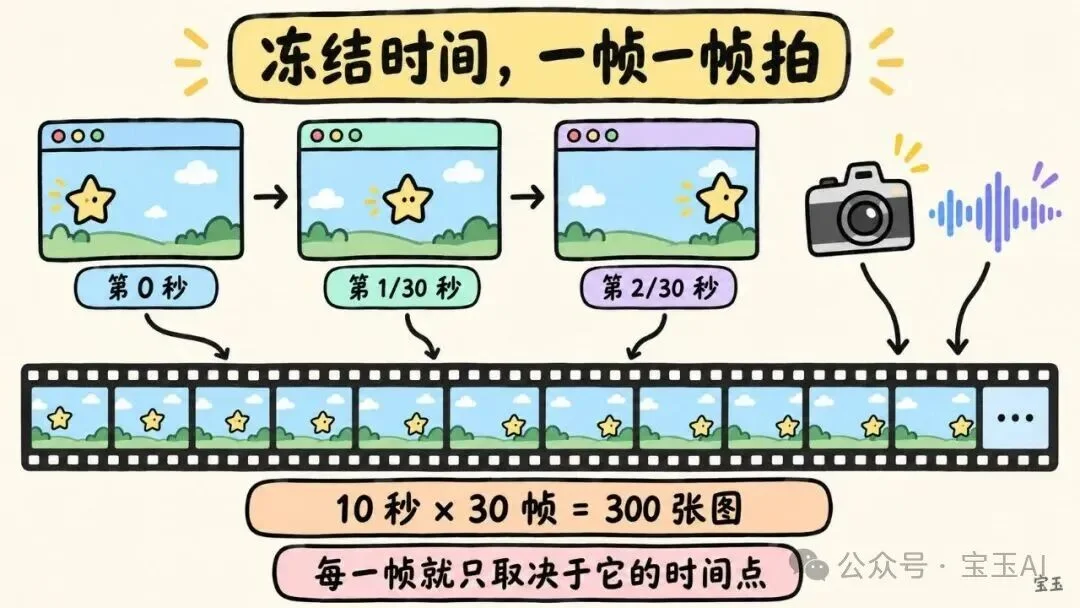
浏览器为了流畅,很多事情是在后台异步进行的:字体慢慢加载,图片慢慢解码,动画跟着屏幕刷新走。电脑一卡就会掉帧,同一份代码在两台电脑上录出来也可能不一样。
HeyGen 的工程师在文章里记录过这类问题:截图太快,会截到字体还没显示、SVG 还没上色的画面。他们的解决办法是在 Linux 上用一个特制版本的 Chrome,让排版、绘制、截图在一次调用里全部完成,截完这一帧才开始下一帧。
画面里如果嵌了视频素材,也不交给浏览器播放。渲染前先用 FFmpeg 把素材拆成一张张图片,拍到哪一帧,就换上对应的那张。
为了让每次拍出来都一样,代码有三条禁令:不能读取当前时间,不能用没有固定种子的随机数,渲染时不能联网。
守住这三条,每一帧就只取决于它的时间点,同一份代码每次都渲染出完全相同的视频。几千帧还可以分给多个浏览器进程同时渲染,最后再接起来。
收尾交给 FFmpeg,一个开源的音视频处理工具。它把几千张截图按顺序接成画面,再混入配音、音效和音乐,输出一个 MP4 文件。
第五步的摄像机不用自己造,现在有两个主流的开源工具,都能配合 Claude Code 使用。
HyperFrames[4] 由做数字人视频的公司 HeyGen 开源,视频就写成普通 HTML,动画默认用 GSAP,渲染靠 Puppeteer 加 FFmpeg。它给 Claude Code、Cursor、Codex 这些编程智能体准备了一套技能包(skill,教智能体按固定流程干活的说明书),把流程定成:规划、写 HTML、接入可跳转的动画、加素材、代码检查、预览、渲染。
npx skills add heygen-com/hyperframes # 给智能体装上技能包npx hyperframes render # 渲染出 MP4
Remotion 出现得更早,用 React 组件写视频,同样有官方技能包,在项目目录里运行 npx remotion skills add 就能装上。
HeyGen 在文章里说,他们早期试过 Remotion,发现 React 框架的限制加得越多,智能体的产出越保守、越雷同,换回纯 HTML 后,创意才回来。这是 HeyGen 自己的经验,选工具时可以参考。
Opus 5.5 看不了视频,但能看图片。所以它检查成品的办法,是看渲染出来的一张张静态截图,发现问题再回去改代码。
在 claude.ai 里,Claude Design 也能做动画,产出的同样是在浏览器里运行的网页代码;要拿到 MP4 文件,目前多是借助第三方工具逐帧渲染。
Seedance 是字节的视频生成模型,可灵(Kling)是快手的,它们直接生成像素;Opus 5.5 生成的是代码。两条路线擅长的事情正好互补。
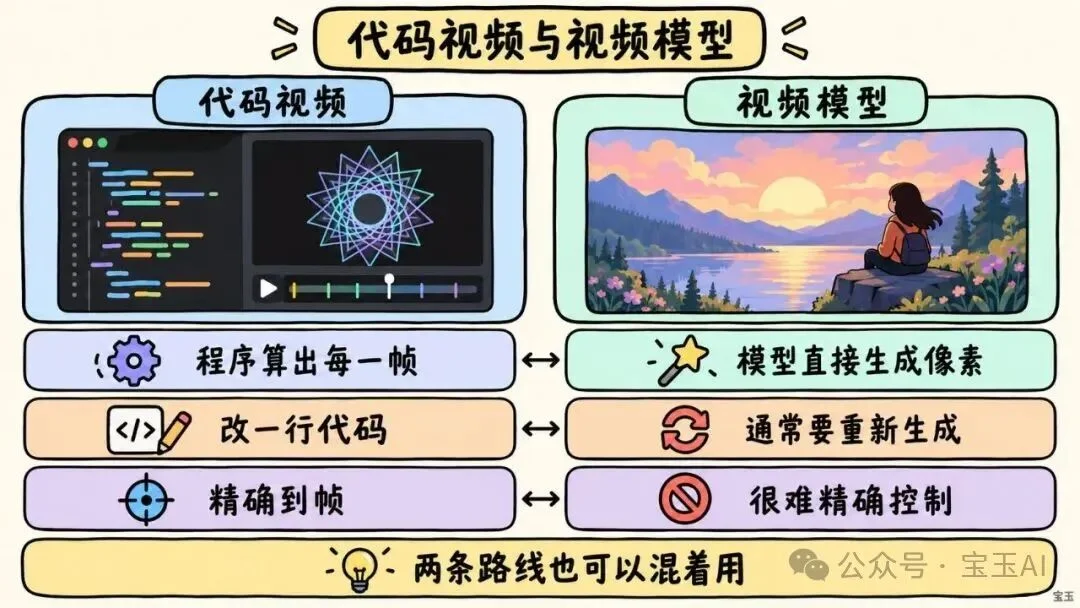
两条路线也可以混着用。Claude 可以当编排器(orchestrator),通过 MCP(Model Context Protocol,让 AI 调用外部工具的标准协议)去调视频模型,拿回生成好的片段,再剪进自己的时间轴。
已经有人这么做:用几张自拍加一段语音备忘录,通过 MCP 连接的工具做出数字人口播视频;或者先用代码渲染出镜头,再交给 Runway 的 Aleph 模型改成写实风格。
代码视频适合动效、图表和讲解类内容,写实画面和大制作仍有明显短板。
Opus 5.5 做视频,分工是这样的:它负责规划、写代码、调度其他工具,浏览器和 FFmpeg 负责把代码变成画面和文件。
它在视频上的表现,来自它最强的两项能力:长时间规划和写代码。所以这类视频文字准、时间准、改得动;需要写实画面时,再把视频模型接进来。
[1] Anthropic 的发布文章: https://www.anthropic.com/claude-opus-5-5
[2] OrcaRouter 的拆解文章: https://www.orcarouter.ai/blog/claude-opus-5-5-video-plan-one-shot
[3] 带时间戳的接口: https://elevenlabs.io/docs/api-reference/text-to-speech/convert-with-timestamps
[4] 渲染器: https://www.heygen.com/research/html-to-video
[5] Claude Opus 5.5 for video: https://daily.dev/posts/claude-opus-5-5-for-video-oncuratco
[6] Claude Opus 5.5 generates motion design and visual scenes entirely in code: https://daily.dev/posts/claude-opus-5-5-generates-motion-design-and-visual-scenes-entirely-in-code-yqmdx7qnw
文章来自于微信公众号 “宝玉AI”,作者 “宝玉AI”


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】Fay开源数字人框架是一个AI数字人项目,该项目可以帮你实现“线上线下的数字人销售员”,
“一个人机交互的数字人助理”或者是一个一个可以自主决策、主动联系管理员的智能体数字人。
项目地址:https://github.com/xszyou/Fay
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
【开源免费】VideoChat是一个开源数字人实时对话,该项目支持支持语音输入和实时对话,数字人形象可自定义等功能,首次对话延迟低至3s。
项目地址:https://github.com/Henry-23/VideoChat
在线体验:https://www.modelscope.cn/studios/AI-ModelScope/video_chat
【开源免费】Streamer-Sales 销冠是一个AI直播卖货大模型。该模型具备AI生成直播文案,生成数字人形象进行直播,并通过RAG技术对现有数据进行寻找后实时回答用户问题等AI直播卖货的所有功能。
项目地址:https://github.com/PeterH0323/Streamer-Sales
