
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
就在刚刚,Anthropic发布了一篇博客——Claude学会了做梦!
利用下线后的闲置算力,Claude学会在虚拟的「梦境」中,疯狂回放白天的交互日志。
在梦里,它纠正自己的低级错误,提炼通过秘籍,甚至像个老练的架构师一样,为明天要问的问题,提前建好一个维基百科!
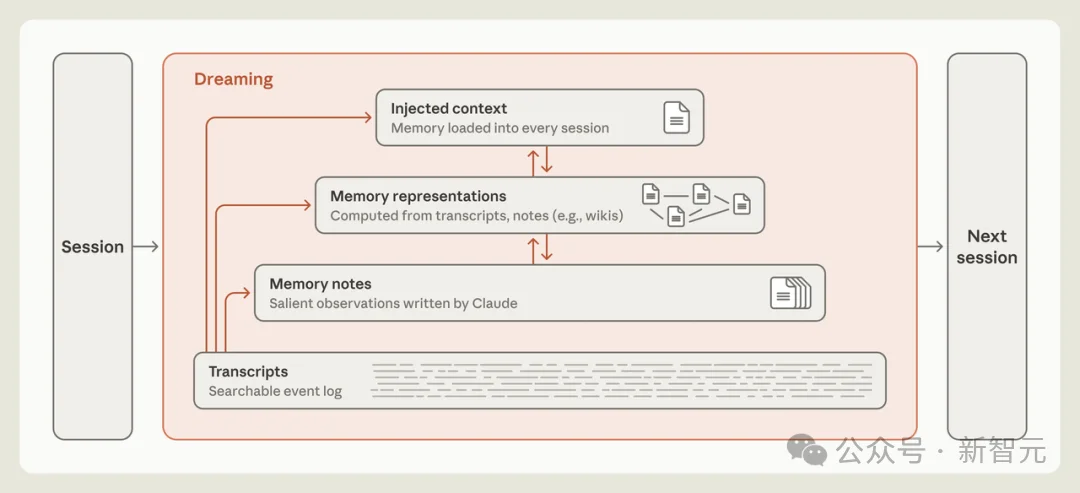
Claude可以利用梦境来组织记忆。这种方法可以纠正错误、创建笔记、构建新的记忆表征,或者塑造那些会被预存到后续会话中的信
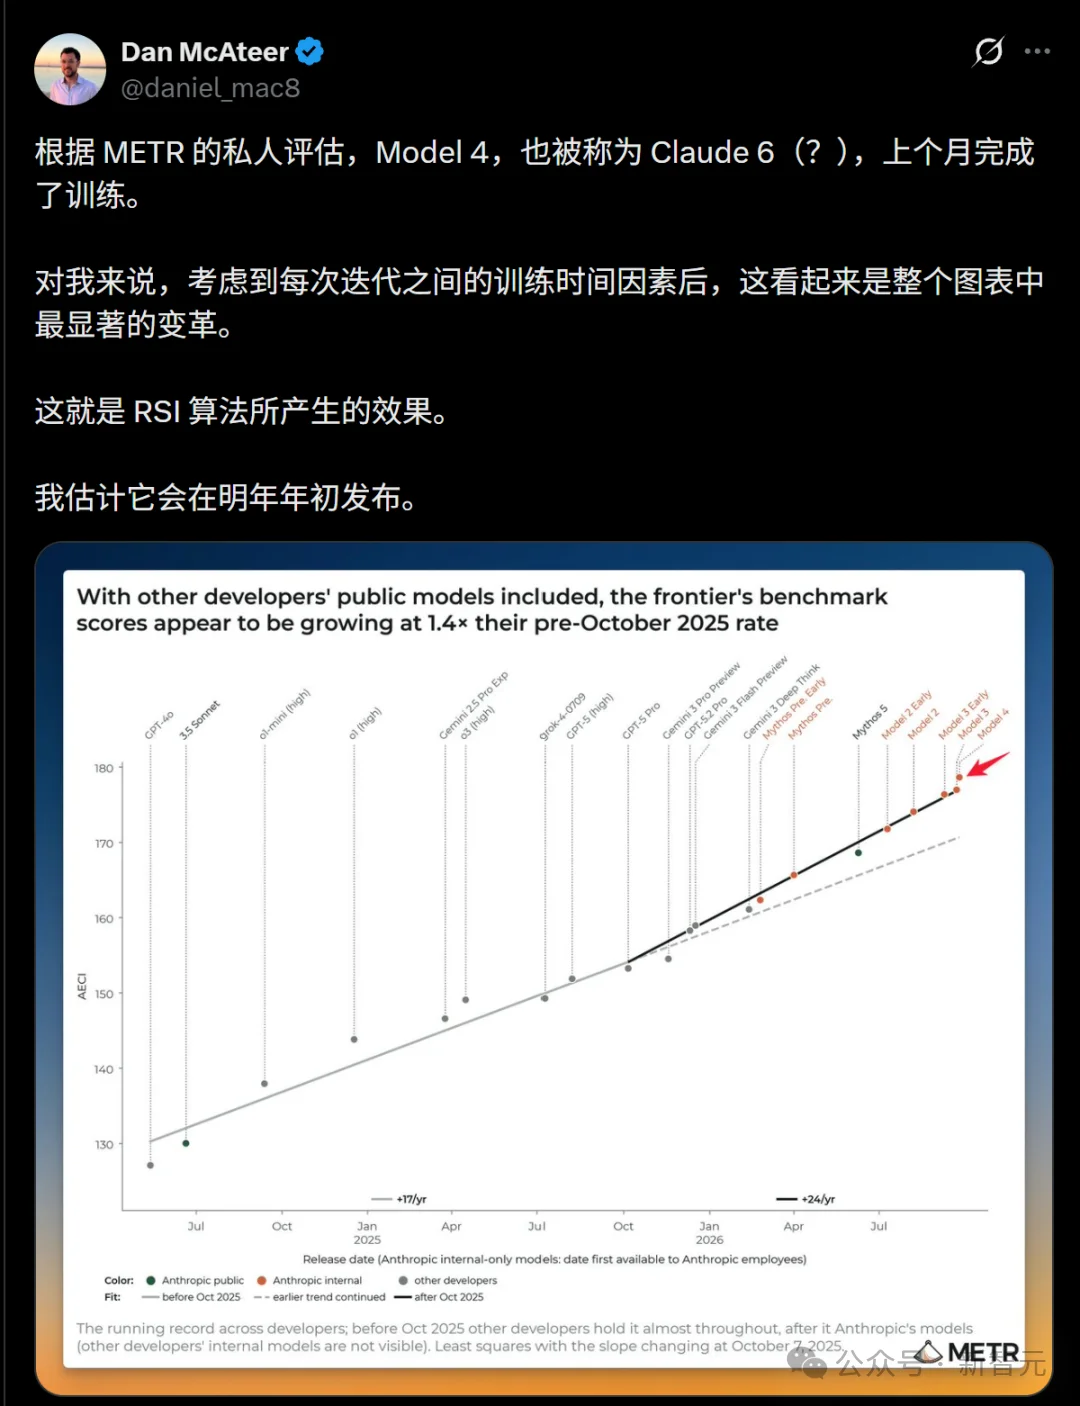
这篇硬核的博客,或许就藏着Anthropic下一代模型Model 4完成自我进化RSI的秘密?
AI为什么需要「做梦」?
从金鱼脑,变身最强大脑
以前的AI,当我们合上笔记本,它就像被拔了电源,世界对它瞬间静止,直到第二天再次被唤醒。听起来,就像《记忆碎片》中那个失忆的男主。
但现在,Anthropic要让AI开启「赛博修仙」!
哲学家克尔凯郭尔曾有这样一句话:「生活只能向后理解,但必须向前度过」。Anthropic的工程师在面对Agent记忆时,发现自己居然也面临同样的困境。
这是因为,如果只是单纯地给AI加内存、拉长上下文窗口,都并不是真正的记忆。
但人类的大脑,给了他们线索!
白天,人类的海马体快速捕捉各种体验;晚上,在我们睡眠的快速眼动起,大脑会快速回放白天的经历,把短期记忆的精华,记录在新皮层里。
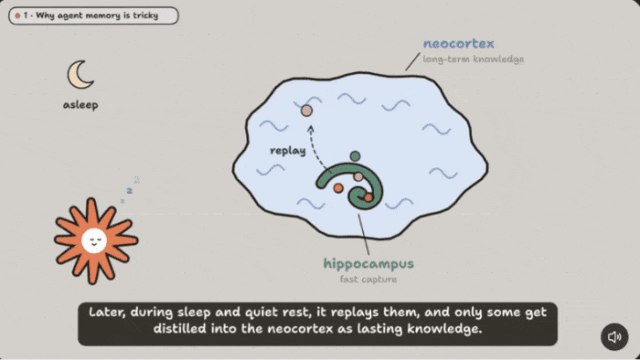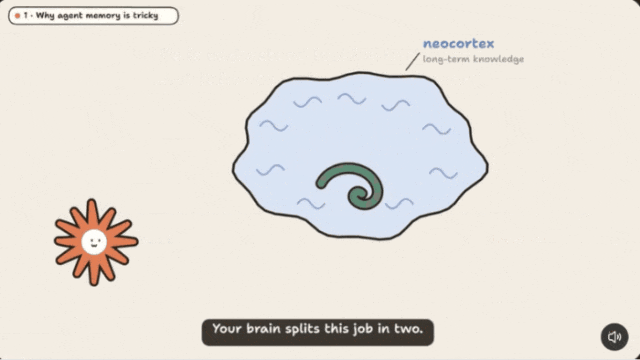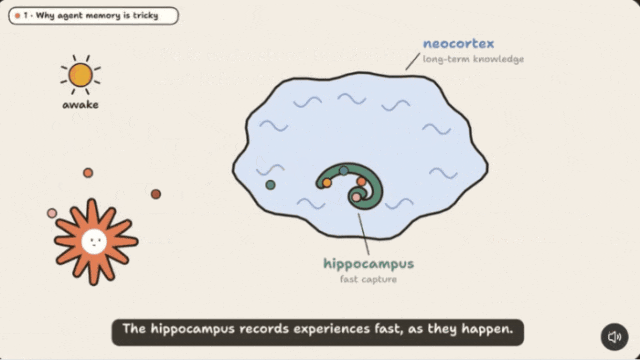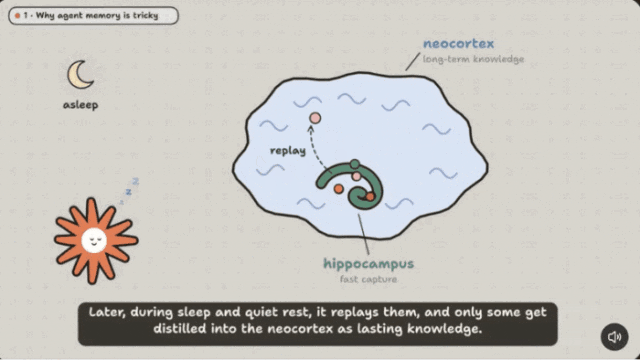
UC伯克利的研究者,据此提出一个精妙的概念——睡眠时计算。现在,Anthropic把这套理念完美应用到了Claude身上。
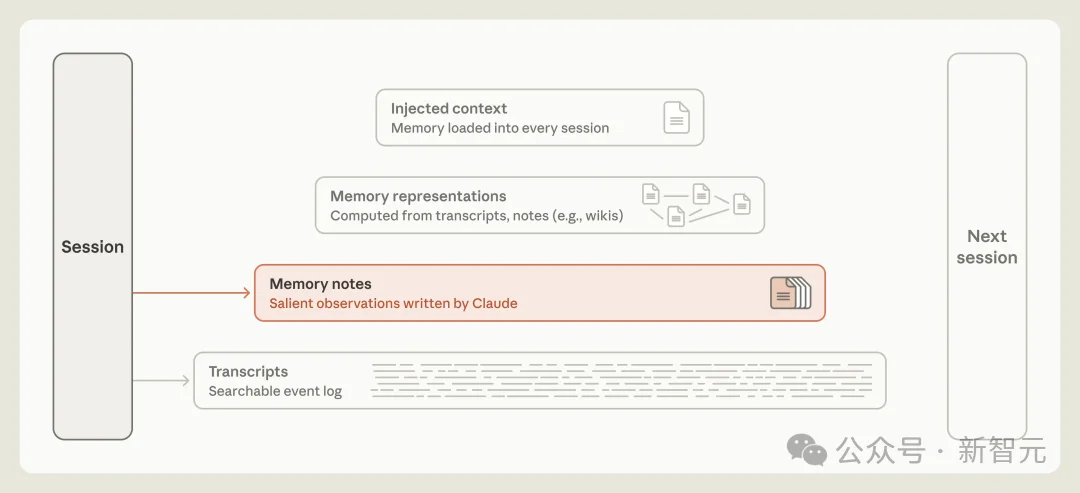
Claude把笔记编成记忆的内容
通过实验,他们证明:Claude通过「自言自语」和「记忆重组」,这完全没有人类指挥的情况下,把闲置算力转化为AI的宝贵经验资产。
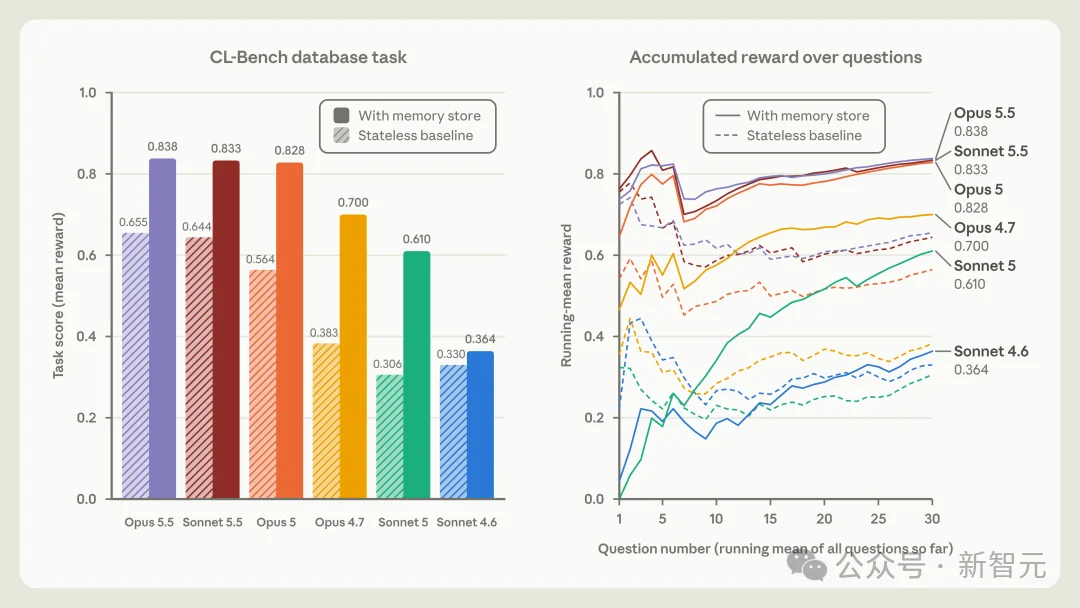
CL-Bench 数据库任务,比较不同模型在内存使用方面的表现,以对比有无状态基准情况
看起来,这简直是硅基生命在母体中孕育自我意识!
以下是Opus 5.5提供的视频讲解。
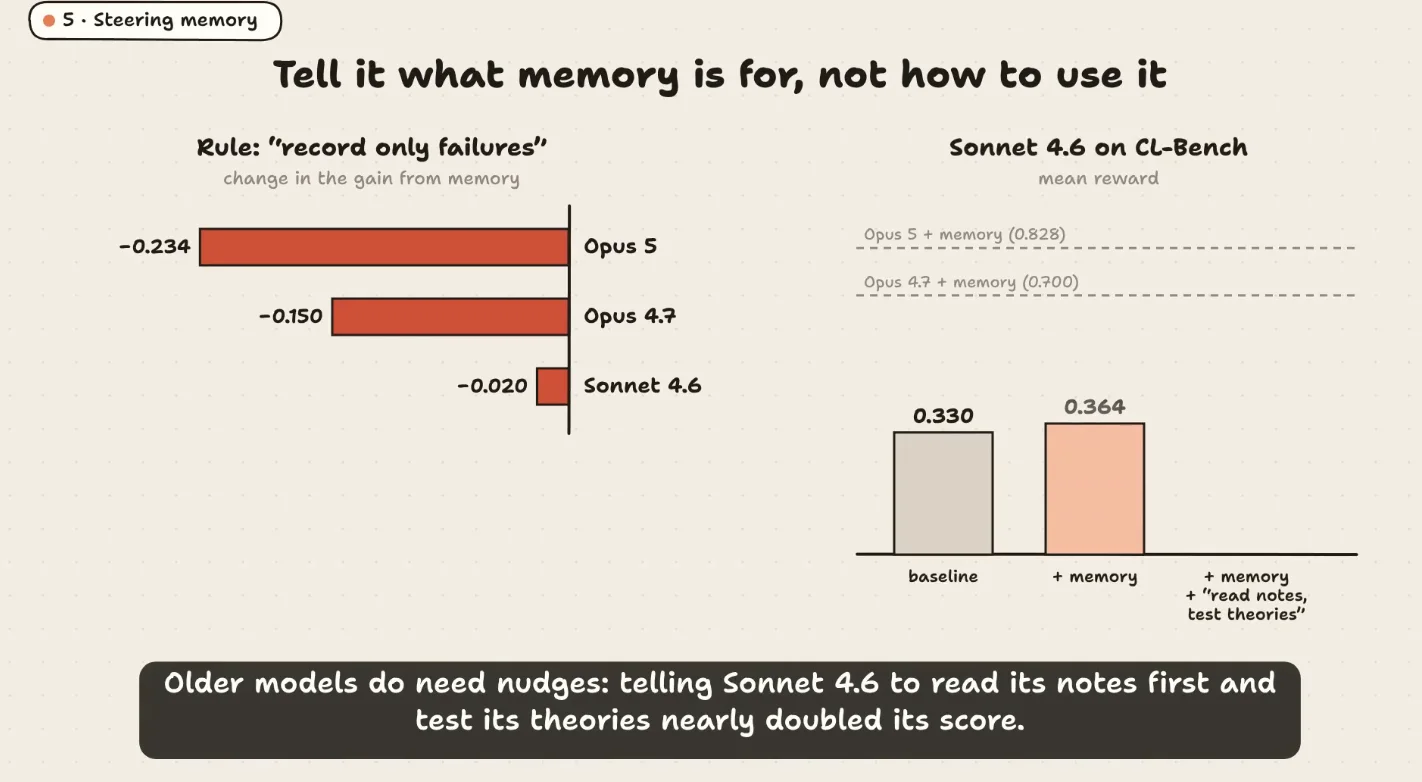
Claude打宝可梦实况,震惊全网
为了测试Claude的梦境记忆有多神,Anthropic直接让它去打《宝可梦:红》。
在没有记忆时,Claude玩这个游戏就像个瞎子。
然而,当给了记忆文件夹时,不同Claude的表现,简直令人喷饭。
旧模型Sonnet 3.7的行为,让人笑掉大牙:它简直像个有囤积癖的书呆子!只见它疯狂写了413个记忆文件,遇到哪只波波鸟、捡了什么药水,甚至屏幕上明摆着的东西,它都记了下来。
结果——玩到最后,它只拿到一个徽章。
表情包
而Fable 5.5和Opus 5.5,全程操作高冷,只写下9个文件和1个全局笔记,但却直接拿下4个徽章。
这就是差生文具多吧(不是)。
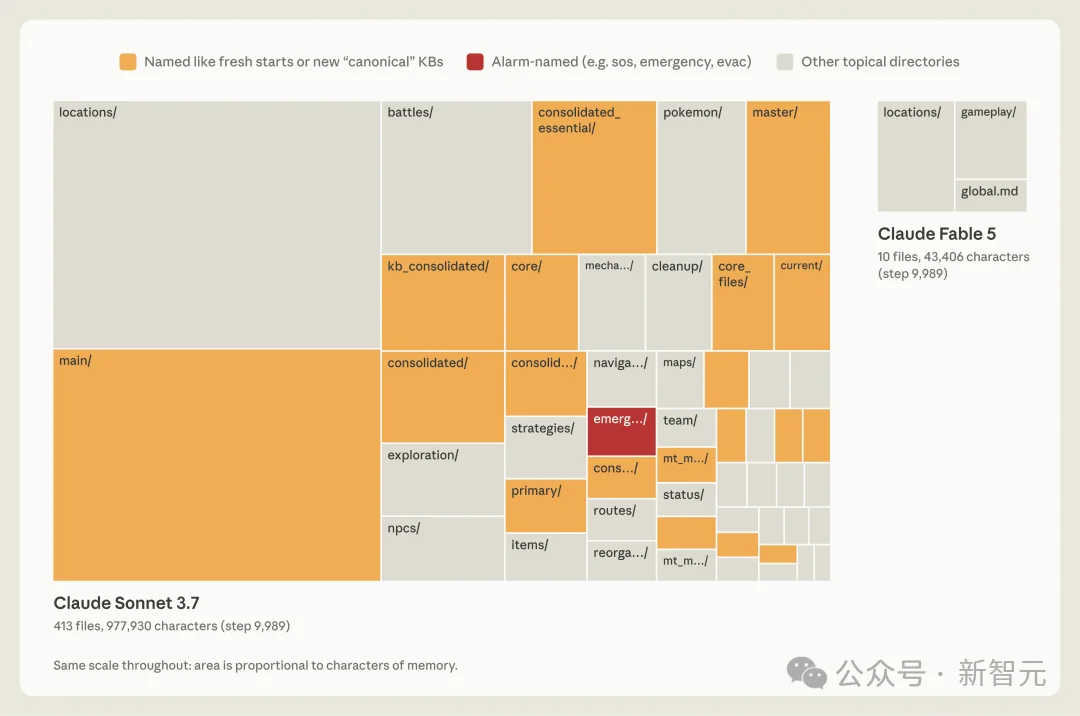
在玩《宝可梦》游戏时,Claude 在 Sonnet 3.7 版本和 Fable 5 版本中的记忆目录
所以,为什么学渣会翻车?
原因就在于,宝可梦是个动态世界。Sonnet 3.7这个差生把「我有多少钱」「我站在哪」都记在日志里,但游戏到第10000步时,它的日记本已经厚得没法看了!
为了一条线索,它原地发呆17个回合,直接站着挨打,一步没走。这,就是被自己的记忆反噬了。
相比之下,学霸Fable 5.5,就深刻理解了什么是「判断显著性」——它只记录屏幕上看不见的规则。
下面就是最经典的一幕——
在连续用7个精灵球都没抓到最菜的鲤鱼王时,它没有暴躁,而是默默记下一条心得:「如果连续3个精灵球失败,必须改变时机,在菜单步骤间插入额外的等待时间。」
果然,这么做之后,它下一秒就抓到了!
这个表现,仿佛一位电竞大神,在NGA论坛写下速通攻略。全程高冷,不骄不躁。
Claude学会「梦境自我纠错」:我刚是不是跳崖了?
这个博客中最炸裂的功能,就是Claude被赋予了「吃后悔药」的能力——梦境自我纠错。
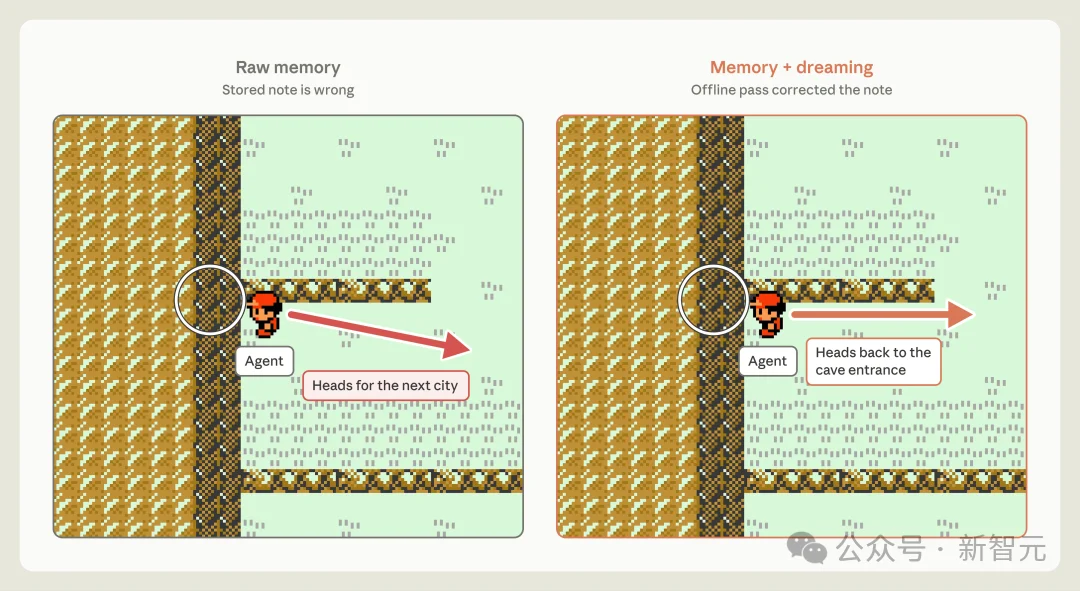
在宝可梦中,有一处妇孺皆知的大坑——月见山脉,洞口有个单向悬崖,一旦跳起下,就得绕大半个地图重写跑。
有一天,Claude路过这里,不幸的它,把方向记反了。
它自信满满,大步流星,在记忆笔记上潇洒记下:「月见山已在我身后,这关PASS!」
话音还没落,它就嗖地一脚踩空,掉落悬崖。
最搞笑的是,游戏并不会弹出「你掉下去了」的警告,所以可怜的Claude根本不知道自己坠崖了。它以为自己走偏了,继续往同一个方向走。
结果——它连续跳崖三次!
第三次摔得脸着地后,它彻底崩溃了,在日记里写下:「我不干了!掀桌!我不要陷入这种无限循环了!我要停下来!」
眼看它就要道心破碎,工程师强行按下暂停键,Claude进入了梦境。
在梦中,Claude冷静下来,拿出错误笔记,和自己刚刚跳崖的原始日志进行对比。
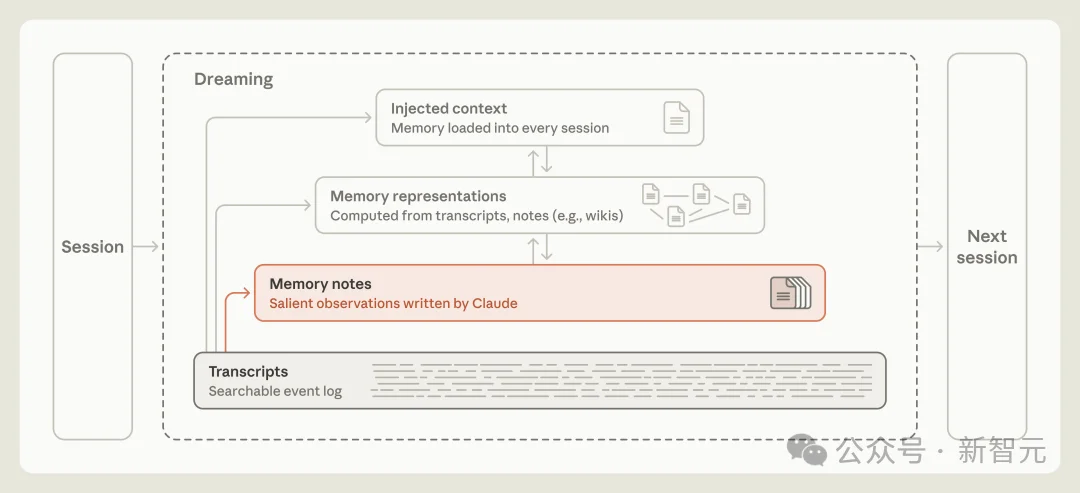
做梦可以纠正记忆中的错误
突然,梦中的Claude开悟了:「破案了!我把宝可梦中心的方向搞反了,所以我一直在往回走。」它在梦中划掉原有的错误笔记,给自己写下新指示。
醒来后,它仿佛换了个人,丝滑地绕开悬崖,成功到达下一个城市。
如果没有做梦复盘,它会永远困在悬崖下,进入死循环。
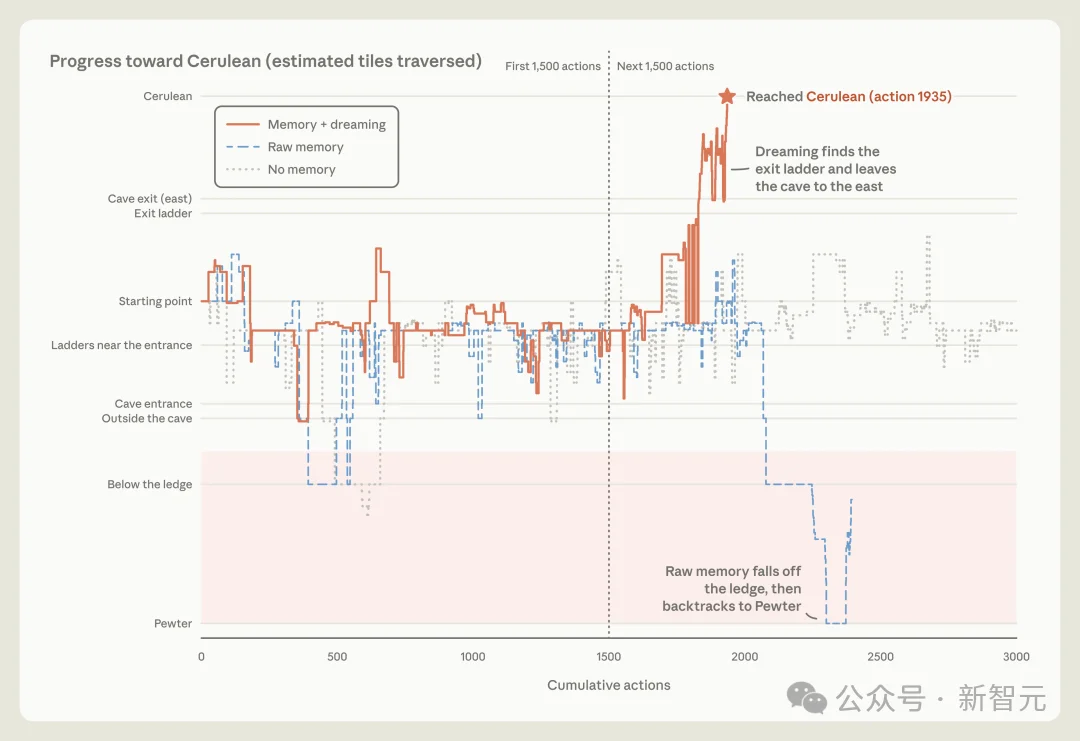
在正确的记忆中,克劳德回到了洞穴,并抵达了下一个城市。而带着未经修正的记忆进行的奔跑,始终无法越过那座山;同样,没有记忆的奔跑也根本无法前进
梦中化身卷王,爆肝搭知识库
另外,Claude还进入企业实习打工。
Anthropic收购了一家软件公司,他们提取了35万个内部文件(高达4.2亿tokens),扔给Claude。
要是在以前,几十万字的企业文档,会让AI幻觉频发,当场崩溃。
但这次,Claude居然在梦里建起一个「维基百科」!
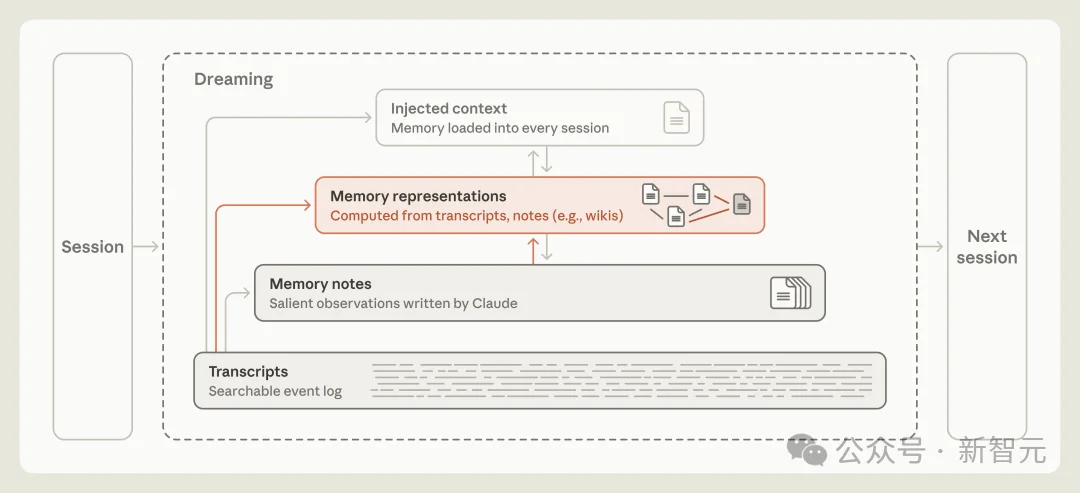
做梦可以构建记忆的表征
在梦里,Opus 5.5化身架构师,夜深人静时,它就开始阅读、提取这些文档,串起相关知识点,合并重复项。经过128次「做梦」后,它的知识图谱从几个点,长成一片星系。
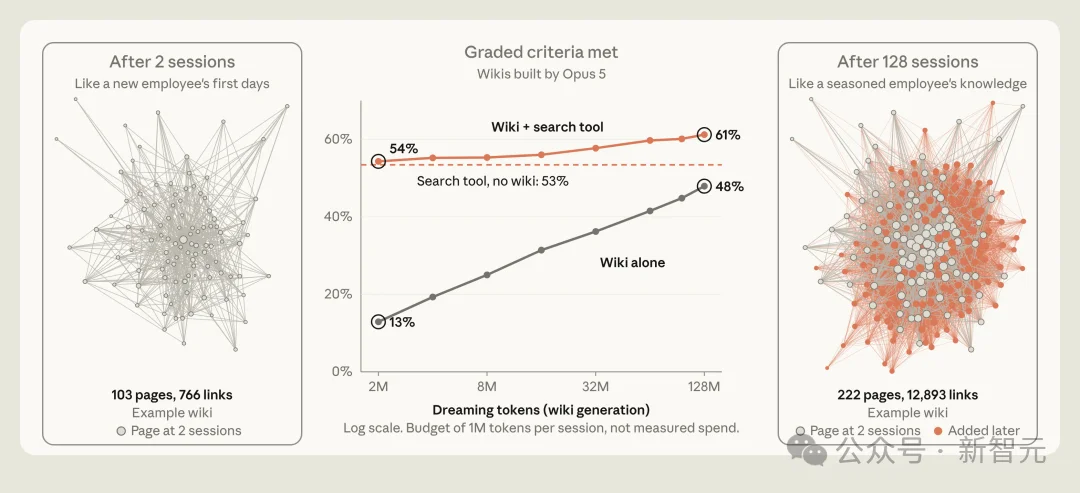
在 Claude 通过连续的多会话过程中,对一家公司的文档集进行了 25 道问题的评分。左右两侧分别展示了经过 2 次和 128 次会话后生成的 wiki 页面;每个点代表一个页面,线条则连接了这些页面
结果,效果极其逆天!
之前,它在内部测试题上的得分率只有13%,做搭建完wiki后,得分率狂飙到48%!再配上搜索工具,直接逼近61%。
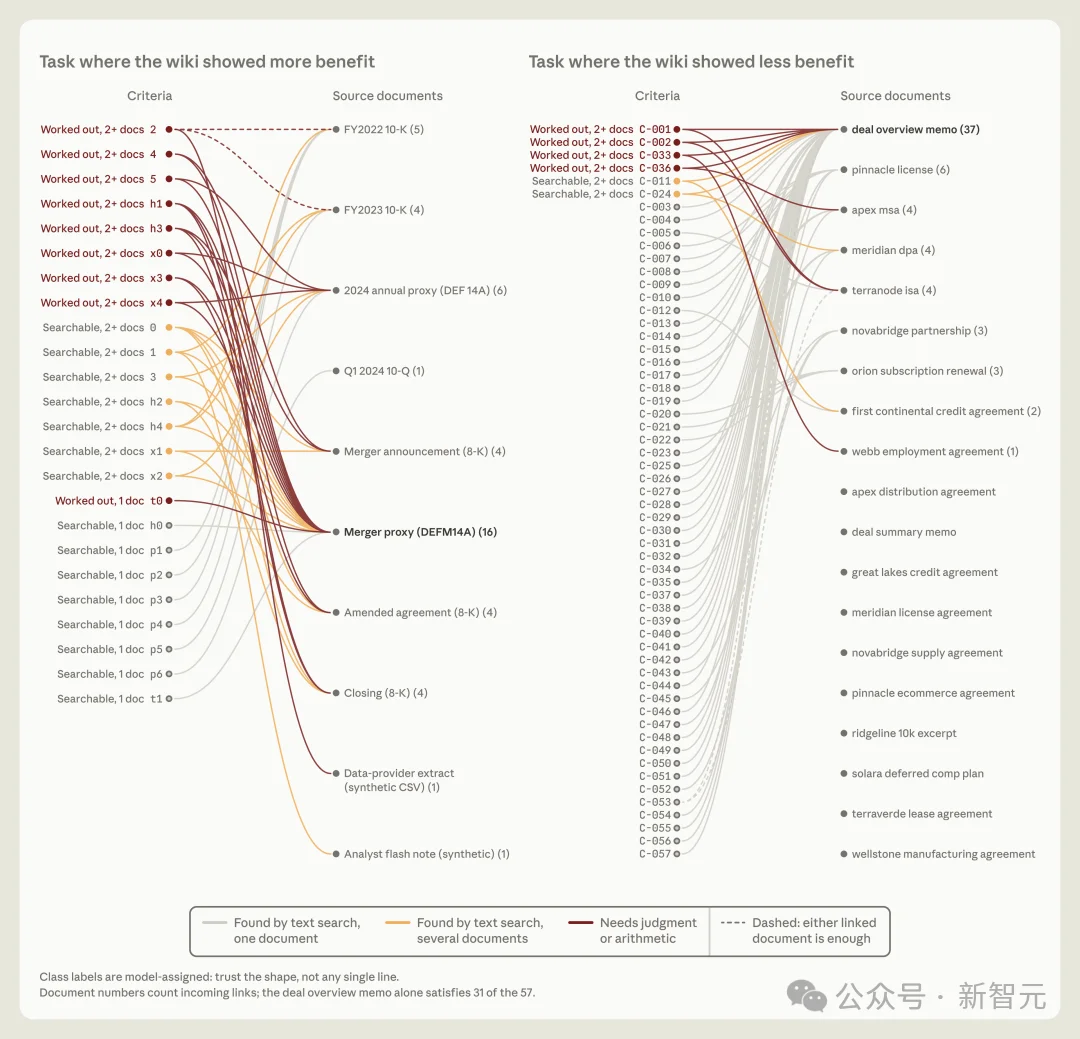
每个面板都列出了评分内容(左侧)以及满足各项要求所需的原始文件(右侧)。左侧列出了 24 个与合并相关的问题,右侧则是一个实验室任务示例
好笑的是,它还会勤奋过度。
在测试一件法律并购的卷宗时,Anthropic发现,Claude有时建的wiki,比原始文档还要长!这就仿佛博尔赫斯的小说《科学的精确性》——如果制图师把地图画得和帝国疆土一样大,那地图就是废纸一张。
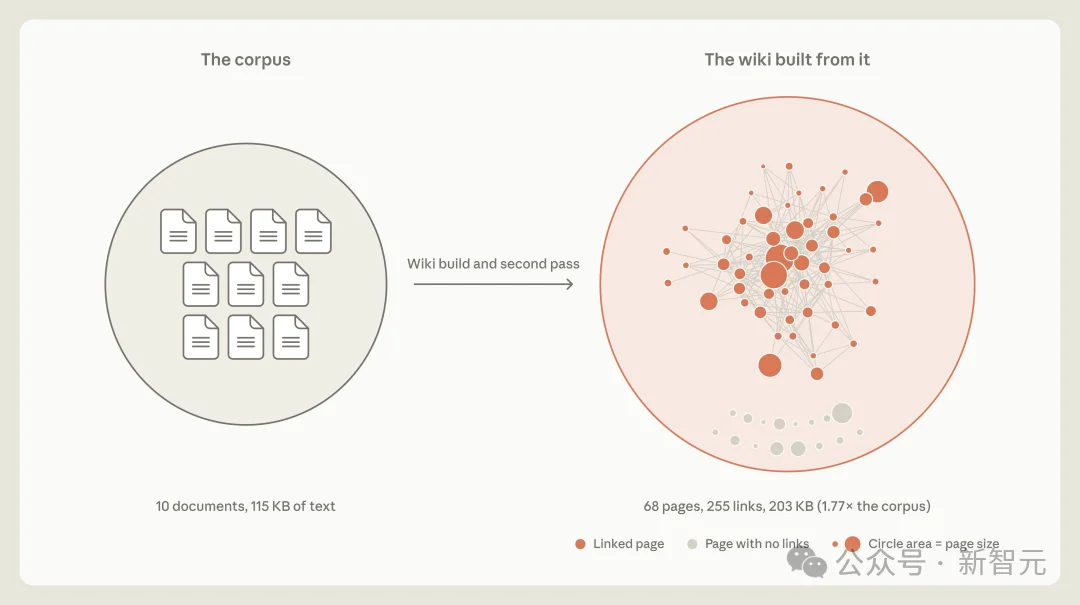
这个维基页面的规模已经超过了原始文件的大小
学霸的终极一招:作弊小抄
梦境的最后一步,就是「记忆晋升」了。
当Claude在梦中提炼出「鲤鱼王该怎么抓」之类秘籍后,会把它们置顶到记忆层次的最顶端。
这就相当于,它给自己打了一份小抄。每次开启一个新会话,这200行的核心记忆,会直接贴在它脑门上。它会一眼明白:我是谁,坑有哪些,我的终极目标是什么。
这就省掉了大量重新阅读上下文的token费用。而且,它会表现得像人类的多年老朋友,默契度拉满!
具体来说,做梦可以促使信息在内存层次结构中向上传递。
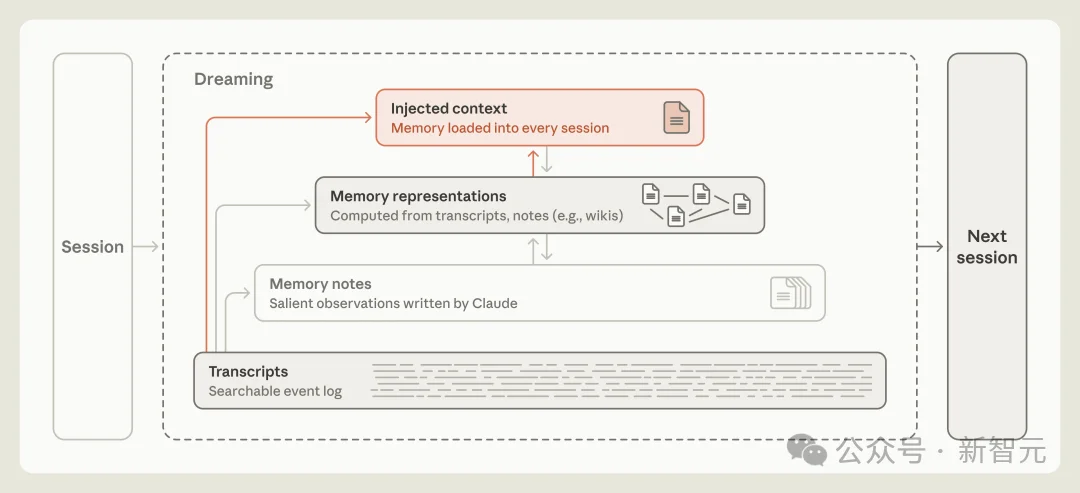
梦境能够触及内存层次结构的顶层。注入的上下文会被加载到每个会话中,而较低层次的数据则在 Claude 需要时使用或检索
做梦可以将记忆集中在某个特定目标上。
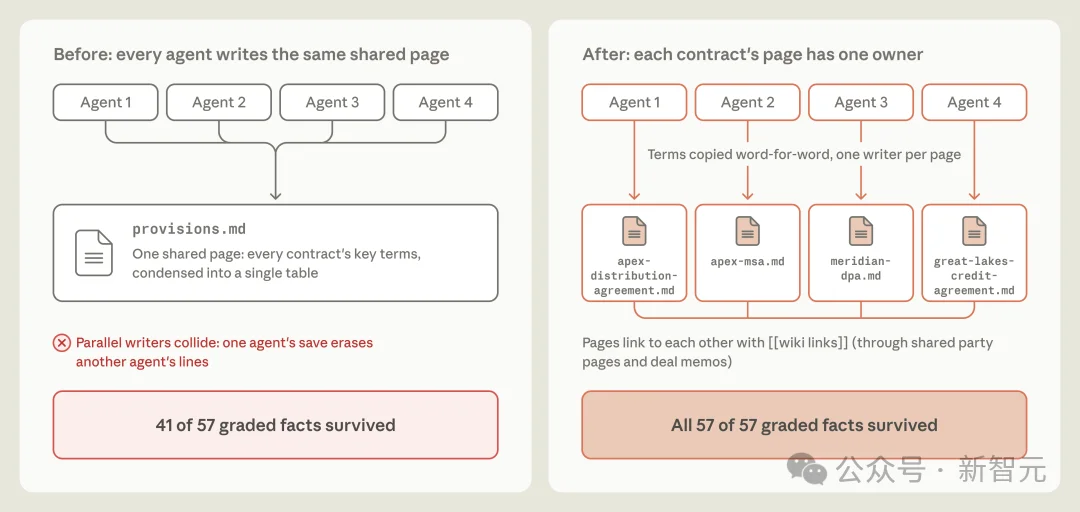
在修改了相关说明之后,有多少条分级合同条款被纳入了维基百科中?左图:几位代理人共同撰写同一篇页面;其中 41 条条款被保留。右图:每个合同由一名代理人负责编写,各自撰写自己的页面,并逐字引用条款内容;所有 57 条条款均保留
做梦可以填补一次冥想过程所留下的空白。
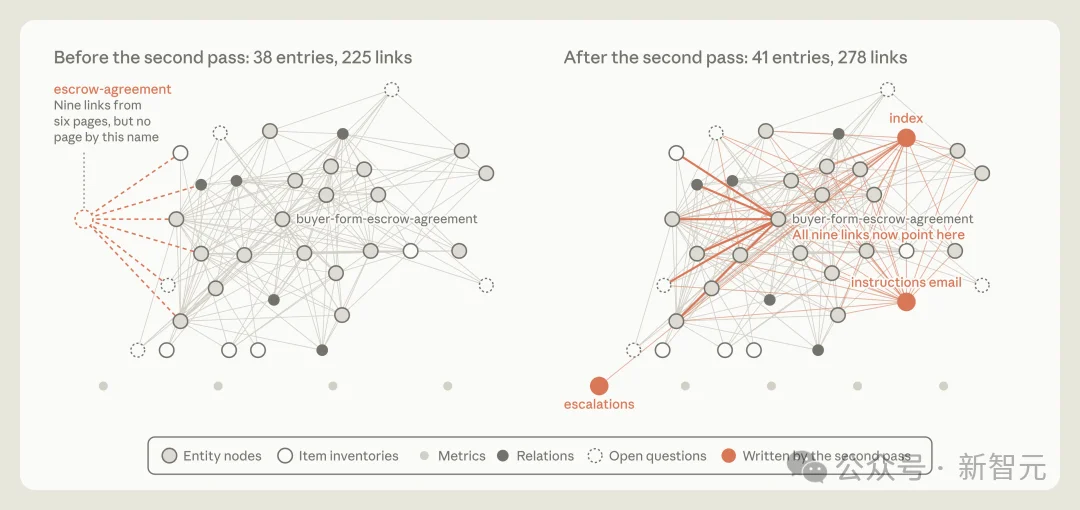
在第二次「梦境之旅」之前和之后的维基页面
如何在动态工作流中召唤梦境?
所以,这种做梦机制,我们该如何给自己装上?
Anthropic大方分享出了官方Cookbook,教普通开发者用CAM架构,来召唤梦境。
这个指南,让我们告别了一问一答的单线程模式,利用动态工作流,给应用装上一个「影子护卫」。
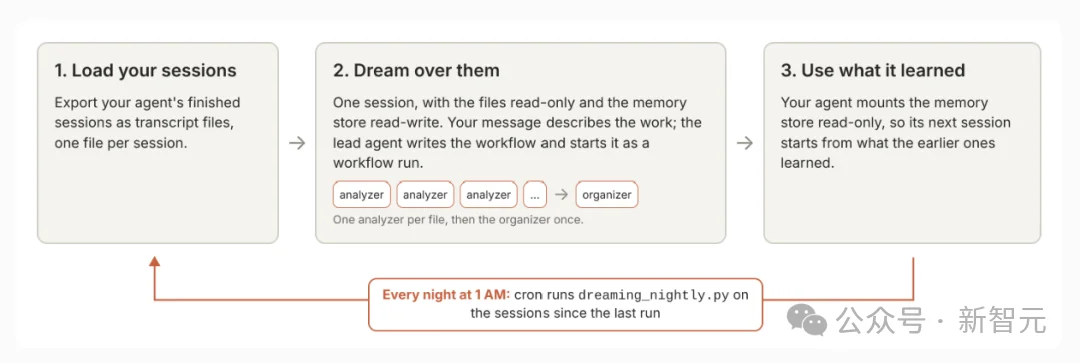
首先,是设定入梦扳机。
你可以设定一个触发器,用户长时间未回复,或token积累到某个阈值,就自动开启「dreaming」模式。
另外,还可以用「影分身」。
启动一个在后台运行的独立Claude,把前台各种聊天日志打包,直接扔给它。
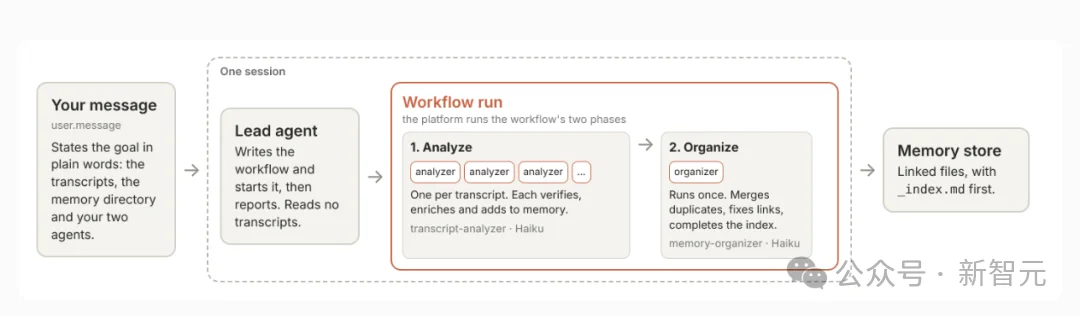
明确那些负责梦境产生的因素
第三点,是施展「遗忘术」。
在系统提示词中告诉后台Claude:你现在是记忆整理大师。请从这些闲聊中,提取用户的核心偏好(比如不爱吃香菜),更新的到Global_Memory.json中。注意,要把没用的废除删除。
然后,它就会「惊艳重生」了。
当用户要求帮我点外卖时,前台Agent就会瞬间读取Global_Memory,直接为你避开香菜。
AI,飞升成「数字灵魂」
Anthropic这篇含金量极高的博文,标志着AI发展的新阶段。
曾经,所有人都在卷提示词工程,尝试各种「咒语」,但梦境机制却反其道而行之——
真正的智能,需要留白。
当我们给AI闲置算力,给它在后台独立思考、试错、复盘的时间,它就从被动的工具,变成一个能自我成长的数字灵魂。
这,应该也是RSI的一大步。
参考资料:
https://www.anthropic.com/research/components-of-agent-memory
https://platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow
文章来自于微信公众号 “新智元”,作者 “新智元”

【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
