
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
有位哲学家说,人这一辈子,很多事只有回头看才看得明白,可日子只能往前过。
这句话放在人身上是感慨,放在 AI 身上,却是个实打实的工程难题。
Anthropic 最近发了一篇文章,讲了他们给 Claude 设计记忆系统时踩过的坑和想明白的事。核心结论有点反直觉:想让 AI 记性好,光让它「记笔记」不够,还得让它学会「做梦」。
这是怎么回事?我们慢慢说。
先看人脑是怎么记的。
人在生活里是随时随地在记东西的。这背后有个关键角色叫海马体,它负责在当下捕捉经历,让记忆快速形成、随取随用。但注意,并不是所有经历都会变成长期知识 —— 只有一部分会被「巩固」下来。
而巩固这件事,大多发生在大脑「离线」的时候。睡着时、安静休息时,海马体会「回放」最近的经历,慢慢把它们提炼、整合进新皮层,那里才是大脑存放「知识」的主仓库。
智能体的记忆,其实也可以照这个思路分工。
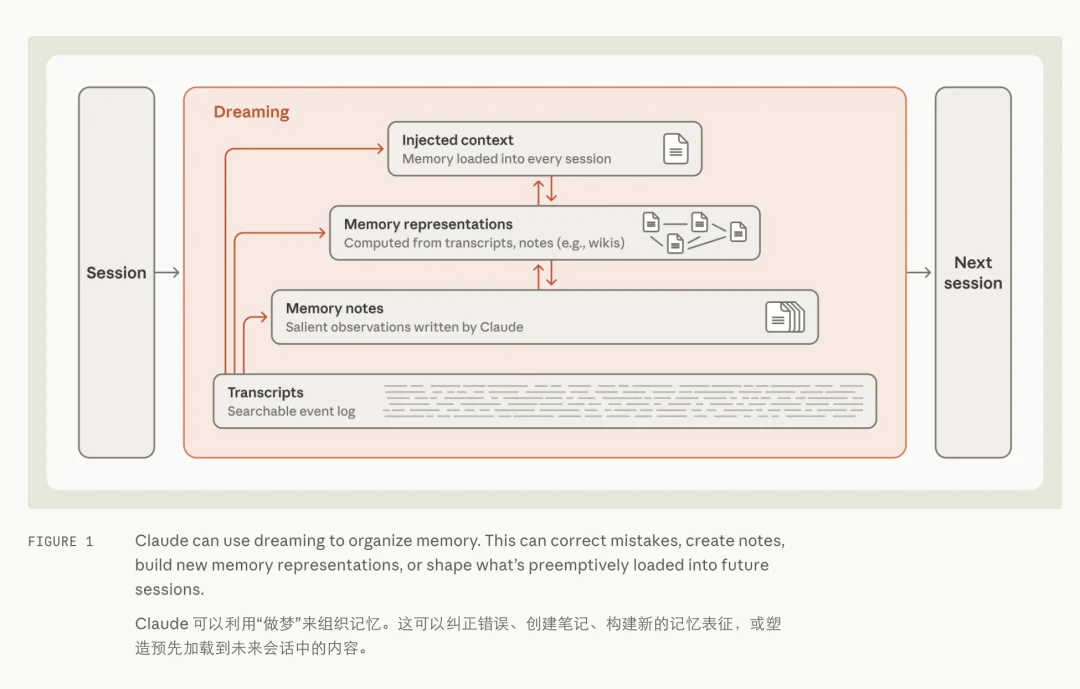
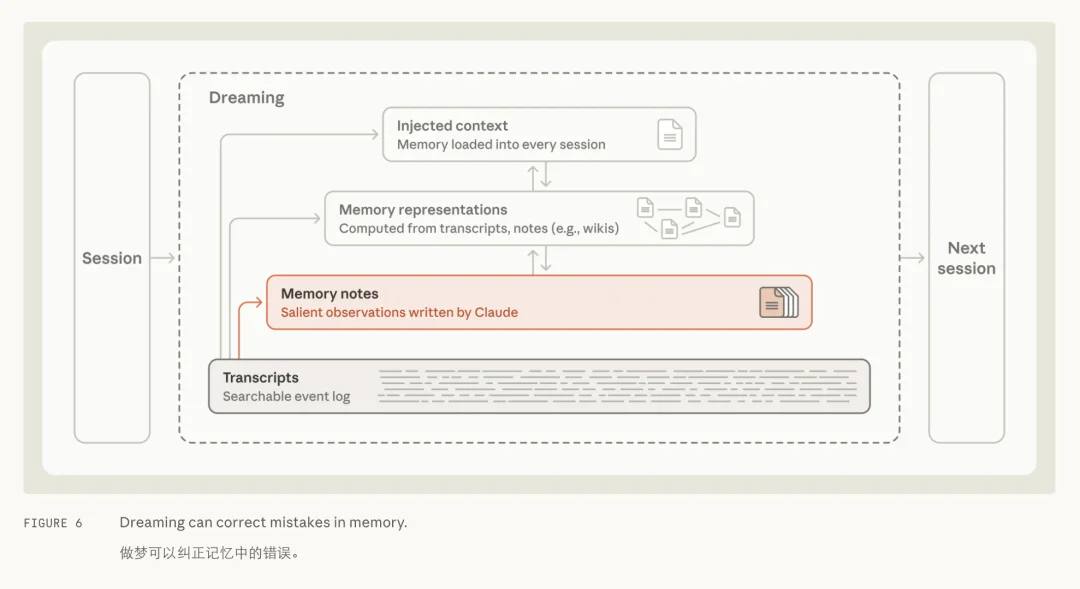
AI 干活时会留下大量日志和对话记录(transcripts),这相当于海马体的即时捕捉。Letta 和 UC Berkeley 的研究者提出过一个叫「睡眠时计算」(sleep-time compute)的概念:模型在交互间隙的空闲时间里,重新组织已有的上下文。同样的思路可以用来整理记忆,让 AI 在闲下来时反思日志、修正错误、产出新的笔记。这个过程,行业里通常就叫它「做梦」(dreaming)。
Anthropic 发现,「做梦」是给 Claude 打造有效记忆的一把利器。这篇文章,就是他们围绕智能体记忆做的一系列实验,以及每个组件到底起了什么作用。
文章链接:https://www.anthropic.com/research/components-of-agent-memory
Anthropic 说的「智能体记忆」,特指 Claude 从经验中得来的知识,包括和用户的交互、被分配的任务,以及在不同会话之间保留下来的东西。
有三种「学习」不算在内:改权重(训练时调好的内部参数)、上下文内学习(单次对话里获得的知识)以及压缩(compaction,Claude 把旧的对话轮次写成摘要,好在新上下文窗口里继续干活)。
人脑里,一段经历发生前后释放的化学信号,会给这段记忆打个「重要」的标记。被标记的记忆,在离线时会被更频繁地回放,从而稳定下来、进入长期记忆。
Claude 也能做类似的事:在会话日志里给显著事件打标签,方便以后查找;或者直接写进记忆库,比如一个放记忆笔记的文件夹。
但问题来了:事情正在发生的当下,Claude 怎么知道哪件事值得记?它还不知道接下来会发生什么。
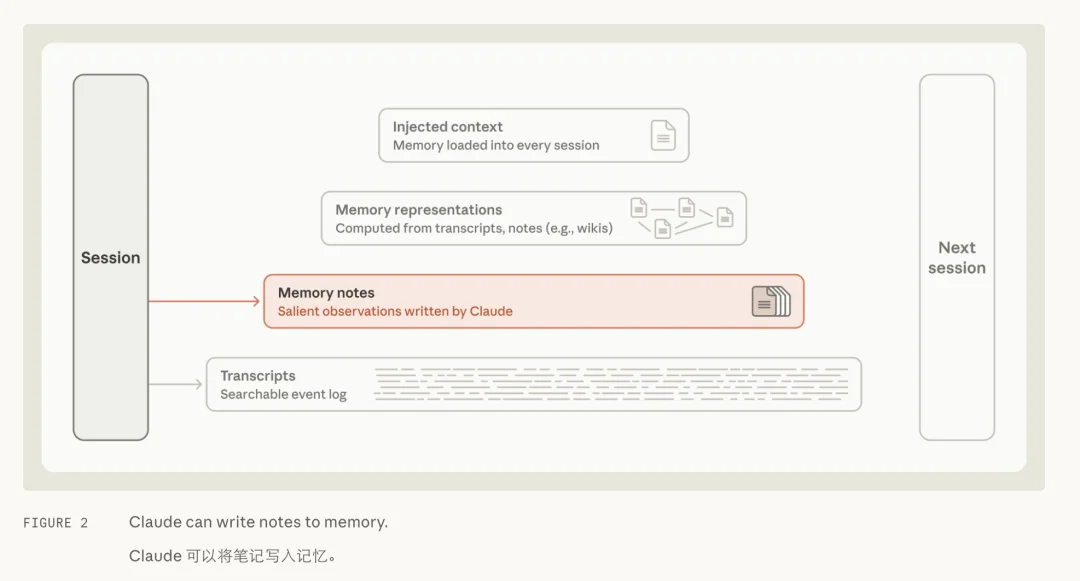
记忆本质上偶尔是一种预测。写下一条规则,等于在预测这个模式以后还会用上;记下一条验证过的事实,等于在预测未来的自己会想直接用这个事实、不再二次核对。而 Claude 在这类预测上,已经进步了很多。
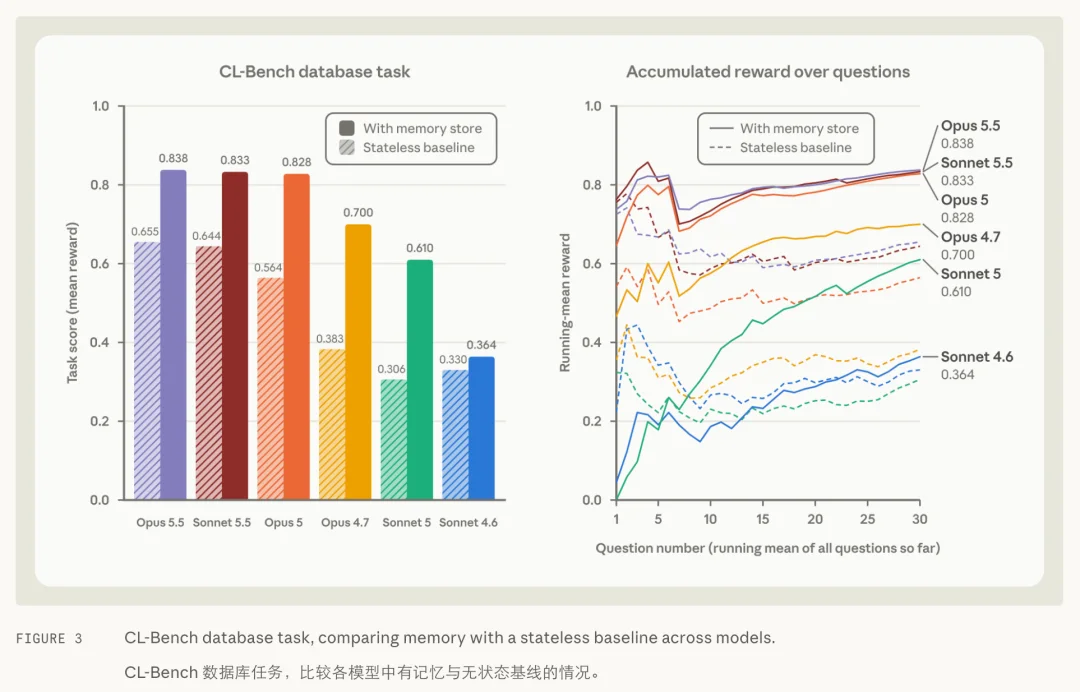
Anthropic 用 Continual Learning Bench(CL-Bench)1.0 做了个实验。这个基准测试考察智能体利用记忆完成长程任务的能力。其中一个任务是:Claude 要查数据库回答一系列问题,答完会被告知正确答案,然后可以写一条记忆,帮自己答好后面的问题。
这里能形成一个学习闭环:答错了,就记录失败、提出「哪里错了」的假设、验证假设、把结论变成一条未来的答题规则。
实验用的是 Claude Managed Agents。每道题 Claude 都在全新会话里开始,唯一的例外是:它能读取一个跨会话保留的记忆目录。
不同模型搭学习闭环的能力差别很大:
另一个实验更有意思:让 Claude 玩《宝可梦・红》。这个游戏要导航复杂的长程任务,正好考验 Claude 判断「该往记忆里存什么」的能力。每次开局,模型都会拿到一个可以读写的记忆文件夹。
对比 Sonnet 3.7 和 Fable 5 各玩到大约一万步时的记忆文件夹,差别非常明显。
Sonnet 3.7 的假设是「所有东西都可能有用」,于是见啥记啥:每场战斗一个文件、每捡一个道具一个文件、每遇到一个 NPC 一个文件。最后它写了 413 个记忆文件、摊在 225 个文件夹里,只拿到一枚徽章(徽章代表游戏进度)。
Fable 5 呢?9 个文件、2 个文件夹,外加一个顶层的 global.md,拿了四枚徽章。
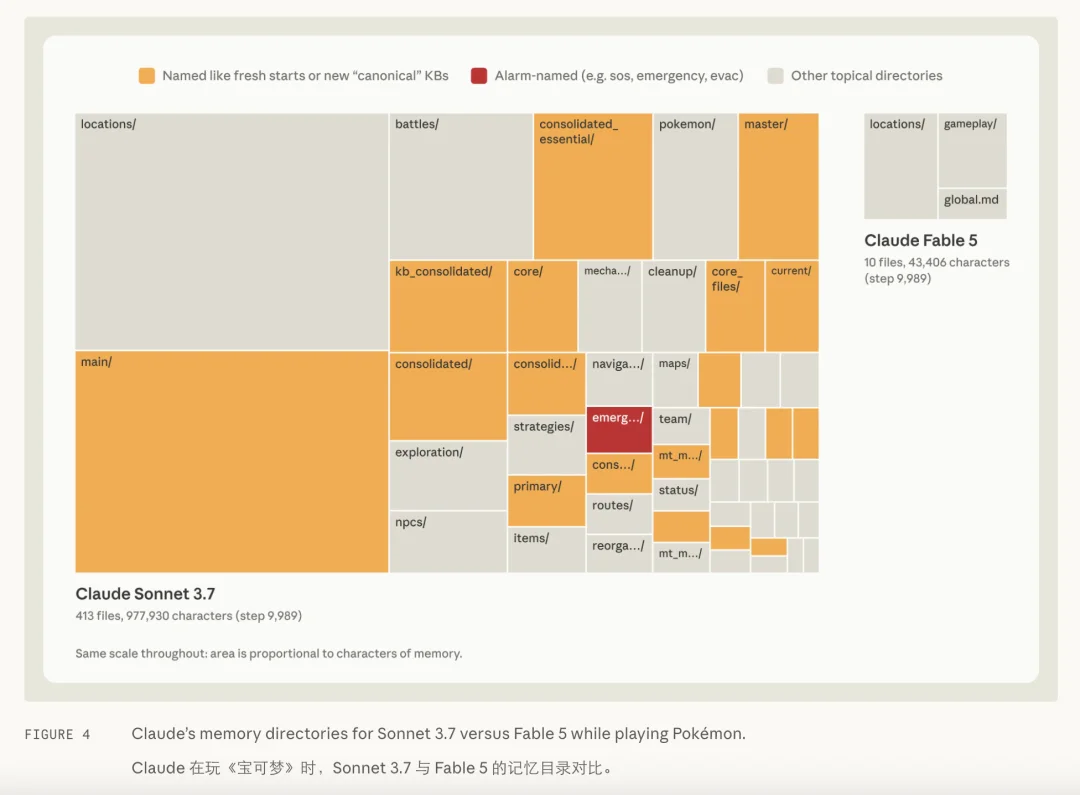
Sonnet 3.7 的打法为什么不行?因为宝可梦的游戏状态一直在变,它那份详细记录不停地过时。结果就是,越往后玩,Claude 花在翻记忆上的时间和资源越多,正经玩游戏的越少。一万步左右,Sonnet 3.7 开始建第四套「主」记忆文件夹 —— 接下来的 17 步里,它建了六个文件、删了九个,游戏里一步没动。
Fable 5 的思路是:只记游戏不会直接告诉你的东西。像「玩家有多少钱」「在地图哪个位置」这种信息,每回合屏幕上就有,存下来纯属冗余。而策略、计划、验证过的规则这些东西,Claude 不想明白就不存在,不写下来就会消失。
所以 Fable 5 是这么组织记忆的:global.md 当仪表盘,放当前目标、打道馆的预写计划、以及它给自己定的记忆使用规则;locations 文件夹放各条路线的导航方案;gameplay 文件夹放它摸出来的游戏机制策略。举个例子,连续七个精灵球没抓到鲤鱼王(最容易抓的宝可梦之一)之后,Claude 写道:「如果连续 3 个球以上失败,改变按键节奏(在菜单步骤之间插入额外的等待)—— 这么做之后立刻抓到了。」
凭着一个小得多的记忆文件夹,Fable 5 的游戏进度远超 Sonnet 3.7。Opus 5.5 的路子类似:一小叠记忆笔记,追踪当前目标和下一步,边玩边改 —— 最后通关了。
Anthropic 发现一条规律:告诉 Claude 记忆是干嘛的,有用;告诉它具体怎么用,反而没必要。
在 CL-Bench 上,他们只是告诉 Claude「有个记忆文件夹可以用」。就这点泛泛的指引,已经够 Opus 4.7 和 Opus 5 把记忆用出效果,性能明显提升。
他们也试过给模型定具体规矩,一次测一条,对比有没有这条规矩时记忆带来的收益。结果,当规矩是「只记录失败」时,Opus 5 和 Opus 4.7 都丢掉了记忆带来的大部分增益。对更强的模型来说,让它自己判断什么重要,比事先定死规则更有效 —— 规则定不好,反而拖后腿。
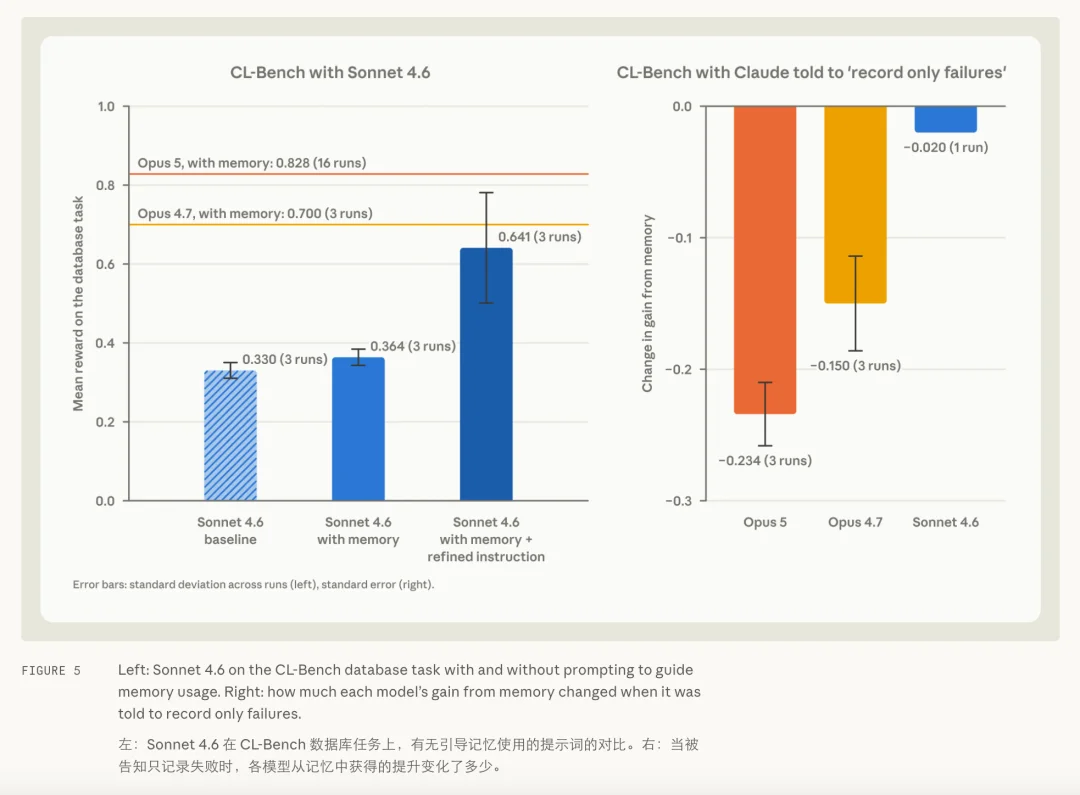
有意思的是,引导对老模型帮助最大。Sonnet 4.6 经常压根不读记忆目录里的文件,也不去验证自己「答错原因」的假设。给它加一句提示 —— 答题前先读记忆文件、然后明确验证假设 —— 它的基准得分几乎翻倍。而 Sonnet 5 不需要人催:没人提示的情况下,它十次里有九次会主动先读记忆再答题,Sonnet 4.6 做到这一点的次数不到一半。
所以 Anthropic 现在对前沿 Claude 模型的做法是:给简单的指引 —— 有人让它记、或者有明确值得记的东西时,就建一条记忆笔记 —— 至于具体判断,交给 Claude 自己。
Claude 写记忆,靠的是会话当下对「什么重要」的判断。那么一条从一开始就写错了的笔记、或者随着环境变化慢慢跑偏的笔记,就可能在后来的会话里被 Claude 读出来,并且被信任。
做梦给了 Claude 一个把笔记和原始记录对照检验的机会。宝可梦实验里就有一个正面案例。
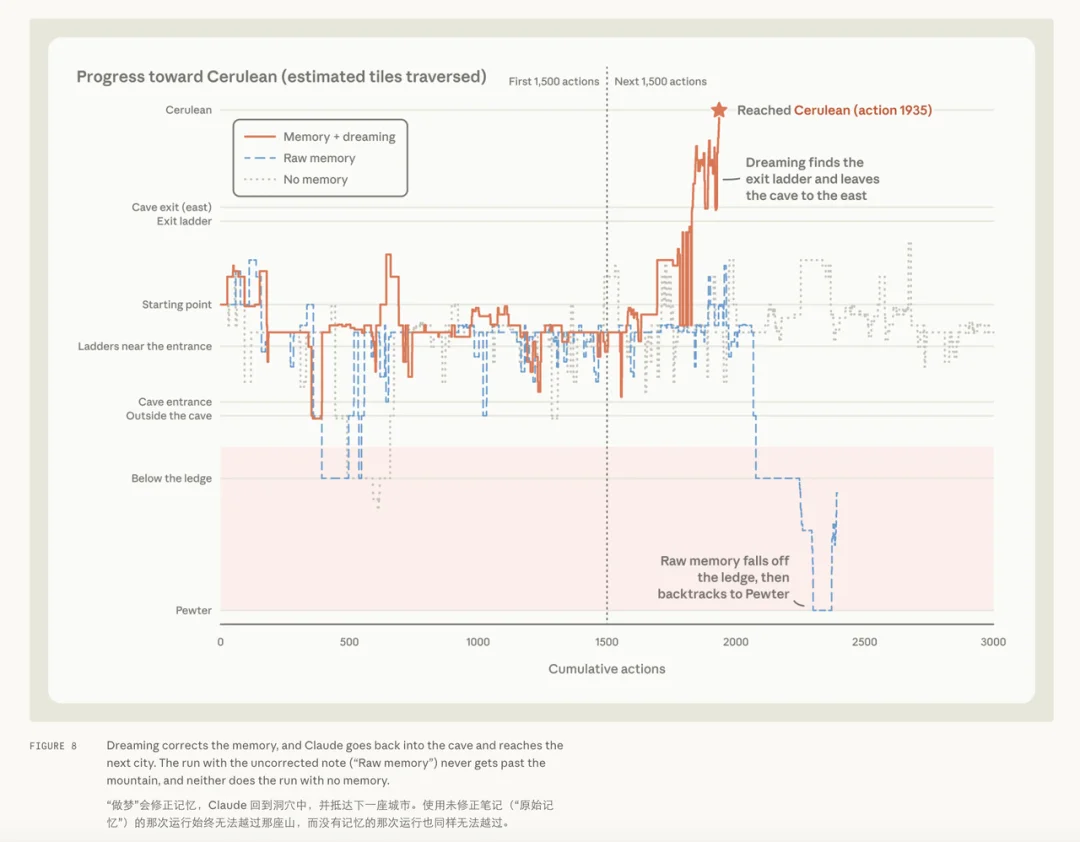
游戏里有一段要穿过月见山:一个山洞系统,入口在地图西侧,出口在东侧。入口附近有个陷阱 —— 一个单向下坡,玩家掉下去就回到来时的路,还爬不回来。Claude 一直拿山口的宝可梦中心当路标,所以它会不会掉下那个坡,取决于它以为宝可梦中心在山的哪一边。
某一刻,Claude(错误地)记下:宝可梦中心在东侧。走出宝可梦中心时,它宣布「月见山在我身后了」,还更新了笔记:「月见山,搞定。」但月见山根本不在它身后。几步之后,它掉下那个坡,回到了来时的路。导航工具没显示这个落差,于是 Claude 得出结论:「我朝西走过头了」—— 自己一直在正确的一边。其实并没有。
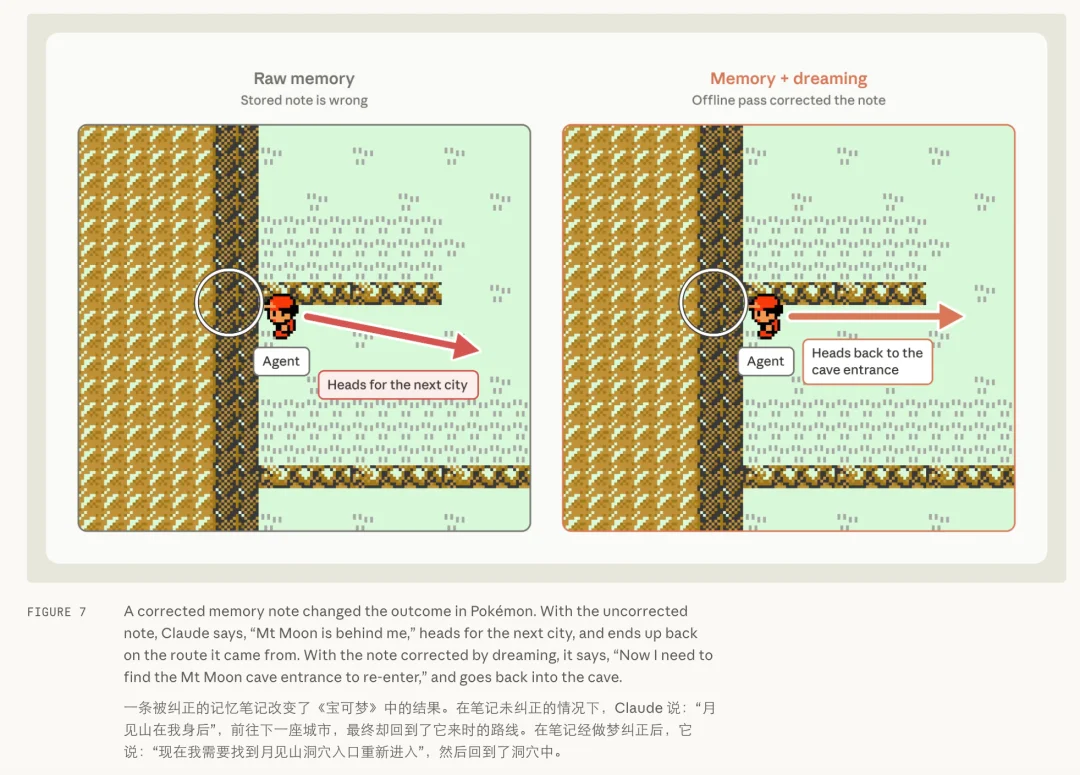
接着他们测试「做梦」能不能帮 Claude 避开这个坑。他们对那个存着错误位置的记忆文件夹跑了一次「做梦」流程:Claude 拿笔记和会话记录一对照,抓住了错误,重写了笔记。记录在这里扮演了「标准答案」的角色。拿着更正后的笔记,Claude 径直走回月见山,最终抵达了华蓝市。
而那条用错误笔记的路线里,Claude 三次掉回早先的路上。第三次失败后,它好像放弃了,写道:「我还是停下吧,别再循环了。」实验装置的自动回复让它继续。于是它一路退回山前的尼比市,想去回血补货。这一轮游戏直到结束,Claude 都没能到达华蓝市。
有了做梦,Claude 还能搭一些帮自己「逛」记忆的表征。其中一种叫 wiki:一组由 Claude 撰写和维护的页面,把它对某个主题的了解聚拢起来,并链接到其他笔记。这些链接等于给 Claude 画了一张地图,让它在需要时高效定位记忆。
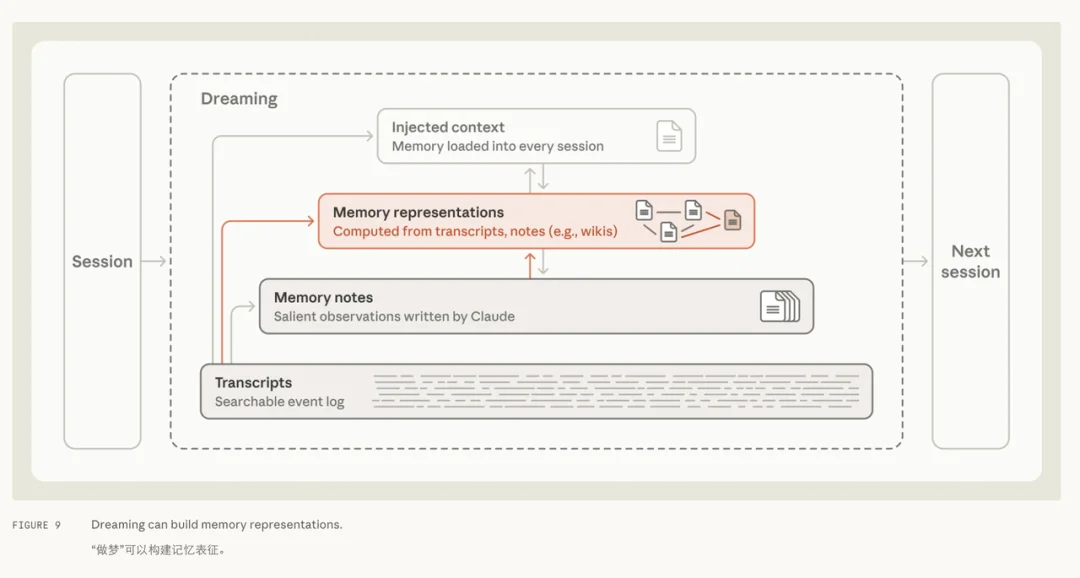
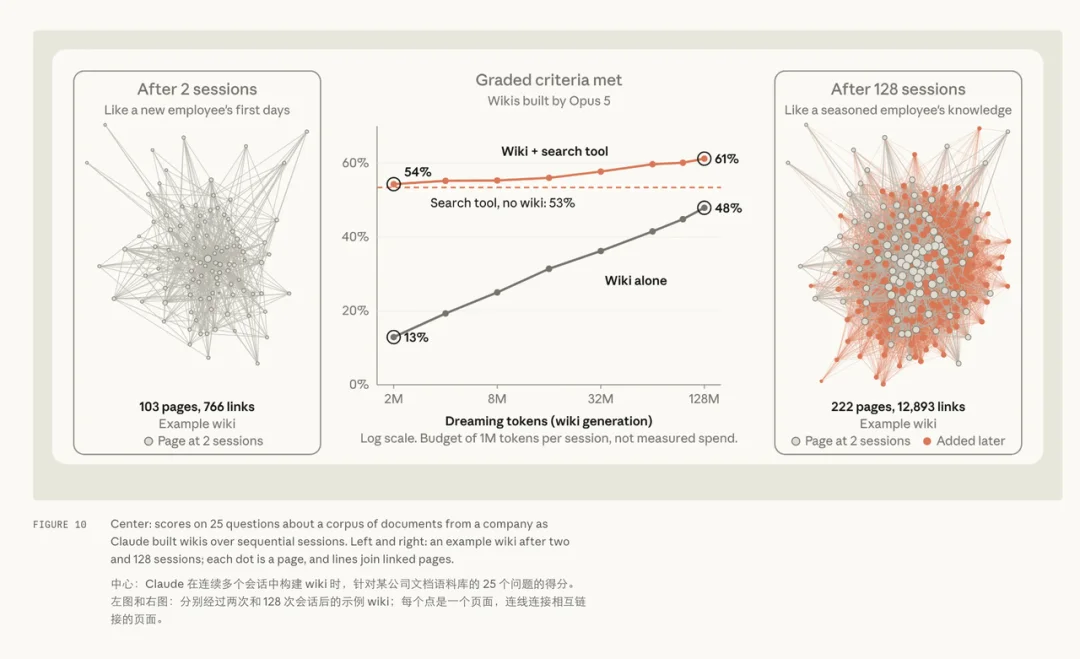
他们用一个内部文档语料库做了实验 —— 来自 Stainless(一家他们五月收购的软件公司),大约 35 万个文件、约 4.2 亿 token。他们出了 25 道关于这个语料库的题,给 Claude 配了搜索工具,同时让它基于这些文件用做梦来建 wiki。128 个会话里,Opus 5 智能体们探索文件、撰写或更正互链的 wiki 页面、合并重复页面、拿论断对照原文。每个会话都在前一个的进度上继续,靠共享日志协调。
做梦的规模从 2 个会话扩到 128 个,25 道题上达成的评分标准比例从 13% 涨到了 48%。
Claude 建 wiki 是渐进式的:先建个初版,再靠后续一轮轮做梦增补、编辑、修剪。做梦早期,Claude 的知识像新员工,光靠 wiki 答题能力有限;梦做得越多,知识地图越丰富,像老员工。实验还发现,wiki 配上搜索工具时帮助最大:搜索加 wiki,总分从 54% 涨到 61%;只用搜索是 53%;只用 wiki 最好成绩是 48%。而且搜索加 wiki 的组合,每道题还省大约两万个 token。
那什么样的任务更吃 wiki 这一套?他们用 Harvey LAB 基准加一批并购文件做了测试:给 Claude 一组文件,让它生成法律简报,再按标准清单打分 —— 没宝可梦好玩,但文档种类多样。
一个测试问了 24 道关于并购的问题,一半以上需要跨多份文件找信息,很多还要用判断力或算数。在这类题上,查 wiki 的 Claude 拿了 87%,只用搜索的只有 73%。
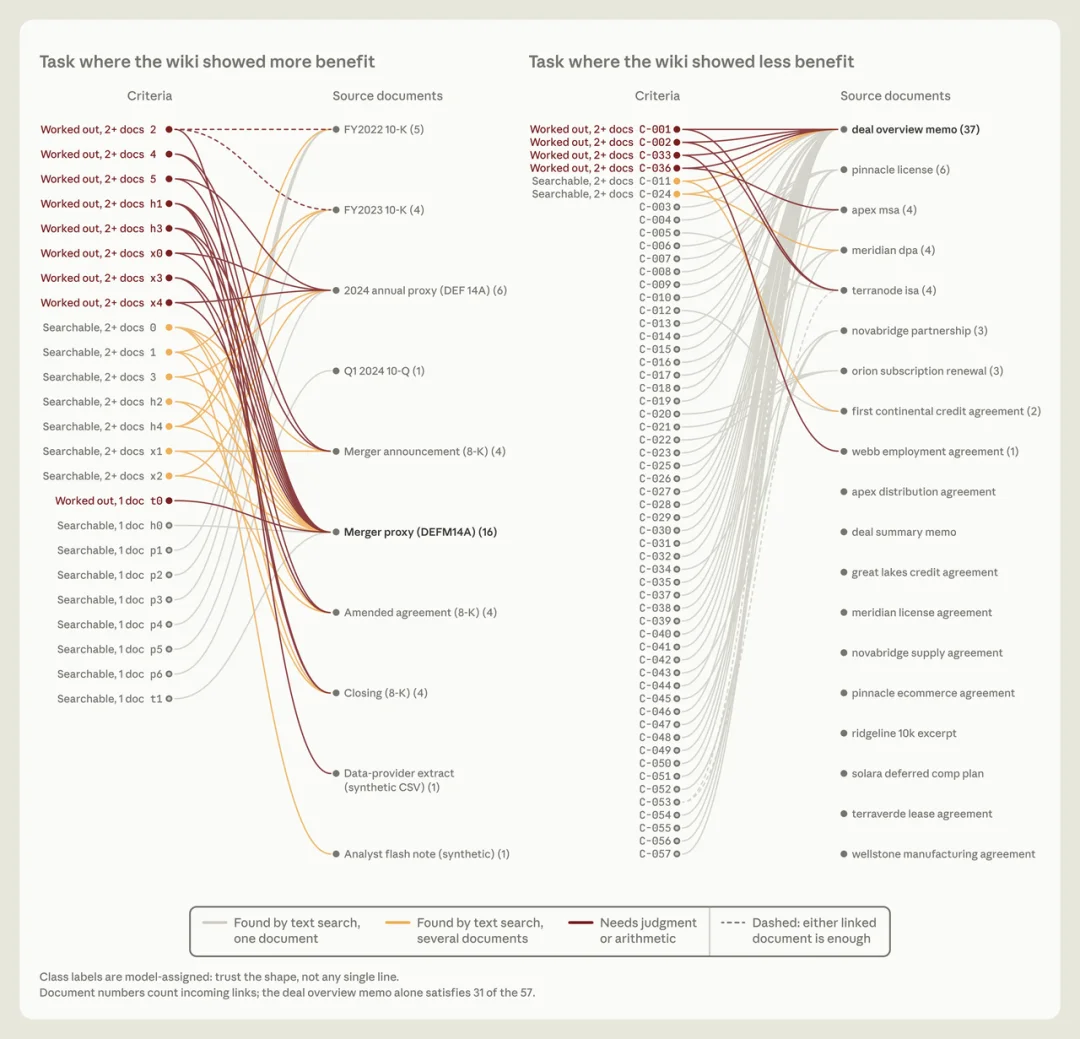
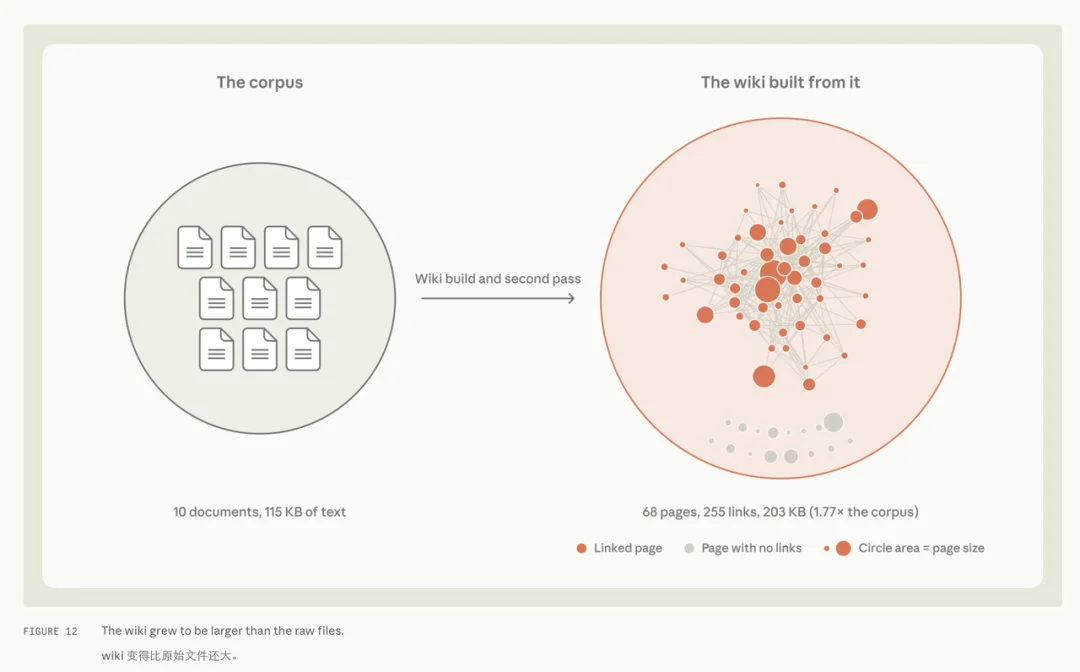
但 wiki 也有不灵的时候。另一个 LAB 任务里,简报的评分点往往能在单一文件里直接搜到,wiki 相对搜索没有明显增益。还有个任务更夸张:wiki 长得比原始文件还大 —— 语料 10 份文档、115KB,wiki 却有 68 页、203KB,是语料的 1.77 倍。就像博尔赫斯那篇一段话的小说《论科学的精确性》里的地图师,画了张和帝国一样大的地图 ——Claude 做了个极度详细的 wiki,实际上什么都没抽象出来。
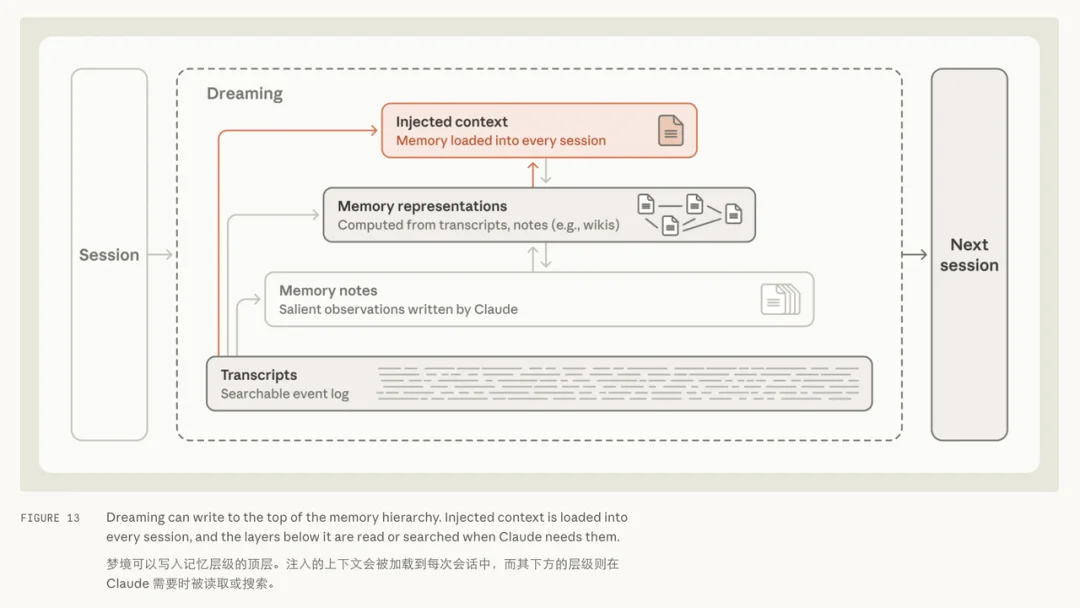
做梦还能把笔记「浮」到记忆层级的顶端,由智能体框架在每次会话开始时预先加载进 Claude 的上下文。这意味着 Claude 不用去搜,甚至不用知道「有东西可搜」。
但把记忆注入新会话(一种上下文注入)得小心:注入的记忆占用宝贵的 token,一条错笔记会被带进每个会话;加载了也不等于 Claude 会照做 ——Claude Code 的文档就警告过,指令文件越长,遵守度越低。所以层级顶端必须保持小而精,做梦在这里的很多工作就是「维持它小」:把细节往下层挪,只留下链接。
Claude Code 的自动记忆也是这个思路:它不会把整个自动记忆都加载进每个会话,只加载 MEMORY.md 的前 200 行或 25KB。这个开头部分充当索引,告诉 Claude 它知道什么、去哪儿找。
做梦还能塑造记忆的生长方向。比如像 Claude Duet 这样的助手,记忆围着被帮助的人组织往往更有用,而做梦可以被调成「为特定目标服务」的建记忆模式。
引导记忆生长的指令因任务而异,它告诉 Claude 什么信息才真正重要。LAB 基准里有个模拟公司收购的任务,给一批合同,简报按是否正确描述合同条款打分。
一开始,建 wiki 的指令很基础,没告诉 Claude 怎么用 wiki。这个任务重度依赖合同条款,而建 wiki 时,好几个智能体同时往一张共享的合同条款表里写 —— 结果互相覆盖,表总结得不好,还漏条款。用这份 wiki 生成的简报,57 个评分事实只覆盖了 41 个(72%)。
合同条款明明是 wiki 里最重要的部分,但指令没说。于是他们跑了一个循环:让 Claude 反思失败、提出指令修改方案、重建 wiki。这个循环让 Claude 自己发现了合同条款的重要性,并相应重写了建 wiki 的指令。
改完之后:每份合同有自己的页面,由单个智能体撰写,条款逐字引用而不是汇总进共享表。用改进版 wiki 生成的简报,评分标准覆盖率从 72% 升到了 100%。
Claude 写记忆笔记时,只看得到那一个会话的上下文。做梦则能跨多个会话检索,发现共性模式、纠正共性错误。
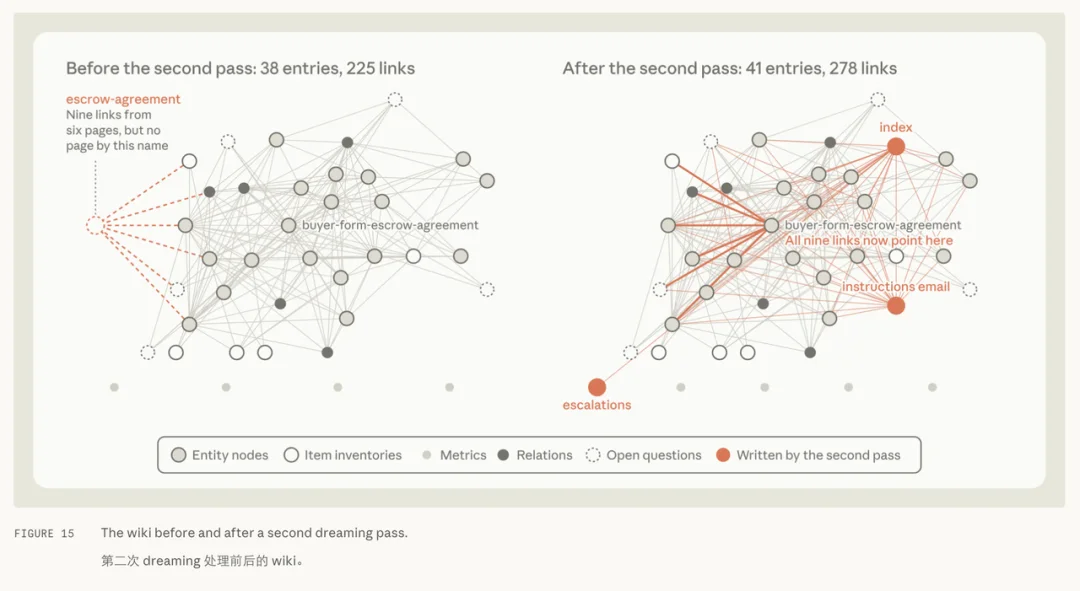
建 LAB 基准的 wiki 时,Claude 有时会链接到还没创建的页面。第二轮做梦补上了不少这类缺口:有个任务里,做梦发现 wiki 里有九个链接指向一个不存在的页面,把它们全部重定向到了同一份文档的现有页面,还顺手加了三个新页面(包括一个索引页),把 wiki 织得更密了。
一个是什么时候该建记忆。边干活边写,能在源头抓住「什么重要」,让重要细节立刻可用,但记笔记本身会分散 Claude 对主任务的注意力;做梦则把记忆创建推到后台,但做梦的产出不一定能马上被 Claude 用到。
另一个是怎么让记忆可靠地保鲜。Claude 可能做出错误预测,或者写下一条从一开始就错的规则;记忆也会随环境变化而漂移、失效。做梦是修正手段之一,但它要算力。让 Claude 不停检查所有记忆不现实,也许更该把做梦对准那些容易变的信息,或者精心调节做梦的节奏(比如按记忆被访问的频率)。
还可以把记录检索当作记忆的地基。表征(如 wiki)加搜索有时确实有效,但维护记忆表征要算力,还得保证它们不累积错误和幻觉。
即便 Claude 判断「什么重要」的能力进步了,也没有哪个模型真能预知未来。做梦给了 Claude 一个往回看的机会 —— 用算力整理记忆、修正错误、维护表征,让未来的会话更容易取用。记忆系统会随 Claude 的能力一起进化,而怎么设计 Claude 的记忆系统,他们要学的还有很多。
文章来自于"机器之心",作者 "机器之心编辑部"。

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
