
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
现如今,搜索、推荐已经成了很多互联网产品的基础功能。内容产品需要“搜一搜”和“猜你喜欢”,电商需要相似商品,社区需要找到兴趣接近的人。即使是内部知识库,也经常需要同时解决关键词查找和语义查找。
但不是每个团队都会专门配备搜索推荐工程师。最终,这些需求通常落到并没有完整搜广推经验的后端工程师手里。
这篇文章面向的就是这样的团队。
接下来,我们用Claude Code、嵌入模型(文本变向量,起步用哈希凑数,后面换成真模型)、FastAPI (主要使用八个读写接口加一个单文件前端)和 Milvus(负责向量存储、语义检索、标量过滤以及BM2检索,从一台笔记本开始,逐步实现搜索推荐服务,再处理集群迁移和效果评测。整个系列分为四篇:
第一篇:搭建本地系统。实现关键词搜索、语义搜索、个性化推荐和相似用户查询,搭配一个可以操作的演示页面。
第二篇:接入 Milvus 集群。沿用已有实现,处理远程读写、一致性、租户隔离和监控。
第三篇:验证并改善推荐效果。建立评测,加入物品共现召回,再检验融合与精排是否需要上线。
本篇先完成本地系统搭建。
开始实操前,本地需要安装 Python 3.10 或更新版本,以及已经可以使用的 Claude Code。在一个空项目目录中启动 Claude Code,后面的代码和数据都放在这个目录里。
基础依赖包括 FastAPI、Uvicorn 和带 Milvus Lite 的 PyMilvus:
python -m pip install fastapi uvicorn "pymilvus[milvus-lite]"
FastAPI 提供 HTTP 接口,Uvicorn 启动服务。PyMilvus 是操作 Milvus 的 Python 客户端,Milvus Lite 则让我们通过本地数据库路径使用检索能力,不必先部署独立数据库。
后面加入语义检索时,还需要安装 sentence-transformers。
演示数据使用 MovieLens-1M,包含约一百万条评分、6,040 个用户,以及电影标题和类型信息。如果需要换成商品、文章或其他业务对象时,只需更新物品文本、用户行为和过滤规则即可。
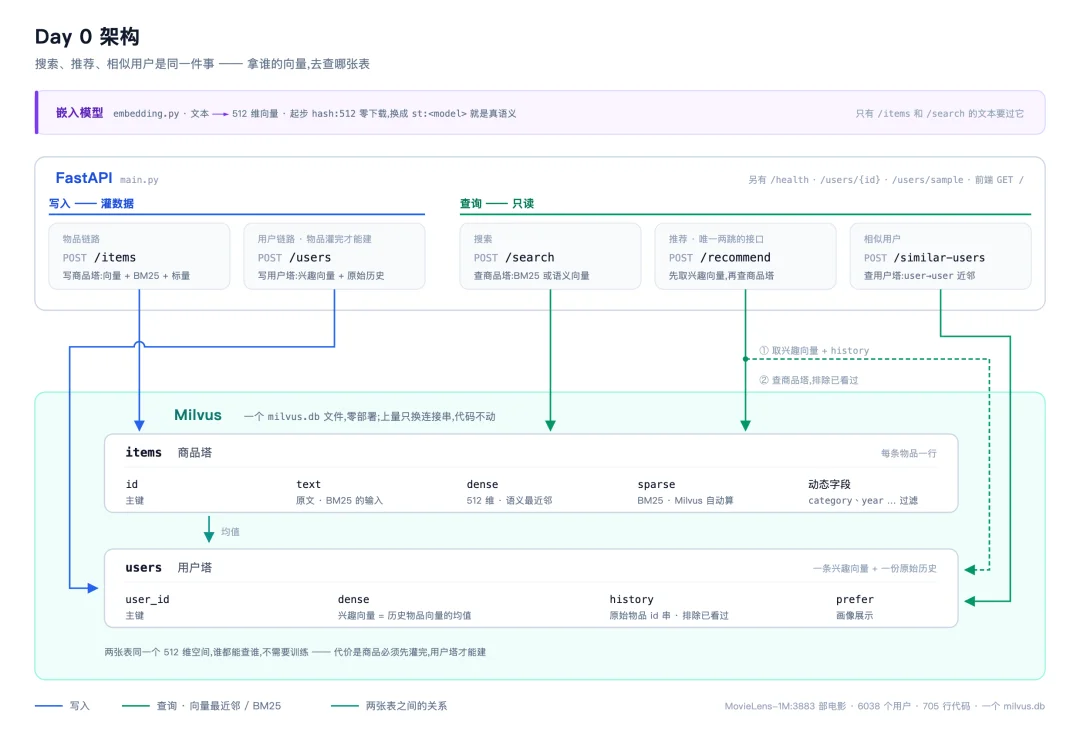
搜索、推荐和相似用户,可以共用一套存储与服务,只是查询方式不同。
常规搜索会使用关键词搜索根据文本匹配结果排序,或者使用语义检索把查询和物品文本编码成向量,再寻找接近的物品;内容推荐,则是用用户历史构建兴趣向量,查询物品;相似用户则是用同一个兴趣向量查询其他用户。
围绕着搜索推荐和相似用户这三个需求,整体的架构设计上,我们可以建立两个集合:items 保存电影及其向量,users 保存用户兴趣向量。语义搜索把查询文本编码成向量后查 items;推荐用用户兴趣向量查 items;相似用户用同一个兴趣向量查 users。
关键词搜索保留 BM25,用来处理片名等明确词语。它不需要 embedding 模型,可以先单独实现。
代码也按这几个职责组织:embedding.py 负责编码,store.py 负责 Milvus 读写,main.py 用 FastAPI 提供接口。我们先用哈希向量验证接口和数据流,随后换成真实模型。
接下来进入实操阶段。
第一步只做关键词搜索,暂时不加载模型。这样可以先检查写入、查询和过滤,避免数据问题与模型问题混在一起。另外,这里的BM25 的稀疏表示交给 Milvus 的 Function 生成,应用只负责提交文本,不需要自己计算。
items 中保存 id、text 和 sparse。text 开启 analyzer,决定文本如何分词;sparse 由 Milvus 的 BM25 Function 从文本生成,写入方不需要自己计算。
分类、年份先通过动态字段随记录保存,用它们验证过滤。这样可以先确认搜索与业务条件能一起工作。
把下面的提示词交给 Claude Code:
用 FastAPI + Milvus Lite(pymilvus 的 MilvusClient)做一个关键词搜索服务。
store.py:集合 items,字段 id、text、sparse。text 开 analyzer,用环境变量 TEXT_ANALYZER
选中英文;开 dynamic field,让 category、year 这类字段原样存、能过滤。
sparse 不要自己算,用 Milvus 原生的 BM25 Function 从 text 生成。
连接串走 MILVUS_URI,默认本地文件。
main.py:批量写入、搜索、健康检查三个接口。顺带写 requirements.txt。
先写两条容易人工判断的样本。服务在终端 A 持续运行,写入和查询在终端 B 执行:
pip install -r requirements.txt
TEXT_ANALYZER=english uvicorn main:app # 终端 A,服务在 127.0.0.1:8000
# 终端 B
J='Content-Type: application/json' # 后面几步的验证命令都会用到它
curl -s localhost:8000/items -H "$J" -d '[
{"id":"1","text":"Interstellar space travel through a wormhole","category":"Sci-Fi","year":2014},
{"id":"2","text":"Toy Story toys come alive","category":"Animation","year":1995}]'
# {"upserted":2}
curl -s localhost:8000/search -H "$J" -d '{"q":"space","top_k":2}'
# 只回 id=1,score 0.66 —— 这是 BM25 分,不是相似度
curl -s localhost:8000/search -H "$J" -d '{"q":"toys","top_k":2,"filter":"year > 2000"}'
# [] —— Toy Story 是 1995,被 year 过滤掉了
这几次请求分别检查写入、搜索和过滤。
space 应命中第一部电影;toys 原本能够匹配第二部,但加上年份条件以后应被排除。year 没有预先声明在 schema 中,仍能参与过滤,说明动态字段已经保存并用于查询。
示例中的 BM25 分数用于展示返回形式,不解释成相关概率。这里验收的是查询行为,不需要对照小数点。
如果这一步没有得到预期结果,先检查数据、分词和过滤条件。它们确认以后,再加入向量能力。
接下来给 items 增加 dense 字段,再建立 users 集合。
用户兴趣先取历史物品向量的均值,预先算好后保存。推荐时读取这个向量查物品;相似用户则用它查其他用户。这里所谓的“用户塔”,就是这份预计算的兴趣表示。如果是训练独立用户模型的话,成本就会比较大。
编码暂时使用哈希:把词映射到固定维度,再归一化。它不需要下载模型,足够验证编码、写入、检索和历史排除是否连通。真实语义效果留到替换模型后检查。
本例先使用 512 维,与后面常见的 384 维小模型(bge-small、MiniLM)区分开,便于发现这次模型切换。画像和采样接口也在这一步补上,用于查看用户状态、选择演示对象。
Prompt:
加向量能力。
embedding.py:encode(texts) 和 dim()。先只做 hash 后端——把词散列到一个固定维度再归一化,
不下任何模型,留好换真模型的位置。维度别挑 384,跟常见小模型撞上了换模型时发现不了。
items 加一个 dense 字段,/search 加 mode 参数选走 sparse 还是 dense。
再建一个 users 表:兴趣向量 = 历史物品向量的均值,预先算好存进去。
接口补上:推荐(给 user_id 用存好的向量、给 item_ids 就现算)、相似用户、画像、采样。
用户塔依赖商品向量,所以要先灌完商品再建。
第一步的集合没有 dense 字段,下面重建本地测试库,再写入四条样本。
先停止终端 A 的旧服务,然后执行删除和重启;这时库里只有可以重新写入的演示数据。
写入顺序是先物品、后用户,因为构建兴趣向量时需要读取历史物品向量:
rm -rf milvus.db
TEXT_ANALYZER=english uvicorn main:app # 终端 A
# 终端 B
J='Content-Type: application/json'
curl -s localhost:8000/items -H "$J" -d '[
{"id":"1","text":"Interstellar space travel through a wormhole"},
{"id":"2","text":"Toy Story toys come alive"},
{"id":"3","text":"Star Wars rebels fight the empire in space"},
{"id":"4","text":"Finding Nemo animated fish adventure"}]'
curl -s localhost:8000/users -H "$J" -d '[
{"user_id":"u1","history":["1","3"],"prefer":"Sci-Fi"},
{"user_id":"u2","history":["2","4"],"prefer":"Animation"}]'
# {"upserted":2,"skipped":[]} —— 用户塔建起来了;skipped 是 history 里一个物品都不认识的用户
curl -s localhost:8000/search -H "$J" -d '{"q":"space","mode":"vector","top_k":2}'
# 走 dense 了:id=1、id=3
curl -s localhost:8000/recommend -H "$J" -d '{"user_id":"u1","top_k":2}'
# 剩下 id=2 和 id=4 —— u1 看过的 1 和 3 被排掉了,这是这一步唯一要确认的事
#(两条分数都是 0.0,谁在前面不固定,别对着顺序较真)
curl -s localhost:8000/recommend -H "$J" -d '{"item_ids":["3"],"top_k":2}'
# 不用建用户也能推:现算这批物品的均值
curl -s -X POST "localhost:8000/similar-users?user_id=u1&top_k=1"
# [{"user_id":"u2",...}]
四条样本只用于检查行为,不能用于评价推荐的成效。因为u1 的历史是 1 和 3,推荐结果不应再包含这两个物品。此时剩下的候选就只有两条动画片候选,无法说明兴趣计算是否成功。
哈希向量的具体分数也取决于实现,不必对照示例检查小数。进入真实模型前,优先处理写入失败、无有效历史、排除失效等明确问题。
接口跑通以后,数据换成 MovieLens-1M,让每个用户都有一段实际评分历史。
这里数据准备与导入分开。data/load_movielens.py 负责下载 MovieLens-1M,转换成物品和用户 CSV;seed.py 读取这两份文件,先导入物品,再生成用户兴趣向量。
电影文本使用标题加类型。第一版用户数据保留评分不低于 4 分的最近 50 部电影,用来较快生成画像。原始评分文件继续保留,后续评测会重新使用。
Prompt:
data/load_movielens.py:下载 MovieLens-1M,转成两个 csv。
products.csv 一部电影一行(id、标题+类型词、主类型、年份),
users.csv 一个用户一行(id、看过的电影 id 列表、最常看的类型)。
seed.py:读 csv 分批灌进去,最后跑一次搜索、推荐、相似用户当冒烟测试。
停止旧服务后,清理样本库,转换数据,再启动服务并导入:
rm -rf milvus.db # milvus-lite 3.x 下它是个目录,-r 不能省
python data/load_movielens.py # 3883 部电影 / 6038 个用户
TEXT_ANALYZER=english uvicorn main:app # 终端 A
python seed.py # 终端 B:灌数据 + 冒烟测试
curl -s localhost:8000/health
# {"analyzer":"english","embed":"hash:512","items":3883,"users":6038} —— 两张表都灌满了
curl -s localhost:8000/search -H "$J" -d '{"q":"star wars","top_k":2}' \
| jq -r '.[]|"\(.score|.*100|round/100) \(.text)"'
# 7.83 Star Wars: Episode IV - A New Hope (1977) ...
# 7.83 Star Wars: Episode I - The Phantom Menace (1999) ...
导入结束后,先核对电影数、用户数和当前后端。这里的 6038 是这版数据处理后成功生成画像的用户数,不等于原始数据的用户总数。
seed.py 最后的冒烟测试同时调用三个功能,确认真实数据已经进入服务:
[搜索] BM25 'Star Wars'
7.83 Star Wars: Episode IV - A New Hope (1977) Action Adventure Fantasy Sci-Fi
7.83 Star Wars: Episode I - The Phantom Menace (1999) Action Adventure Fantasy Sci-Fi
[推荐] u1 —— 排除历史
0.657 Babe (1995) Children's Comedy Drama
0.629 Wide Awake (1998) Children's Comedy Drama
[相似用户] u1
u4767 (Drama, 0.908) · u413 (Drama, 0.897) · u5887 (Drama, 0.896)
此时推荐和相似用户仍使用哈希向量,结果主要反映词面和类型词关系。接下来替换 embedding.py 后端,其余接口和导入脚本继续使用。
sentence-transformers 负责加载真实模型,通过环境变量选择后端和模型。第一次启动需要下载模型,之后在本地运行。模型名称由 EMBED_MODEL 指定,下列示例按 384 维模型展示,实际维度以所选模型为准。
Prompt:
embedding.py 加一个 st 后端:sentence-transformers 本地模型,用环境变量切换和指定模型。
维度和现在的对不上时自动重建集合。
下面沿用本地演示的重建方式。停止旧服务后启动新后端,再重新运行 seed.py。重建会清除旧向量,物品和用户画像都要重新生成。
pip install sentence-transformers
EMBED_BACKEND=st TEXT_ANALYZER=english uvicorn main:app # 终端 A
# 启动时会打印:dense 维度 512 -> 384,重建集合 —— 不用手动删库
python seed.py # 终端 B:用模型重新编码一遍
# 用一句不含任何片名的话搜
curl -s localhost:8000/search -H "$J"\
-d '{"q":"mind-bending movie about space and time","mode":"vector","top_k":5}' \
| jq -r '.[]|"\(.score|.*1000|round/1000) \(.text)"'
示例结果如下:
0.727 Destination Moon (1950) Sci-Fi
0.723 Timecop (1994) Action Sci-Fi
0.713 Black Hole, The (1979) Sci-Fi
0.709 Time Masters (1982) Animation Sci-Fi
0.7072001: A Space Odyssey (1968) Drama Mystery Sci-Fi Thriller
查询没有指定片名,模型根据描述寻找相关电影。这时可以把相同查询交给 BM25,观察两种检索方式的差别。
这里可以看到物品文本只有标题和类型,模型能够利用的信息有限,不能指望它可靠理解每部电影的完整情节。
再检查同一用户的推荐,确认用户画像也已随模型重新计算:
curl -s localhost:8000/recommend -H "$J" -d '{"user_id":"u1","top_k":2}' \
| jq -r '.[]|"\(.score|.*1000|round/1000) \(.text)"'
# 0.87 Parent Trap, The (1998) Children's Drama
# 0.868 Jungle Book, The (1967) Animation Children's Comedy Musical
这一步通过的条件是:真实模型完成编码,物品和用户使用同一套向量表示,三个功能仍然能够工作。几条看起来合理的结果还不足以证明整体推荐质量,后续文章会单独建立评测。
另外,维度检查不能发现所有模型切换。例如 bge-small-en-v1.5 和 MiniLM-L6-v2 都是 384 维,更换模型后,如果库里仍保留旧向量,维度检查不会报错。
因此需要记录“这批向量由谁生成”,例如在库旁保存 st:<模型名>:<维度>,启动时与当前配置比较。这里可以先使用本地文件;多实例环境下怎样保存和核对,留到集群迁移时处理。
最后配一个简单页面,把搜索、推荐、相似用户和物品写入放在一起。
页面的作用是让输入与结果便于对照:查看推荐时能看到用户历史,搜索时知道当前模式,写入失败时能够直接发现。暂时不需要引入前端框架。
Prompt:
给这个服务配个网页,能演示搜索、推荐、相似用户这几个功能,
最好还能现场加一部电影马上搜到它。不用框架,简单点就行,能截图演示就够。
打开 http://127.0.0.1:8000/,新增一部电影,再检索它、把它作为推荐种子。也可以继续使用命令行:
curl -s -o /dev/null -w '%{http_code}%{content_type}\n' localhost:8000/
# 200 text/html; charset=utf-8 —— 前端被后端托管着
# 写一部数据集里没有的电影,立刻搜得到
curl -s localhost:8000/items -H "$J"\
-d '[{"id":"m9999","text":"Interstellar (2014) Sci-Fi Drama"}]'
curl -s localhost:8000/search -H "$J" -d '{"q":"Interstellar","top_k":1}' \
| jq -r '.[]|"\(.score|.*100|round/100) \(.text)"'
# 8.44 Interstellar (2014) Sci-Fi Drama —— 第一
# 刚写的这部电影也立刻进了推荐池:拿它自己当种子,现算向量去召回同类
curl -s localhost:8000/recommend -H "$J" -d '{"item_ids":["m9999"],"top_k":3}' \
| jq -r '.[]|"\(.score|.*1000|round/1000) \(.text)"'
# 0.814 Close Encounters of the Third Kind (1977) Drama Sci-Fi
# 0.805 Delta of Venus (1994) Drama
# 0.793 Conceiving Ada (1997) Drama Sci-Fi
这次操作把写入、编码和查询连在了一起。新内容不需要重新训练模型,就能进入搜索与内容推荐。
最后重启服务,检查这条记录是否仍在。确认持久化以后,这个本地 Demo 就形成了完整闭环:电影可以写入和检索,用户历史可以生成兴趣向量,同一份兴趣表示可以用于推荐和相似用户查询,页面可以展示整个过程。
如果要换成自己的业务数据,可以先沿用当前接口,替换物品文本和用户历史,观察输入是否足够、过滤是否符合业务、结果是否值得继续验证。下一篇再把这份实现迁到独立服务,检查远程调用、一致性和多租户带来的变化。
王祥丨Teamily ML Infra Engineer
文章来自于"Zilliz",作者 "王祥"。

【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
