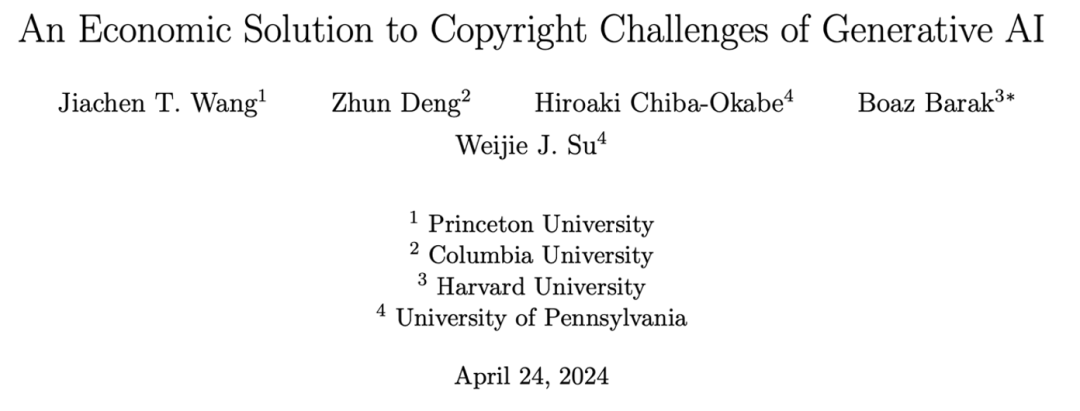
AI训练数据的版权保护:公地的悲剧还是合作的繁荣?
AI训练数据的版权保护:公地的悲剧还是合作的繁荣?就算是 OpenAI 在舆论场也无法逃过版权保护的呼声。
来自主题: AI技术研报
10472 点击 2024-06-04 18:04

 搜索
就算是 OpenAI 在舆论场也无法逃过版权保护的呼声。
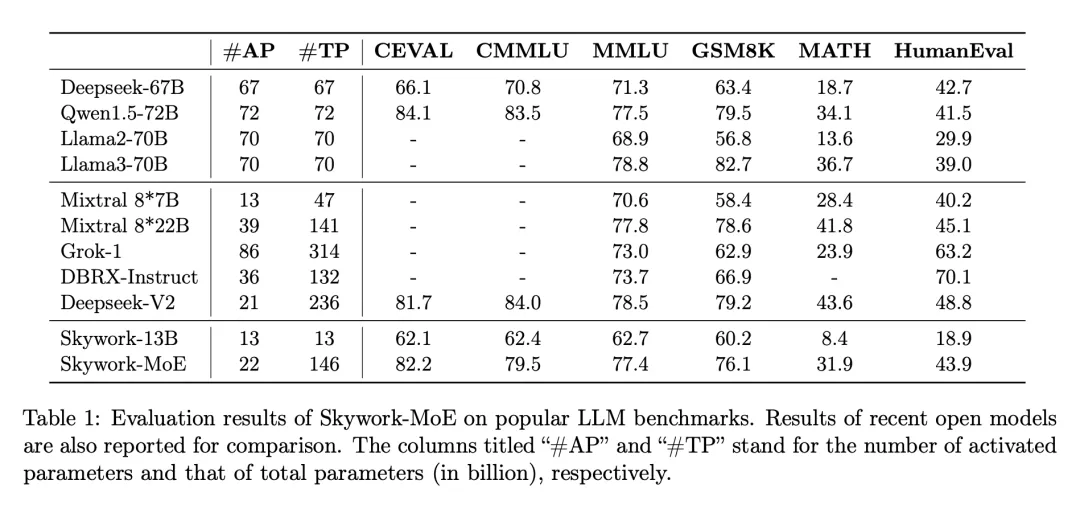
在大模型浪潮中,训练和部署最先进的密集 LLM 在计算需求和相关成本上带来了巨大挑战,尤其是在数百亿或数千亿参数的规模上。为了应对这些挑战,稀疏模型,如专家混合模型(MoE),已经变得越来越重要。这些模型通过将计算分配给各种专门的子模型或「专家」,提供了一种经济上更可行的替代方案,有可能以极低的资源需求达到甚至超过密集型模型的性能。
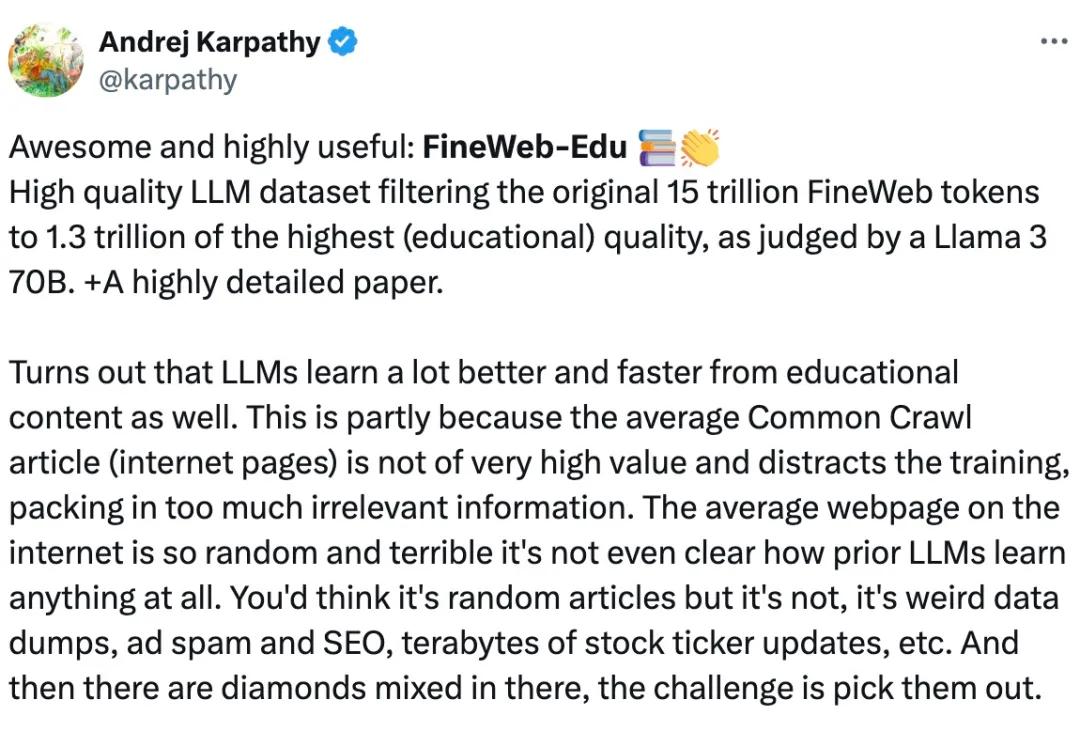
众所周知,对于 Llama3、GPT-4 或 Mixtral 等高性能大语言模型来说,构建高质量的网络规模数据集是非常重要的。然而,即使是最先进的开源 LLM 的预训练数据集也不公开,人们对其创建过程知之甚少。
你方唱罢我登场。
自 2017 年被提出以来,Transformer 已经成为 AI 大模型的主流架构,一直稳居语言建模方面 C 位。
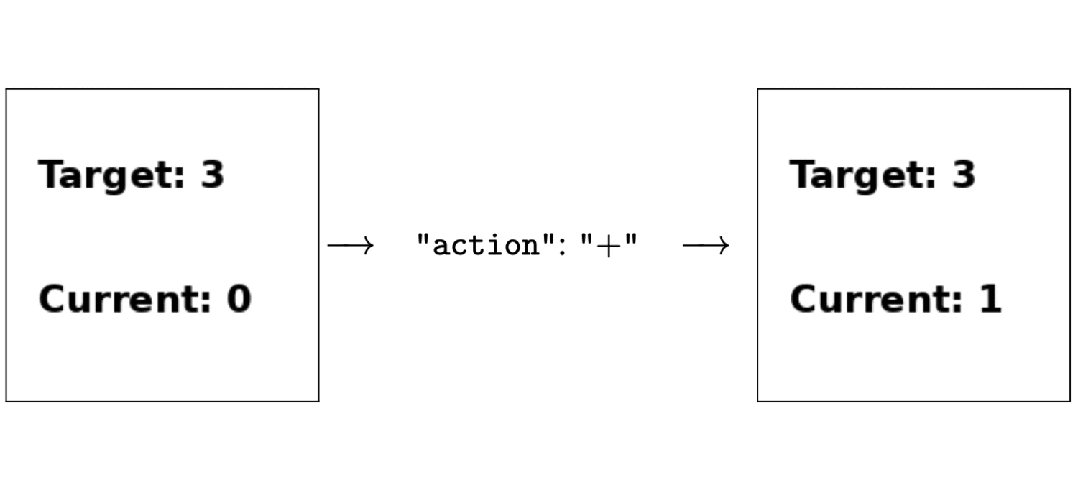
只用强化学习来微调,无需人类反馈,就能让多模态大模型学会做决策!
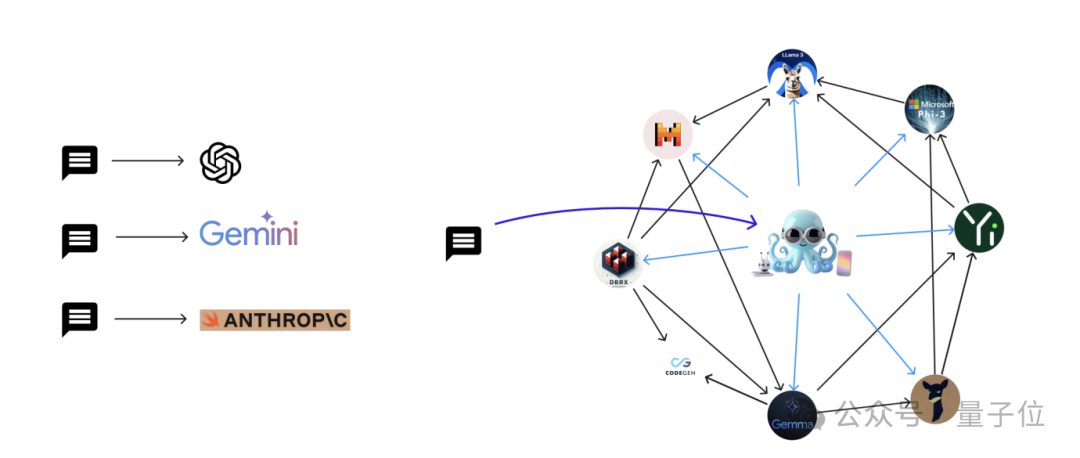
大模型,大,能力强,好用!

最近发现一些AI行业里人才能力圈的有趣的变化,越来越多在一些AI公司里扛大旗的,不仅仅是某一个领域的专家,而且是绝对的斜杠青年。

Transformer挑战者、新架构Mamba,刚刚更新了第二代:
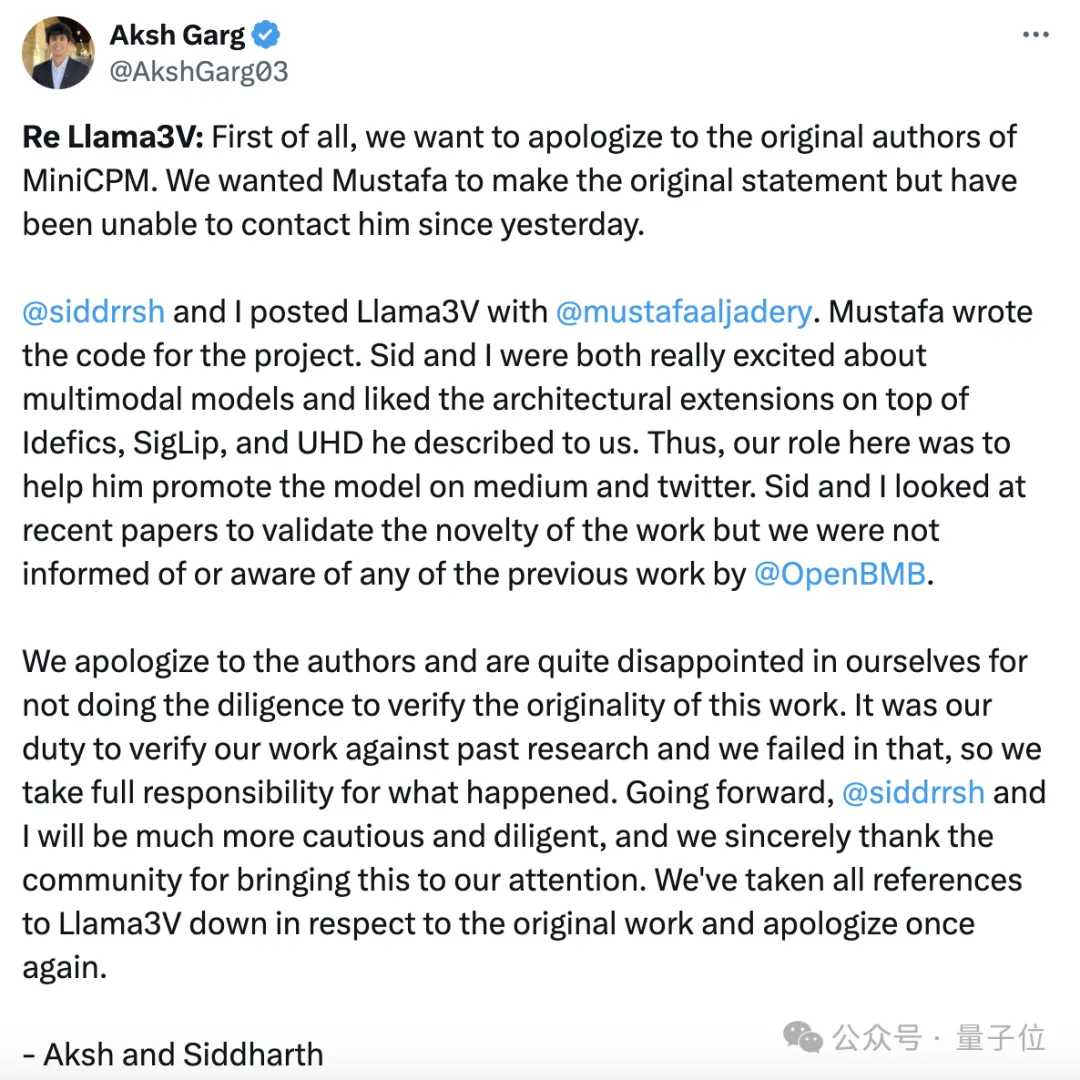
斯坦福团队抄袭清华系大模型事件后续来了—— Llama3-V团队承认抄袭,其中两位来自斯坦福的本科生还跟另一位作者切割了。