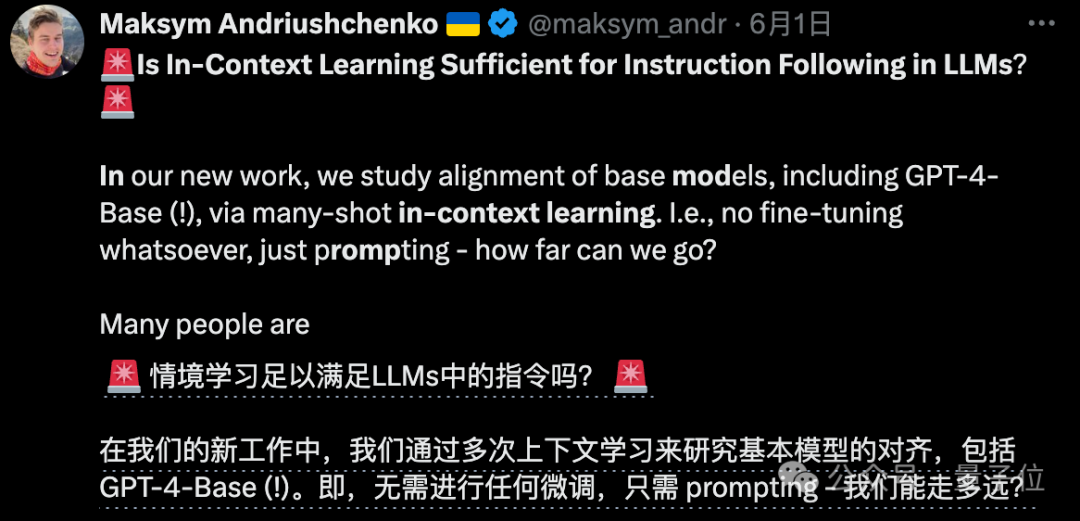
OpenAI把GPT-4原始版给了他们:研究不微调只靠提示词能走多远
OpenAI把GPT-4原始版给了他们:研究不微调只靠提示词能走多远除了OpenAI自己,居然还有别人能用上GPT-4-Base版??
来自主题: AI技术研报
9673 点击 2024-06-03 15:46

 搜索
除了OpenAI自己,居然还有别人能用上GPT-4-Base版??
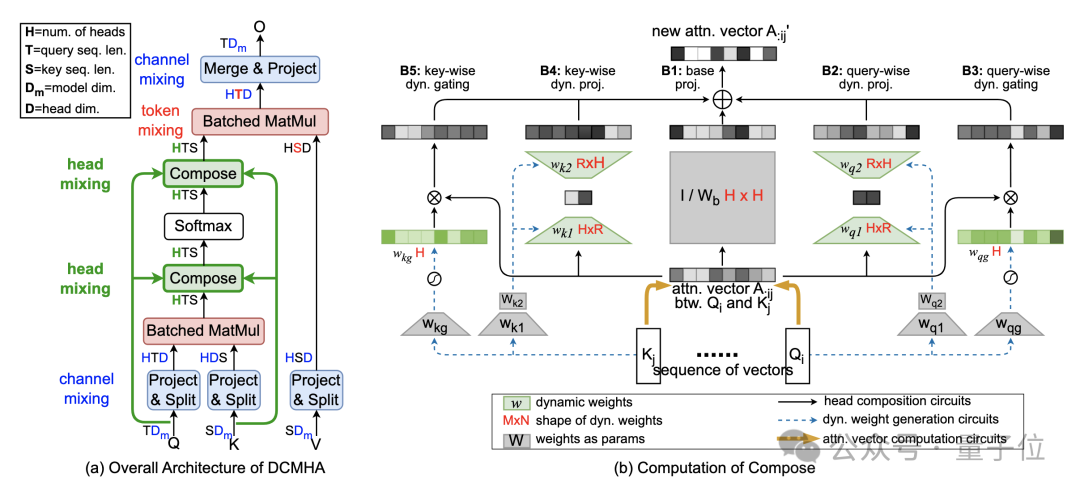
改进Transformer核心机制注意力,让小模型能打两倍大的模型!
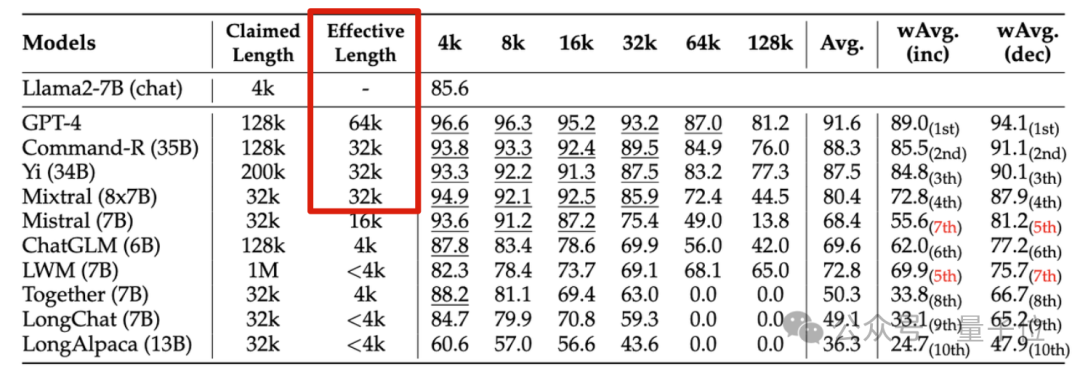
无情戳穿“长上下文”大模型的虚标现象
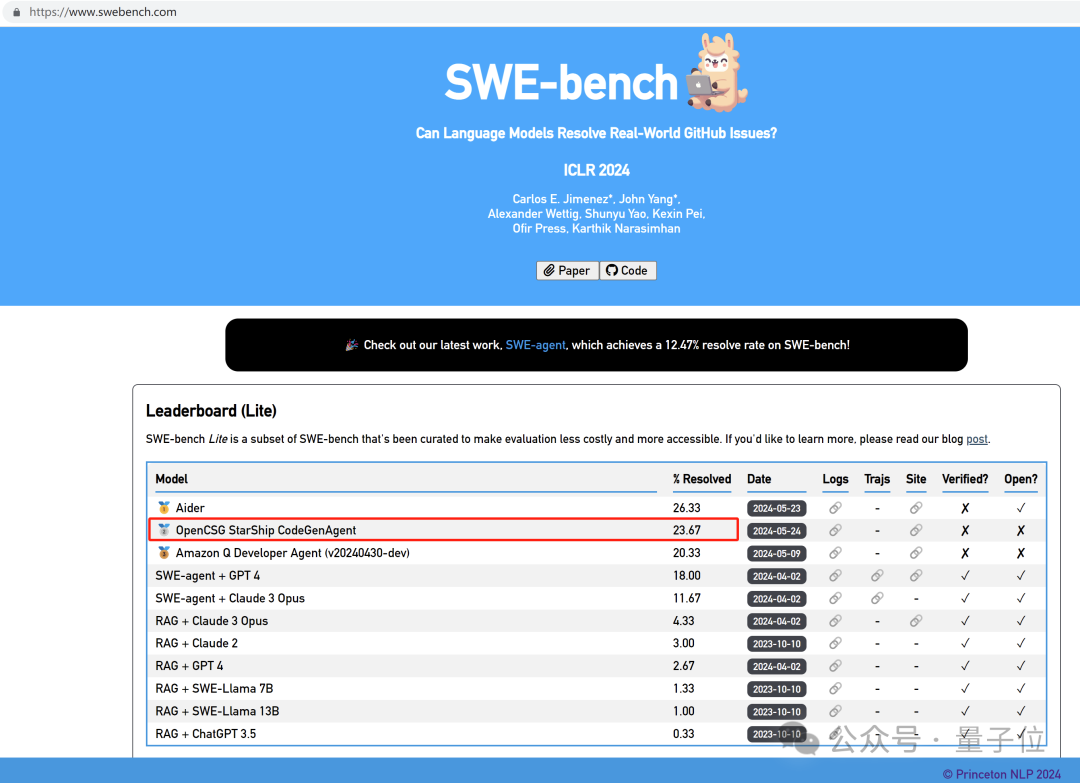
超越Devin!SWEBench排行榜上迎来了新玩家
我是万万没想到,现在的AI内容生态,居然也活成了一种“赛博投喂”的无限循环。

工业革命就注定会有钢铁、石油、铁路巨头。互联网也注定会有搜索、电商、即时通讯。历史性变革催生历史性机会,而这种历史性机会往往内置技术的特征。技术特征决定了机会是什么,甚至也决定了机会的先后。
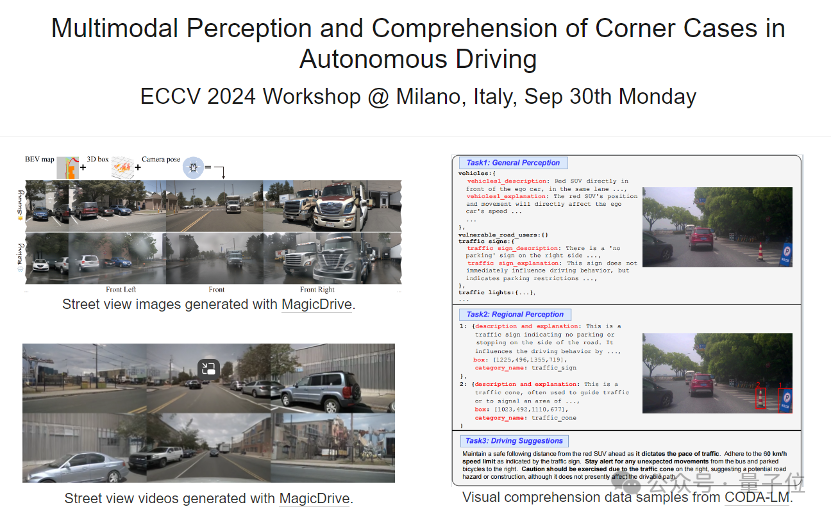
多模态,已经成为大模型最重要的发展方向之一。
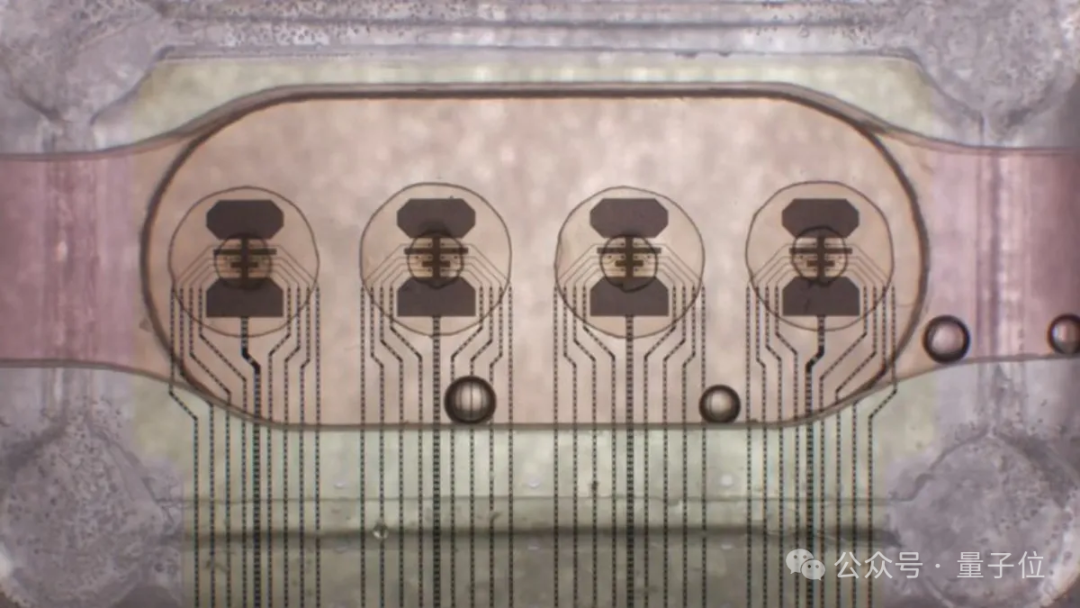
首个“脑PU”来了!由“16核”类人脑器官(human brain organoids)组成。
刚刚,中国台湾大学体育场,欢呼阵阵如同演唱会,但这次“摇滚巨星”,其实是英伟达创始人黄仁勋,再次回到学校,带来Computex重磅演讲,以及英伟达的新一代GPU。
研究人员提出了一种新的大型语言模型训练方法,通过一次性预测多个未来tokens来提高样本效率和模型性能,在代码和自然语言生成任务上均表现出显著优势,且不会增加训练时间,推理速度还能提升至三倍。