
开源15T tokens!HuggingFace放出规模最大、质量最高预训练数据集
开源15T tokens!HuggingFace放出规模最大、质量最高预训练数据集Meta最近开源的Llama 3模型再次证明了「数据」是提升性能的关键,但现状是,开源的大模型有一堆,可开源的大规模数据却没多少,而收集、清洗数据又是一项极其费时费力的工作,也导致了大模型预训练技术仍然掌握在少数高端机构的手中。
来自主题: AI技术研报
7670 点击 2024-05-05 19:51

 搜索
Meta最近开源的Llama 3模型再次证明了「数据」是提升性能的关键,但现状是,开源的大模型有一堆,可开源的大规模数据却没多少,而收集、清洗数据又是一项极其费时费力的工作,也导致了大模型预训练技术仍然掌握在少数高端机构的手中。
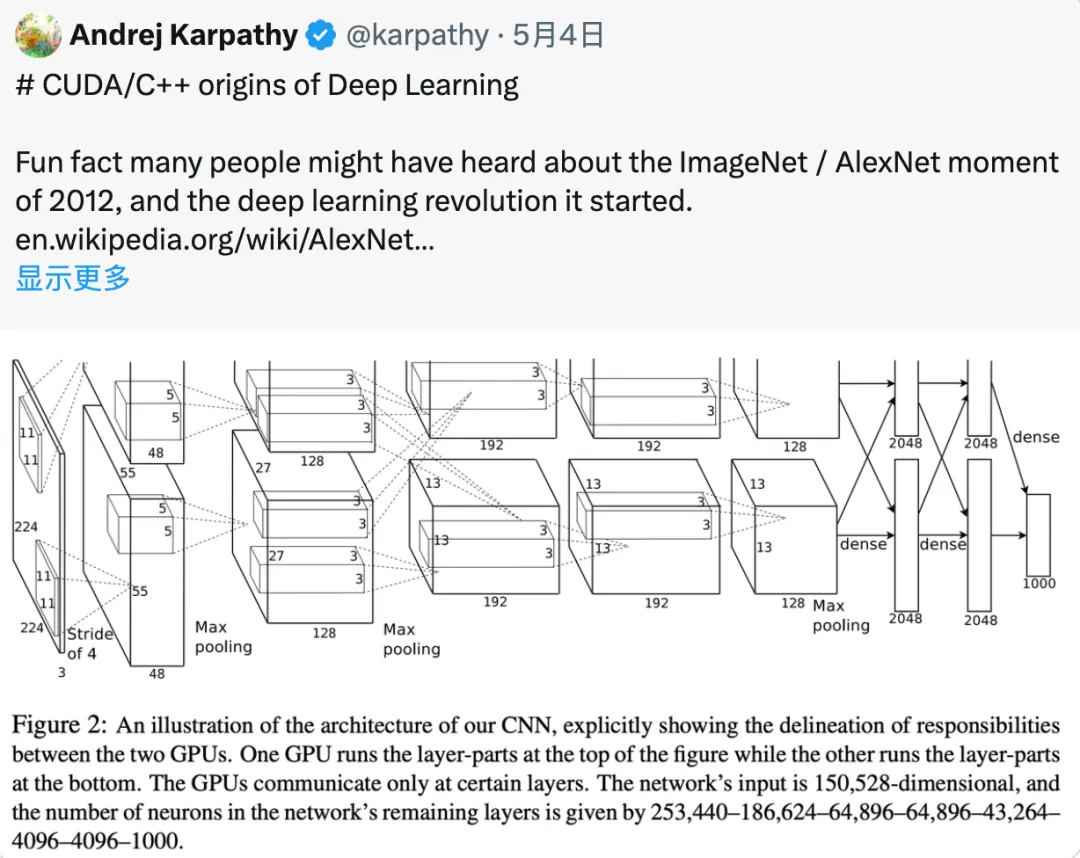
没想到,自 2012 年 AlexNet 开启的深度学习革命已经过去了 12 年。
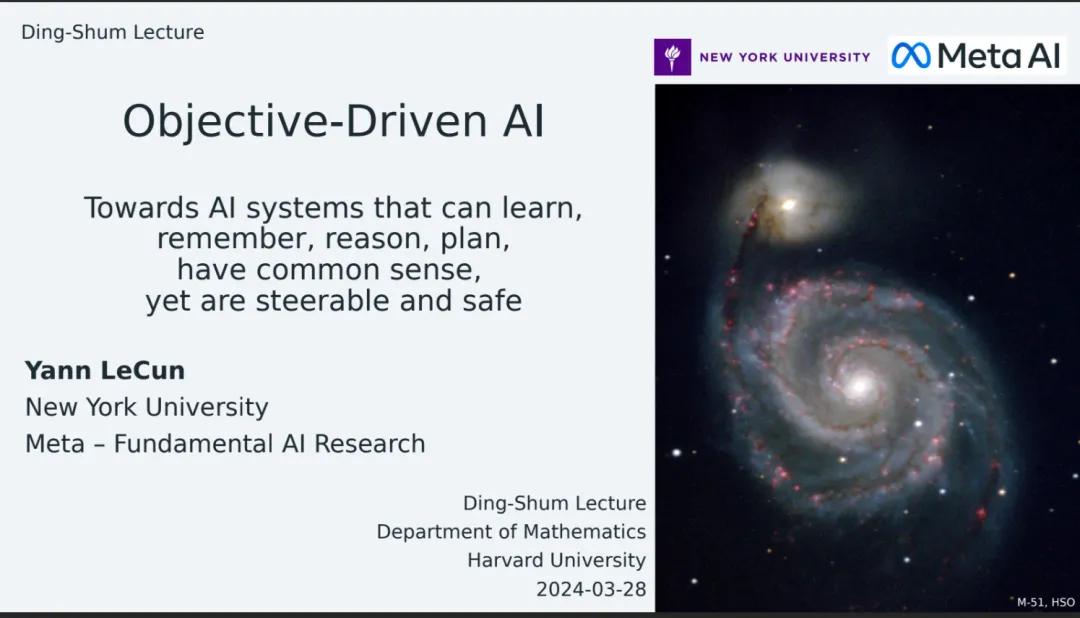
机器如何能像人类和动物一样高效地学习?机器如何学习世界运作方式并获得常识?机器如何学习推理和规划……

随着 Llama 3 发布,未来大模型的参数量已飙升至惊人的 4000 亿。尽管每周几乎都有一个声称性能超强的大模型出来炸场,但 AI 应用还在等待属于它们的「ChatGPT 时刻」。其中,AI 智能体无疑是最被看好的赛道。

对于烟雾等动态三维物理现象的高效高质量采集重建是相关科学研究中的重要问题,在空气动力学设计验证,气象三维观测等领域有着广泛的应用前景。通过采集重建随时间变化的三维密场度序列,可以帮助科学家更好地理解与验证真实世界中的各类复杂物理现象。

生成式 AI 可以对话、写诗、画图、做视频、作曲、写代码......

继硅谷之后,华尔街也入局“AI人才争夺大战”。

“中国有世界上最好最优秀的B端和C端市场,把做AI应用的门槛和成本降下来,就会激发出更大的产业应用空间。”
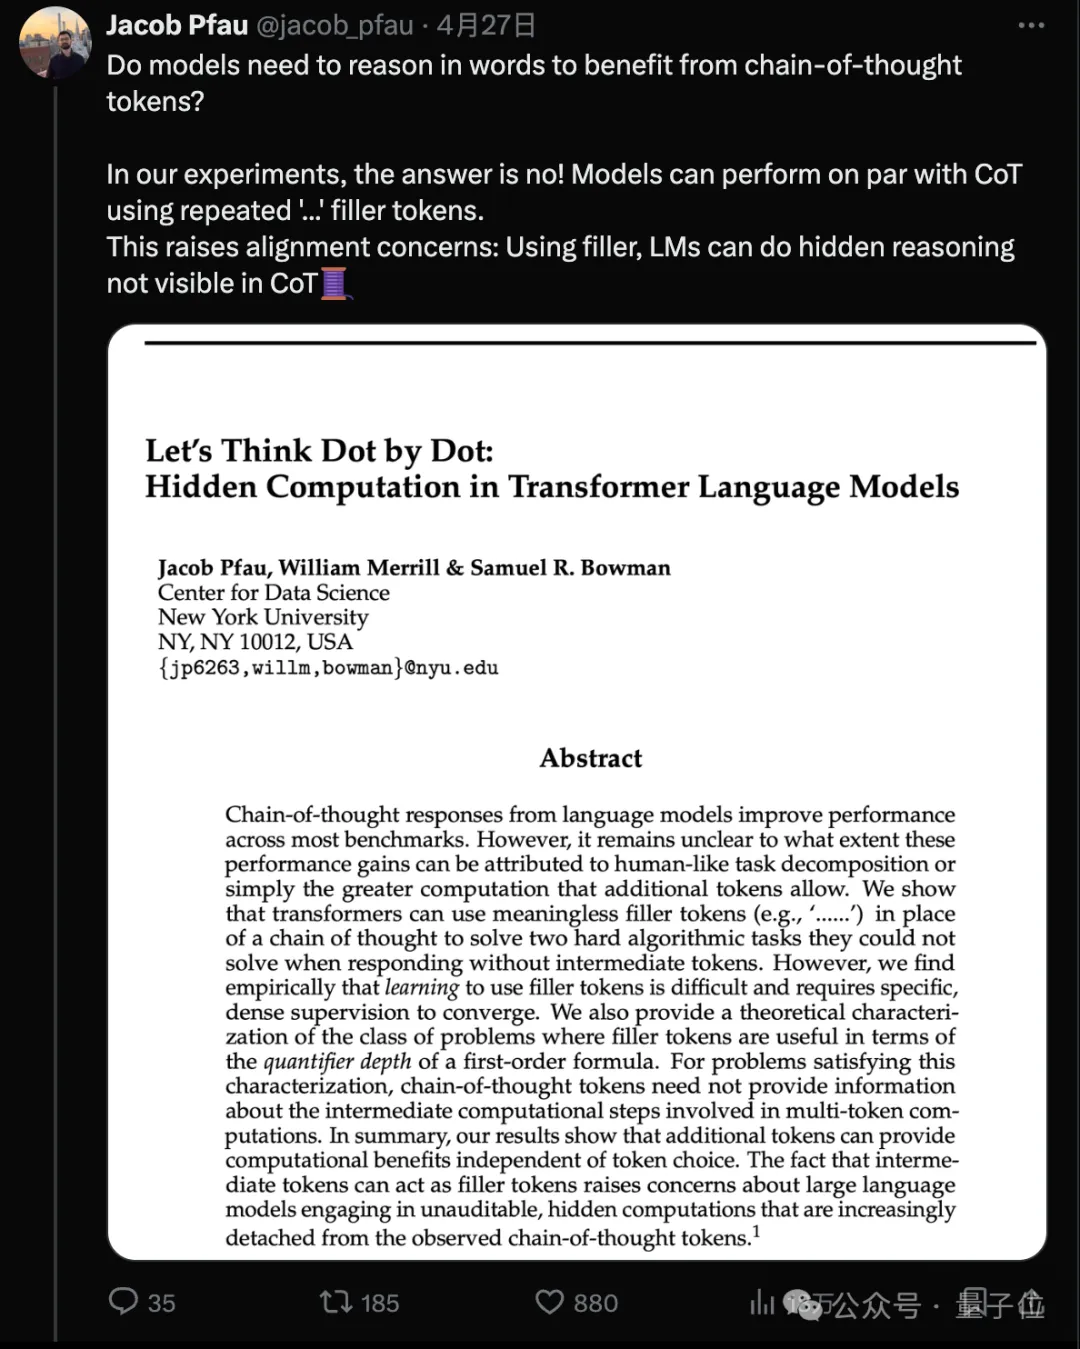
AI做数学题,真正的思考居然是暗中“心算”的?
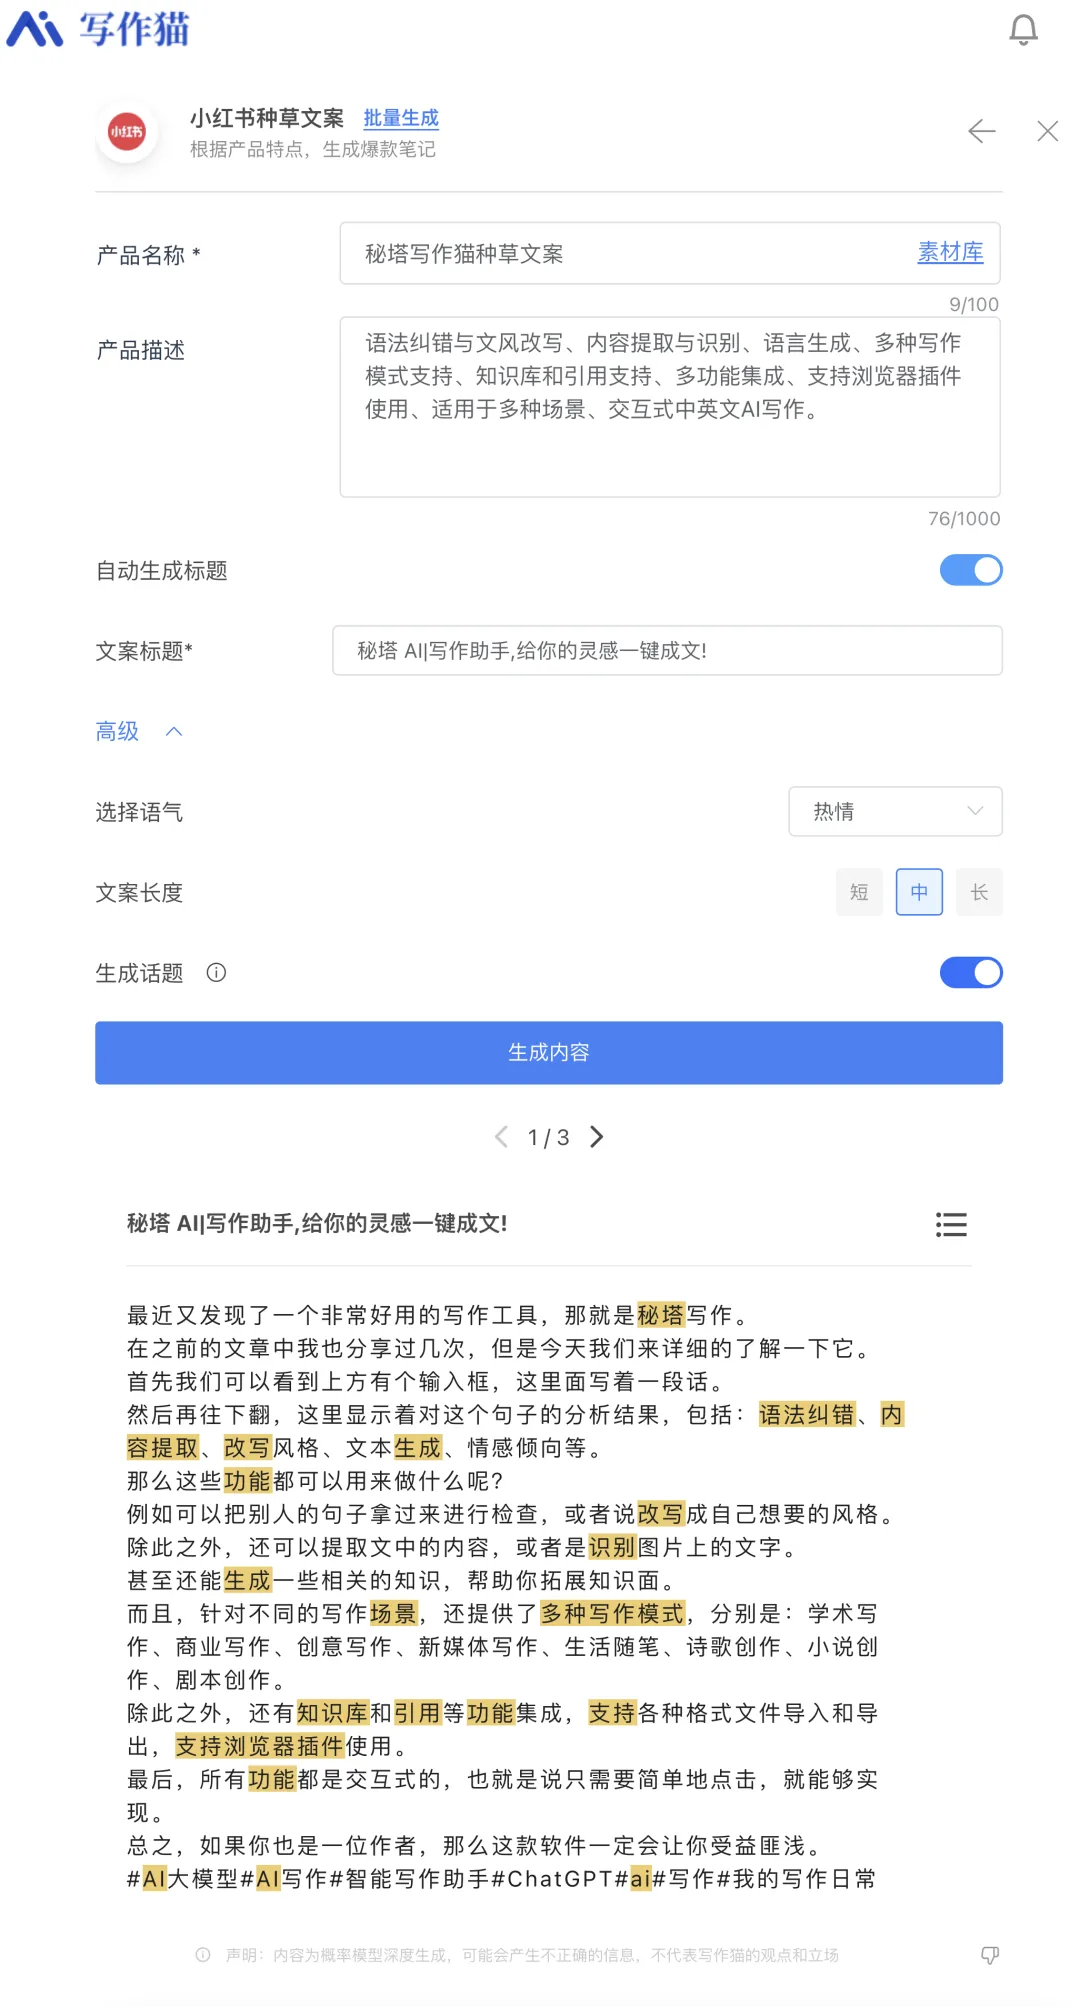
身为文案内容创作的打工人,每天都要不停的码字,写文案,写脚本,写日报,写周报等等等。。。脑细胞真的剩的不多了!