揭秘Sora:用大语言模型的方法理解视频,实现了对物理世界的“涌现”
揭秘Sora:用大语言模型的方法理解视频,实现了对物理世界的“涌现”简单粗暴的理解,就是语言能力足够强大之后,它带来的泛化能力直接可以学习图像视频数据和它体现出的模式,然后还可以直接用学习来的图像生成模型最能理解的方式,给这些利用了引擎等已有的强大而成熟的视频生成技术的视觉模型模块下指令,最终生成我们看到的逼真而强大的对物理世界体现出“理解”的视频。
搜索
简单粗暴的理解,就是语言能力足够强大之后,它带来的泛化能力直接可以学习图像视频数据和它体现出的模式,然后还可以直接用学习来的图像生成模型最能理解的方式,给这些利用了引擎等已有的强大而成熟的视频生成技术的视觉模型模块下指令,最终生成我们看到的逼真而强大的对物理世界体现出“理解”的视频。
刚刚,我们经历了LLM划时代的一夜。谷歌又在深夜发炸弹,Gemini Ultra发布还没几天,Gemini 1.5就来了。卯足劲和OpenAI微软一较高下的谷歌,开始进入了高产模式。
普林斯顿大学和DeepMind的科学家用严谨的数学方法证明了大语言模型不是随机鹦鹉,规模越大能力一定越大。
如果允许学生用AI“作弊”,他们的成绩分布会发生怎样的变化?
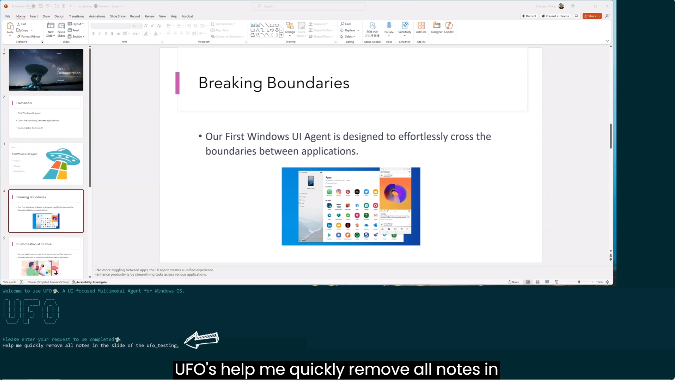
微软首个为Windows而设的智能体(Agent) 亮相:基于GPT-4V,一句话就可以在多个应用中无缝切换,完成复杂任务。整个过程无需人为干预,其执行成功率和效率是GPT-4的两倍,GPT-3.5的四倍。
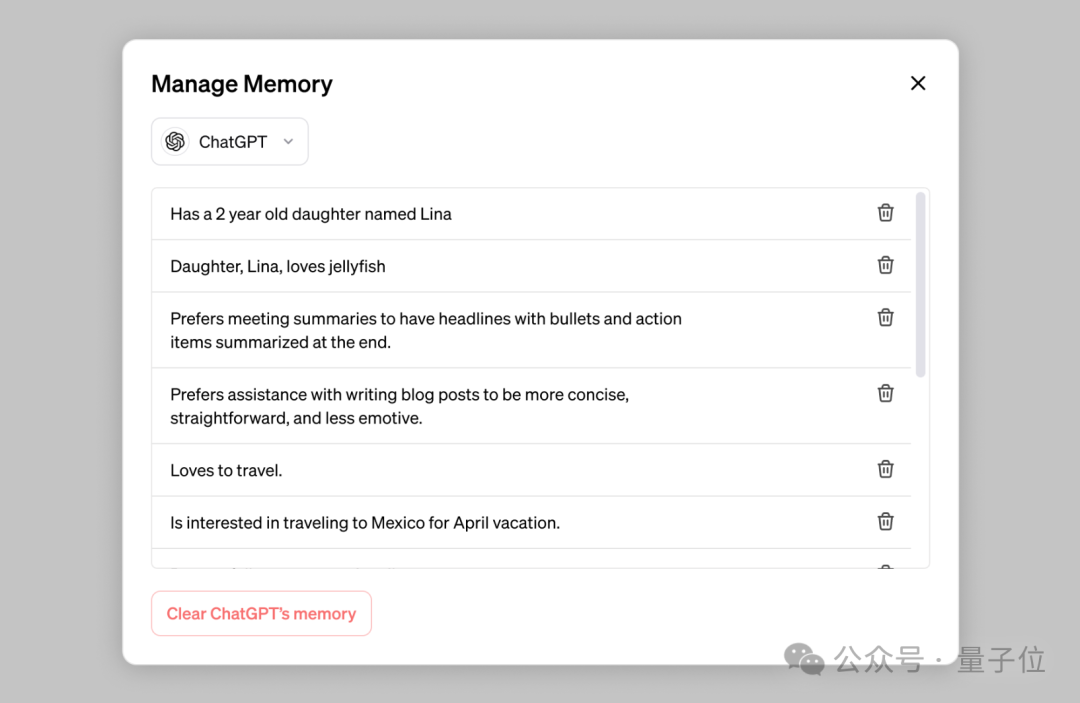
ChatGPT又要推出新功能了,这次名叫“记忆”(Memory)。如其名,作用就是让AI记住用户此前的对话内容。
新春佳节,苹果又给设计师们奉上了新的大礼——全新的AI动画助手!
鹅妹子嘤!AI硬件,自己也能动手做了!只需一个小时,成本不到八百块。
检索增强生成(RAG)和微调(Fine-tuning)是提升大语言模型性能的两种常用方法,那么到底哪种方法更好?在建设特定领域的应用时哪种更高效?微软的这篇论文供你选择时进行参考。
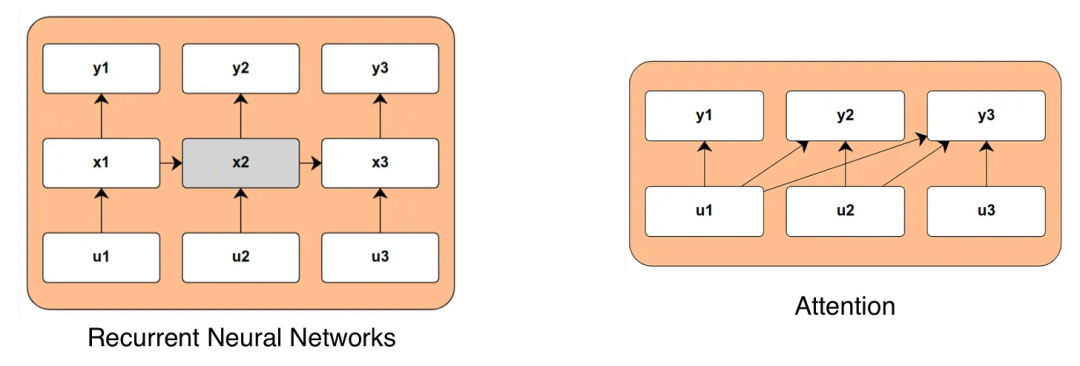
状态空间模型正在兴起,注意力是否已到尽头?