单帧标注视频就能学到片段特征,达到全监督性能!华科拿下时序行为检测新SOTA|AAAI24
单帧标注视频就能学到片段特征,达到全监督性能!华科拿下时序行为检测新SOTA|AAAI24如何从一段视频中找出感兴趣的片段?时序行为检测(Temporal Action Localization,TAL)是一种常用方法。过去TAL中的建模是片段甚至实例级的,而现在只要视频里的一帧就能实现,效果媲美全监督。
来自主题: AI技术研报
9317 点击 2024-01-08 14:33

 搜索
如何从一段视频中找出感兴趣的片段?时序行为检测(Temporal Action Localization,TAL)是一种常用方法。过去TAL中的建模是片段甚至实例级的,而现在只要视频里的一帧就能实现,效果媲美全监督。
仅需一个任务描述,即可一键分割所有图片!

Vista-LLaMA 在处理长视频内容方面的显著优势,为视频分析领域带来了新的解决框架。

不久之前,《纽约时报》指控 OpenAI 涉嫌违规使用其内容用于人工智能开发的事件引起了社区极大的关注与讨论。
当大家都在研究大模型(LLM)参数规模达到百亿甚至千亿级别的同时,小巧且兼具高性能的小模型开始受到研究者的关注。
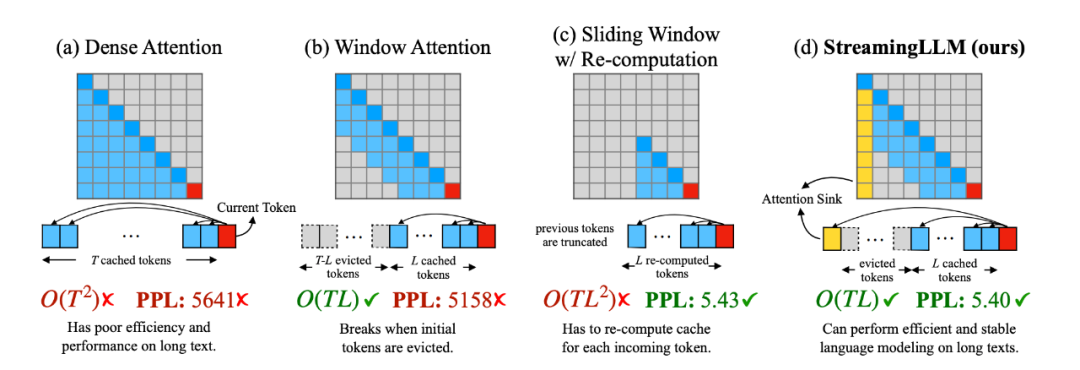
在大型语言模型(LLM)的世界中,处理多轮对话一直是一个挑战。前不久麻省理工 Guangxuan Xiao 等人推出的 StreamingLLM,能够在不牺牲推理速度和生成效果的前提下,可实现多轮对话总共 400 万个 token 的流式输入,22.2 倍的推理速度提升。
指令调优或许是让大模型性能提升最有潜力的方法。用高质量数据集进行指令调优,能让大模型性能快速提升。
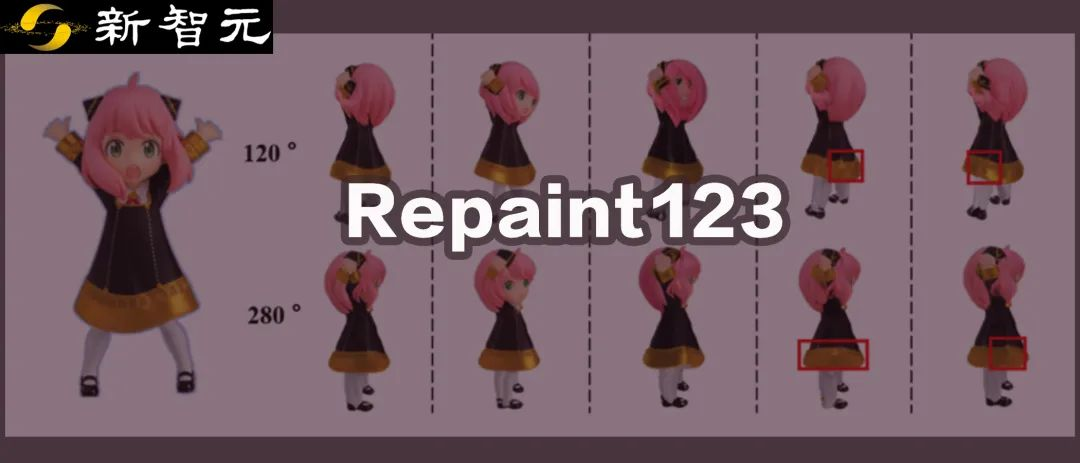
将2D扩散模型的强大图像生成能力与再绘策略的纹理对齐能力结合起来,Repaint123能够在2分钟内从零开始生成具有多视角一致性和精细纹理的高质量3D内容。
据知名苹果爆料人马克·古尔曼周日(1月7日)称,科技巨头苹果公司正准备在今年6月的全球开发者大会(WWDC)上推出一系列基于生成式人工智能(AI)的工具,这将是朝着未来迈出的一大步。
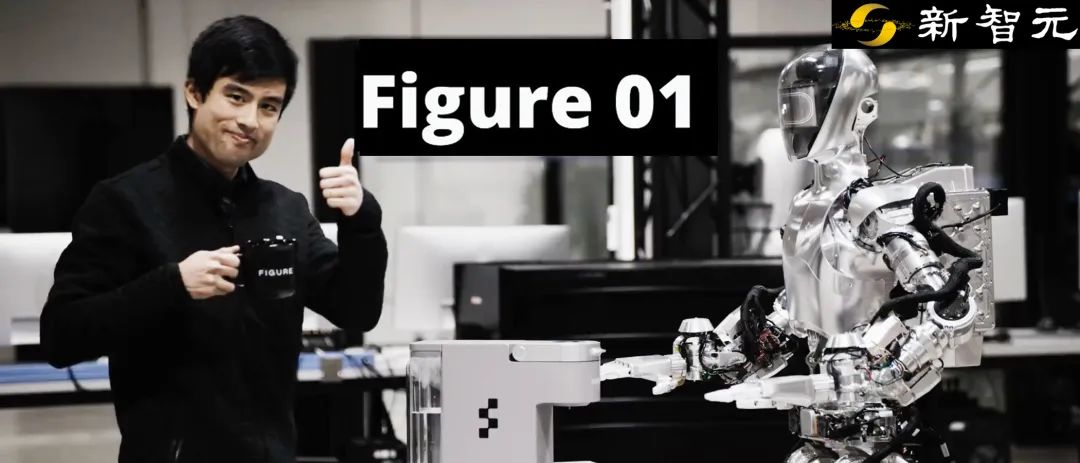
机器人的ChatGPT时刻,真来了!初创公司Figure自家机器人看了10小时视频,学会了煮咖啡。另一边,东京大学GPT-4加持的Alter3机器人,能够模仿人类做出任何动作。而人类只需发出自然语言指令即可,完全不需要编程!