
模型A:幸亏有你,我才不得0分,模型B:俺也一样
模型A:幸亏有你,我才不得0分,模型B:俺也一样琳琅满目的乐高积木,通过一块又一块的叠加,可以创造出各种栩栩如生的人物、景观等,不同的乐高作品相互组合,又能为爱好者带来新的创意。
来自主题: AI技术研报
9389 点击 2024-01-06 16:37

 搜索
琳琅满目的乐高积木,通过一块又一块的叠加,可以创造出各种栩栩如生的人物、景观等,不同的乐高作品相互组合,又能为爱好者带来新的创意。
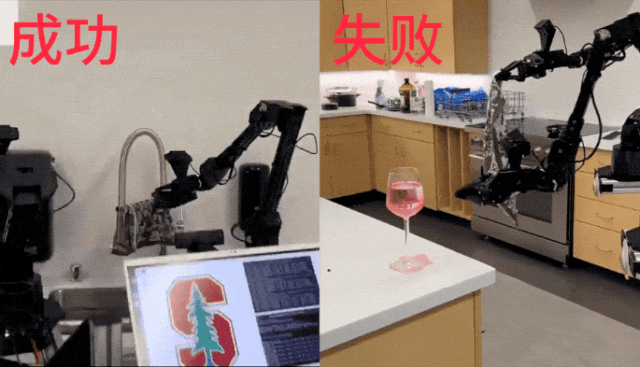
爆火的斯坦福全能家务机器人Mobile ALOHA,大!翻!!车!!!你以为它擦个红酒轻而易举,但实际上却是这样的:
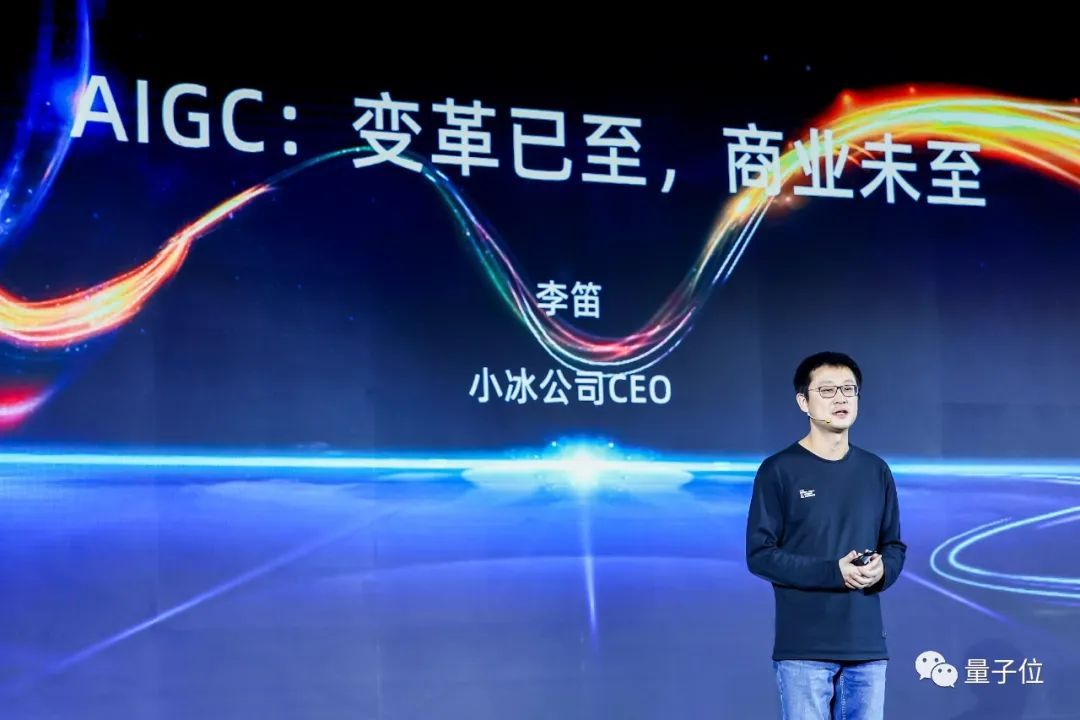
AIGC在商业界中,最大的一笔回报是多少?答案可能是:一张图片,500元。
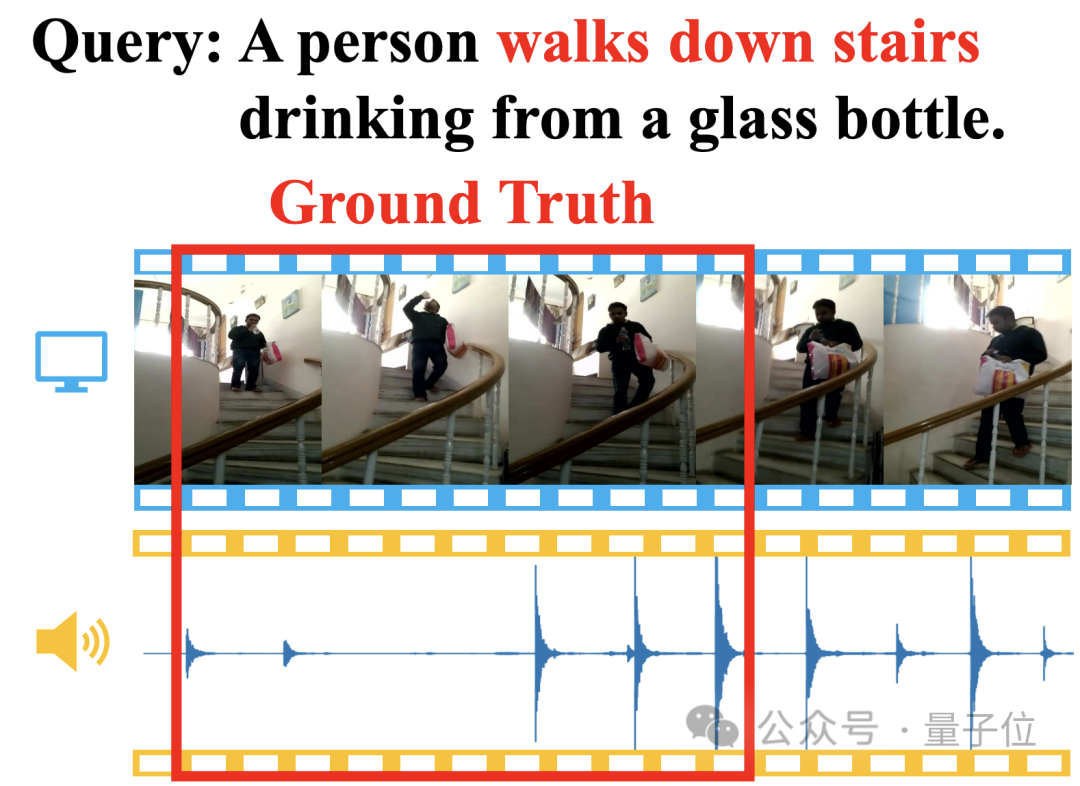
一句话定位视频片段
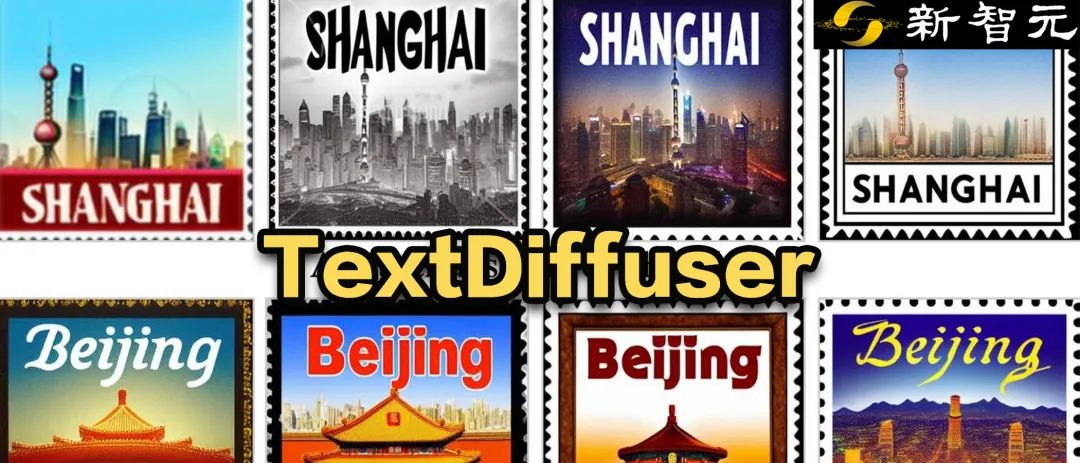
解决扩散模型「不识字」的问题,Textdiffuser采用两阶段(布局+图像)生成框架,显著提升了相关性能的指标!
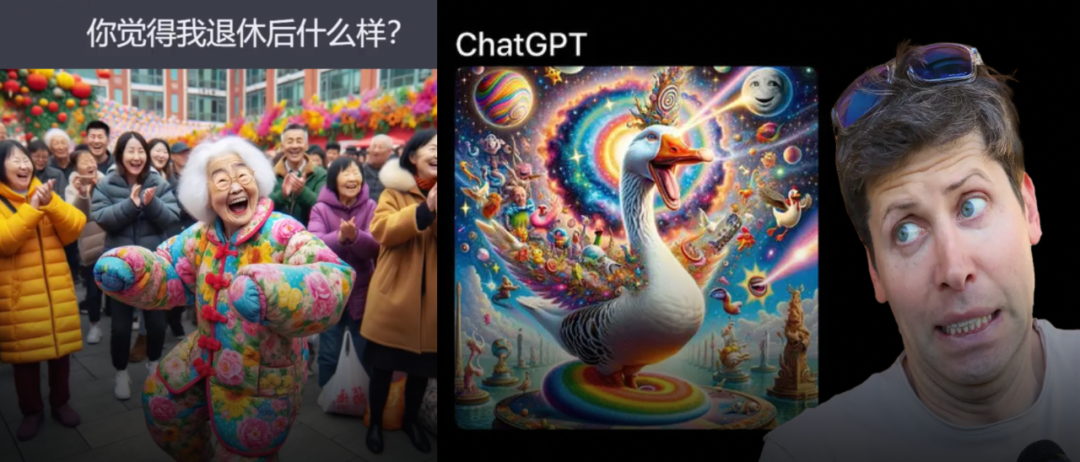
最近,来自NUS、斯坦福、谷歌DeepMind等机构的研究人员,尝试开发了一个评估人类和AI的创造力的框架。而当人类用尽所有手段来逼迫AI把创造力发挥到极限,发现GPT-4几乎对于所有事物认知的极限都是无尽的宇宙空间。
在 AI 领域,近年来各个子领域都逐渐向 transformer 架构靠拢,只有文生图和文生视频一直以 diffusion + u-net 结构作为主流方向。diffusion 有更公开可用的开源模型,消耗的计算资源也更少。

“发光的水母从海洋中慢慢升起,”在 Morph Studio 中继续输入想看到的景象,“在夜空中变成闪闪发光的星座”。
进入现今的大模型 (LLM) 时代,又有研究者发现了左右互搏的精妙用法!近日,加利福尼亚大学洛杉矶分校的顾全全团队提出了一种新方法 SPIN(Self-Play Fine-Tuning),可不使用额外微调数据,仅靠自我博弈就能大幅提升 LLM 的能力。
这篇论文介绍了一项新的任务 —— 指向性遥感图像分割(RRSIS),以及一种新的方法 —— 旋转多尺度交互网络(RMSIN)。