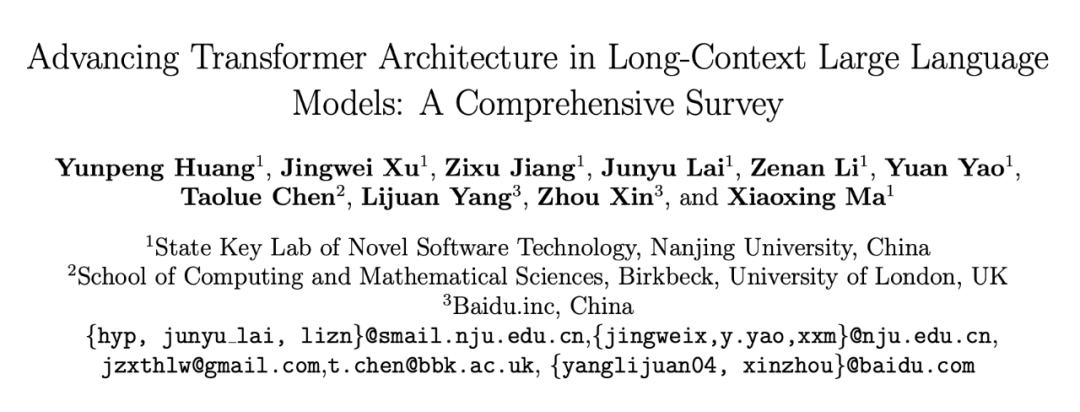
面向超长上下文,大语言模型如何优化架构,这篇综述一网打尽了
面向超长上下文,大语言模型如何优化架构,这篇综述一网打尽了作者重点关注了基于 Transformer 的 LLM 模型体系结构在从预训练到推理的所有阶段中优化长上下文能力的进展。
来自主题: AI资讯
6310 点击 2024-01-03 13:38

 搜索
作者重点关注了基于 Transformer 的 LLM 模型体系结构在从预训练到推理的所有阶段中优化长上下文能力的进展。
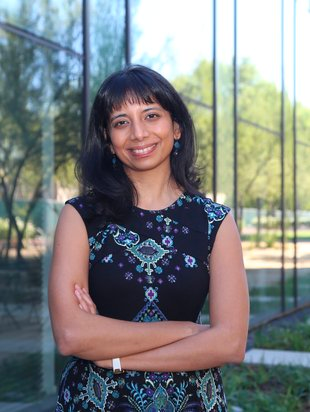
今日,AAAI 公布了 2024 年度的 Fellow 评选结果,共 12 位学者入选,其中包括清华大学教授朱军。
拾象科技及其公众号「海外独角兽」一直关注海外大模型产品的技术和商业进展,近日,拾象科技 CEO 李广密和商业作者张小珺一起讨论了 2023 年全球大模型竞赛,以及接下来大模型格局会如何演进、GPT-4 的超越难度、以及需要解决的关键问题等。

今年过得很快,好在还有朋友圈。整理后才发现我今年在朋友圈细细碎碎写了15万字:大小作文大概有 13万字,各种短评和观点加起来也有2万多字。这个数量是惊人的,这是一本标准图书的体量了。
2023年上半年人见人爱的大模型,逐渐“失宠”。前有百度创始人李彦宏说“重复开发大模型是资源浪费”,后有百川智能联合创始人洪涛说“99%的行业大模型都可能被替代”。
Coatue是一家总部位于纽约的对冲基金,以持之以恒地对TMT赛道押注受业界关注,自1999年由Philippe Laffont(菲利普·拉丰)离开老虎基金之后创办至今,它的管理规模已从4500万跨越到190亿美元。
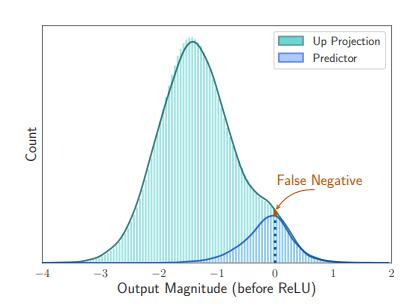
大模型领域最新的一个热门趋势是把模型塞到手机里。而最应该做这个研究的公司终于带着它的论文现身,那就是苹果。
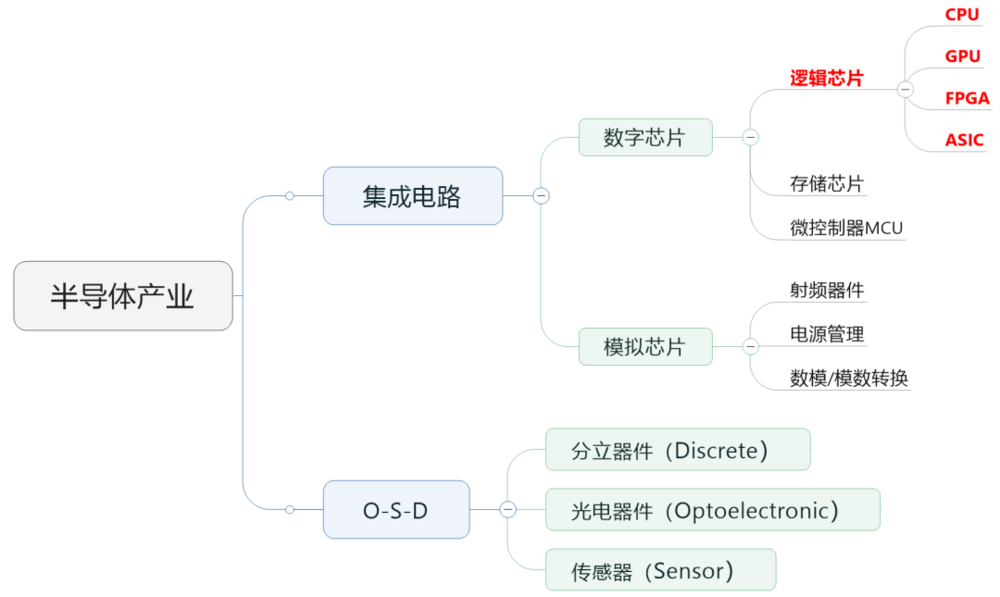
本文介绍了为什么在AI计算中要使用GPU,以及GPU与CPU的区别和作用。GPU具备强悍的并行计算能力,适合处理大量高强度并行计算任务,包括深度学习算法。
谷歌放出的Gemini,在对标GPT的道路上似乎一直处于劣势,Gemini真的比GPT-4弱吗?最近,斯坦福和Meta的学者发文为Gemini正名。
大型语言模型(LLM)虽然在诸多下游任务上展现出卓越的能力,但其实际应用还存在一些问题。其中,LLM 的「幻觉(hallucination)」问题是一个重要缺陷。