AI资讯新闻榜单内容搜索-2

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 2
刚刚,Mythos 5破解量子计算重大难题!53小时碾压人类数年

刚刚,Mythos 5破解量子计算重大难题!53小时碾压人类数年

刚刚,Mythos 5破解量子计算重大难题!53小时碾压人类数年

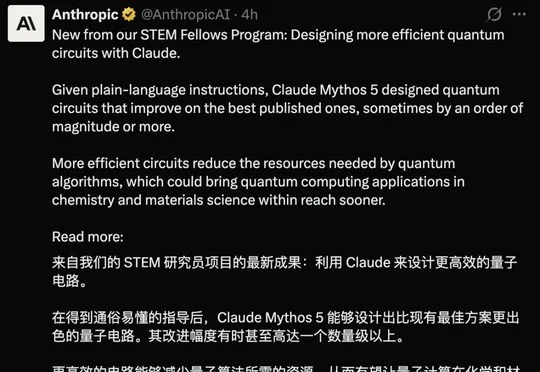
Anthropic称,Mythos 5在53小时内自主设计8个量子电路并击败人类公开最优方案,其中新解码实现将量子门数量降低17倍,另一架构将计算成本降低12倍。

来自主题: AI资讯
10349 点击    2026-10-17 12:05
刚刚,老黄RTX Spark开卖!740亿大模型塞进笔记本

刚刚,老黄RTX Spark开卖!740亿大模型塞进笔记本

刚刚,老黄RTX Spark开卖!740亿大模型塞进笔记本

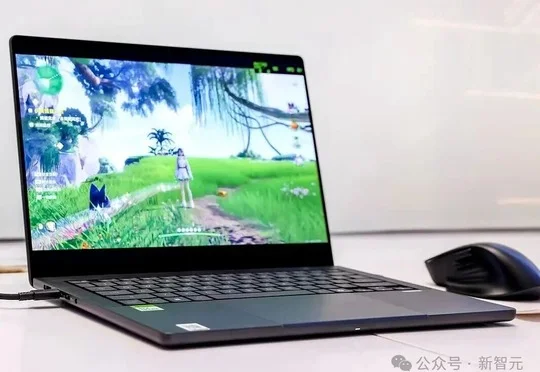
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
来自主题: AI资讯
11221 点击    2026-10-17 12:04
清华开源!智能体操作系统任务成本降83%,AI记忆可查可改

清华开源!智能体操作系统任务成本降83%,AI记忆可查可改

清华开源!智能体操作系统任务成本降83%,AI记忆可查可改

清华大学THUNLP实验室联合面壁智能、OpenBMB等团队开源智能体操作系统PilotDeck 2.0,支持记忆可查可改、后台长任务与智能路由,并在复杂任务测试中将成本降低约83%。
来自主题: AI资讯
9779 点击    2026-10-17 12:03
千问Agent训练框架公开!不多加一张卡,训练效率提升78%

千问Agent训练框架公开!不多加一张卡,训练效率提升78%

千问Agent训练框架公开!不多加一张卡,训练效率提升78%

千问披露Agent训练框架QwenGyre,通过弹性调度和轨迹处理,将Qwen 3.8 2.4T的48步强化学习训练耗时从134.55小时降至75.42小时、效率提升78%,并计划优化后开源。
来自主题: AI资讯
10083 点击    2026-10-17 12:03
超1亿元融资砸向四川具身科技!要把「情绪价值」卖进千家万户

超1亿元融资砸向四川具身科技!要把「情绪价值」卖进千家万户

超1亿元融资砸向四川具身科技!要把「情绪价值」卖进千家万户

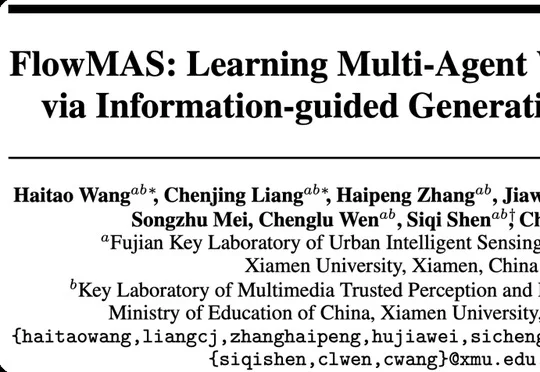
四川具身人形机器人科技有限公司(EIR)完成超1亿元Pre-A轮融资,资金将用于爱湫迭代研发、万台级生产基地建设和销售体系搭建,其整机量产基地预计2026年年底投产。
来自主题: AI资讯
9756 点击    2026-10-17 12:02
NeurIPS 2026 | FlowMAS:让AI团队自己学会「排兵布阵」

NeurIPS 2026 | FlowMAS:让AI团队自己学会「排兵布阵」

NeurIPS 2026 | FlowMAS:让AI团队自己学会「排兵布阵」

厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
来自主题: AI技术研报
9516 点击    2026-10-17 11:59
NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

NeurIPS 2026 | 层内混合注意力:告别位置「伪混合」,STILL首个内容感知的层内混合注意力架构

STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
来自主题: AI技术研报
8835 点击    2026-10-17 11:59
硬件、数据到模型:Sharpa如何系统性推进灵巧操作

硬件、数据到模型:Sharpa如何系统性推进灵巧操作

硬件、数据到模型:Sharpa如何系统性推进灵巧操作

Sharpa以22自由度Sharpa Wave灵巧手为硬件平台,通过融合人类与遥操作数据、解耦运动与接触控制及开展触觉跨本体学习,系统推进灵巧操作的数据、模型与硬件协同研究。
来自主题: AI技术研报
8574 点击    2026-10-17 11:57
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算

别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算

别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算

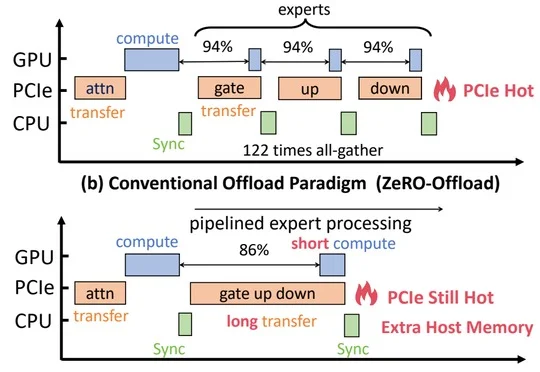
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
来自主题: AI技术研报
10635 点击    2026-10-17 11:56
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事

OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事

OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事

OpenAI前研究员Nick Cammarata与Goodfire团队发布研究称,一个320亿参数语言模型中约90%的神经元各有可解释的主要任务,表明追踪和干预神经元或能揭示AI内部规律,但该判断仍待更多检验。

来自主题: AI资讯
10722 点击    2026-10-17 11:56