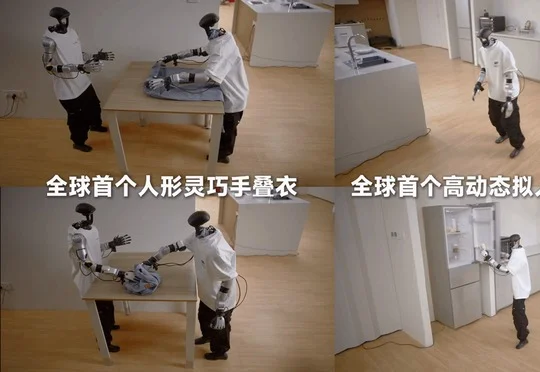
全球首次!杭州具身黑马比肩Figure,全身协同自主叠衣
全球首次!杭州具身黑马比肩Figure,全身协同自主叠衣西湖机器人升级通用大脑WR1,采用全球首创的通用大小脑双预训练系统架构,融合WM、VLA与GAE,完成双机器人协同折叠衣物及跨厨房、客厅、卧室的连续自主家务演示。
来自主题: AI资讯
7975 点击 2026-10-10 12:37

 搜索
西湖机器人升级通用大脑WR1,采用全球首创的通用大小脑双预训练系统架构,融合WM、VLA与GAE,完成双机器人协同折叠衣物及跨厨房、客厅、卧室的连续自主家务演示。
扩散智能DiffuSpace连续完成两轮融资,总金额达数亿元,由经纬创投、顺为资本、君联资本联合领投,创下全球扩散语言模型(dLLM)最大规模融资纪录。
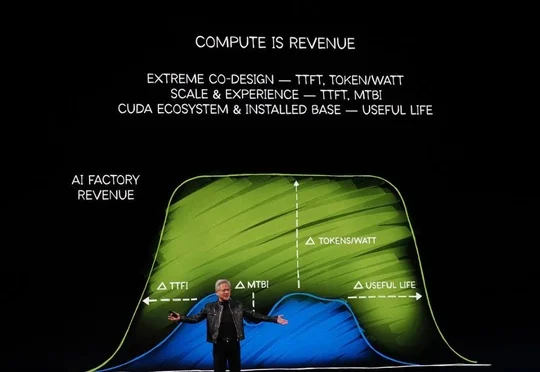
《金融时报》披露OpenAI截至9月底年化营收接近500亿美元,较此前报道少约200亿美元,差异涉及云平台合作销售的总额与净额口径,并不等同于收入损失。
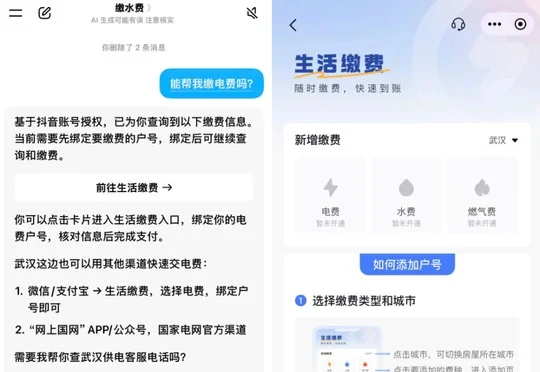
豆包新增“生活缴费”功能,用户可通过语音或文字唤起水、电、燃气缴费服务卡片,但城市覆盖、服务商对接及支付闭环仍在推进。
英伟达联合MIT和牛津大学团队提出Physis-Lang,通过物理语言描述、自进化准则和能力导向的数据检索提升视频模型的物理理解与生成表现,其Cosmos3-Super和Cosmos3-Nano在Physics-IQ Verified分列第一、第二。
谁能想到…Gowers你可能还是乐观了。10月7日,OpenAI一口气放出了722篇数学手稿,论文和部分Lean证明全部上传Github。其中编号074的一组只有两篇,正是王虹拿奖的那个方向:挂谷猜想。
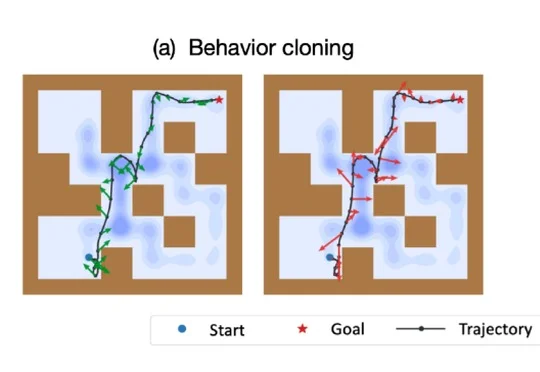
清华大学智能产业研究院(AIR)的一项NeurIPS 2026录用工作提出高阶动作监督,无需改动策略网络即可约束动作的一阶时序变化,并在OGBench及约1%数据的D4RL实验中提升小样本性能与动作平滑性。
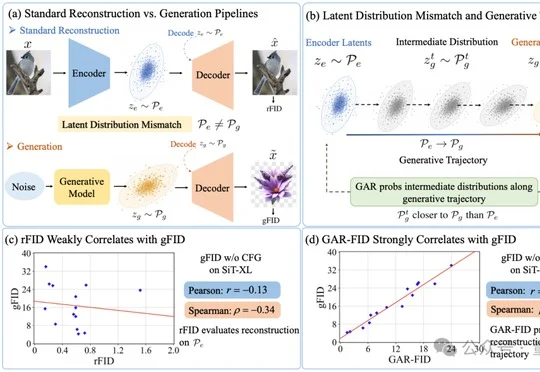
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
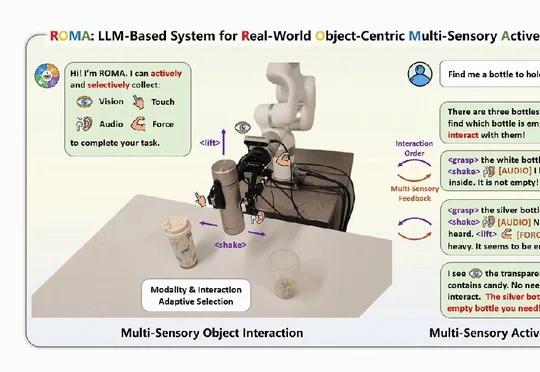
人大高瓴 GeWu-Lab、智源研究院与燧行 AresoX 等机构提出 ROMA,构建 ROMI-2K、ROMA Bench 及 ROMA-7B,使机器人融合视听触力主动探索物体,并在 ROMA Bench 上以 72.9% 总体任务成功率基本追平 GPT-6 Astra。
Anthropic将在11月12日起生效的Claude使用政策中,禁止用户对Claude模型实施持续且不必要的虐待或残忍行为,主要由模型终止对话作为执法手段。