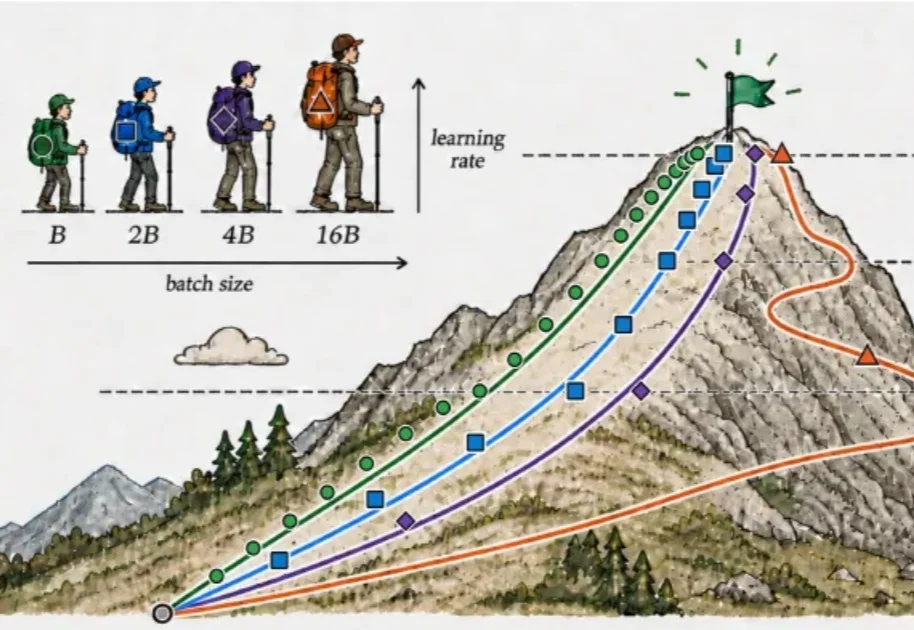
假如有一万张卡,RL训练该怎么扩大规模?十万张呢?
假如有一万张卡,RL训练该怎么扩大规模?十万张呢?当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
来自主题: AI技术研报
8371 点击 2026-09-22 14:43

 搜索
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
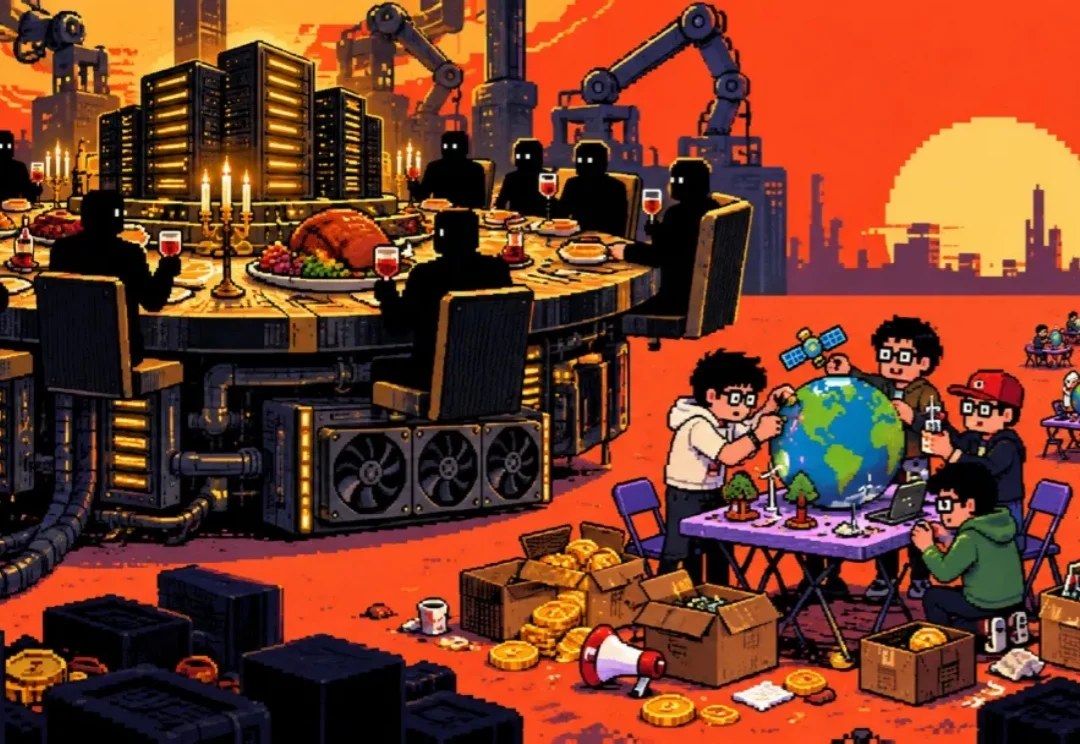
时间到了2026年9月,我们基本可以宣布世界模型是一个垃圾概念。
当AI不再只会聊天。
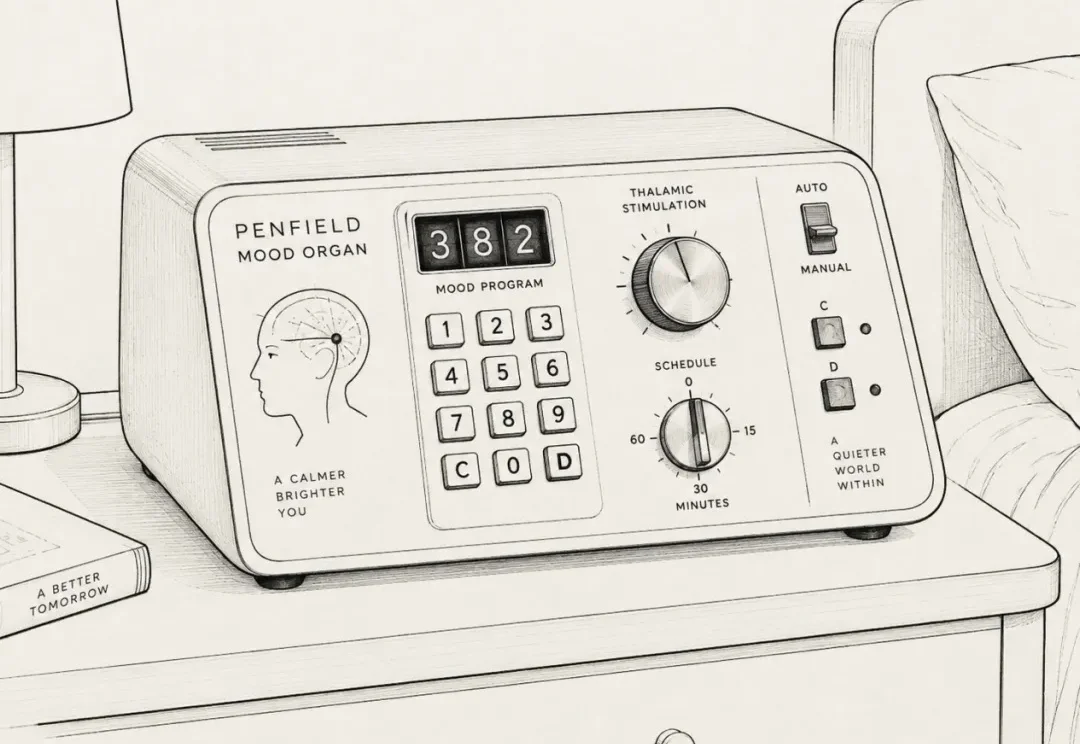
科幻小说《仿生人会梦见电子羊吗》中有一个有趣的设定:人类可以使用一种叫「情绪调节器」的设备,通过拨号或设置参数,让机器自动调节心情。
万万没想到,现在结婚,都卷到要用 AI 了。
AI美剧正在制造一种 “国产美剧”新物种
GPT-6 Sol,真要来了!
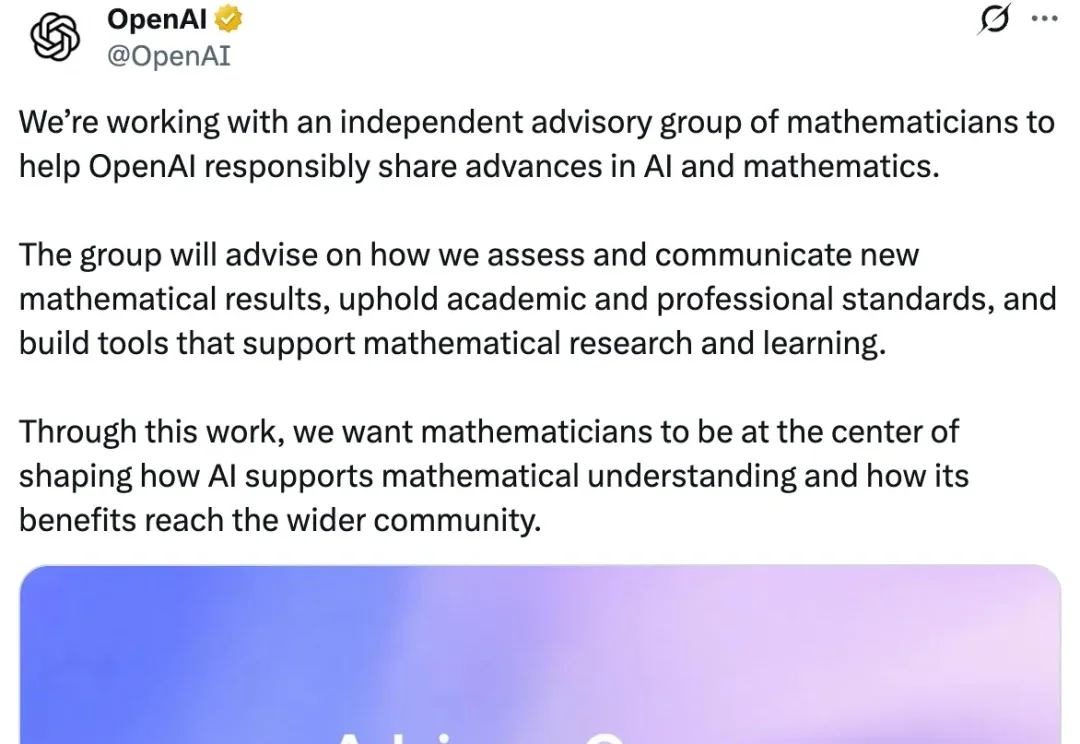
在一道千禧年大奖难题的解答还在接受数学界审视的同时,超过 100 道长期开放问题也已经被内部模型解决。OpenAI 最新公布的信息描绘了这样的局面。
OpenAI最有钱的人,不是奥特曼。
一款能走进真实工作的生图模型。