深度|Personal Agent 的交互需要被重新定义,Orilo 从 Voice 切入
深度|Personal Agent 的交互需要被重新定义,Orilo 从 Voice 切入Personal Agent 这个赛道,至今仍存在巨大的非共识,热度与质疑并存。
来自主题: AI资讯
9377 点击 2026-11-03 16:40

 搜索
Personal Agent 这个赛道,至今仍存在巨大的非共识,热度与质疑并存。
AI模型后训练公司Trajectory宣布完成4500万美元A轮融资,由红杉资本领投,英伟达、Bessemer Venture Partners和Bain Capital Ventures参投,估值达3亿美元,其基于持续学习的后训练平台已正式向公众开放。
乔布斯心中的Siri,这次可能真的走进现实了。
下一代 GPT 的一个重要线索,Sam Altman 透露了。
660倍的参数差距,结果小模型赢了?!
“在每一个有创造性活动的领域里,一个人的Taste,加上他的能力和机遇,决定了他的风格;而他的风格,反过来决定了他的贡献。因此Taste和风格之于科学研究,就像它们对文学、艺术和音乐一样至关重要。”
人类用了两千年的模拟计算,开始被重新定义了。
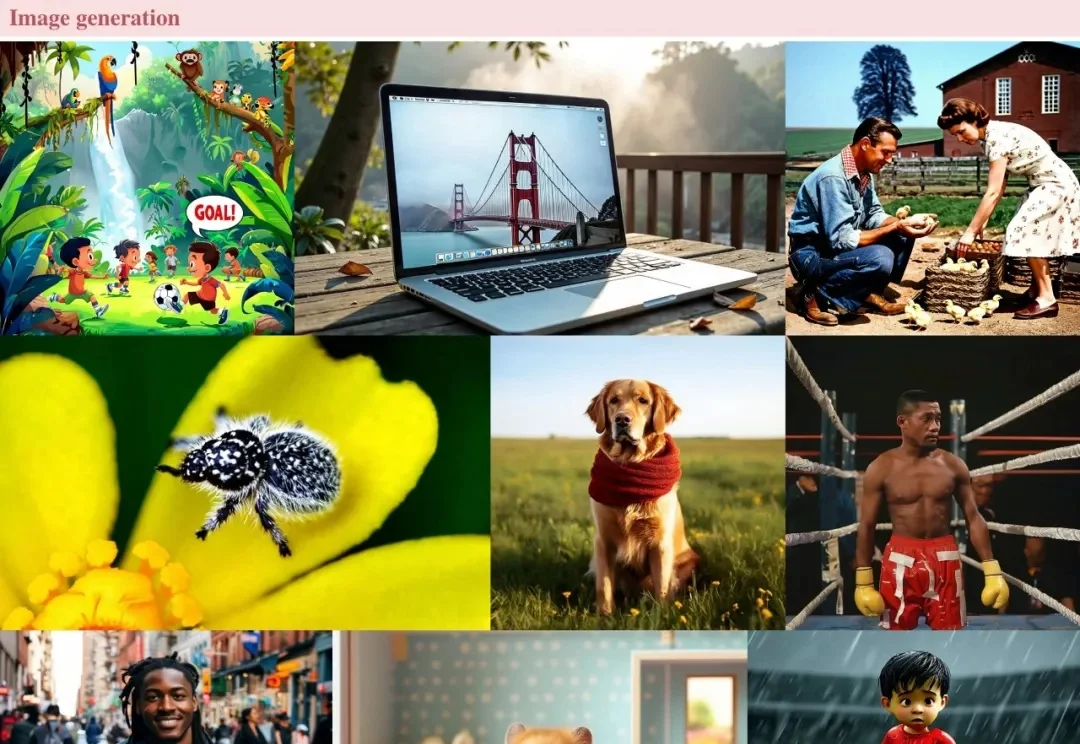
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
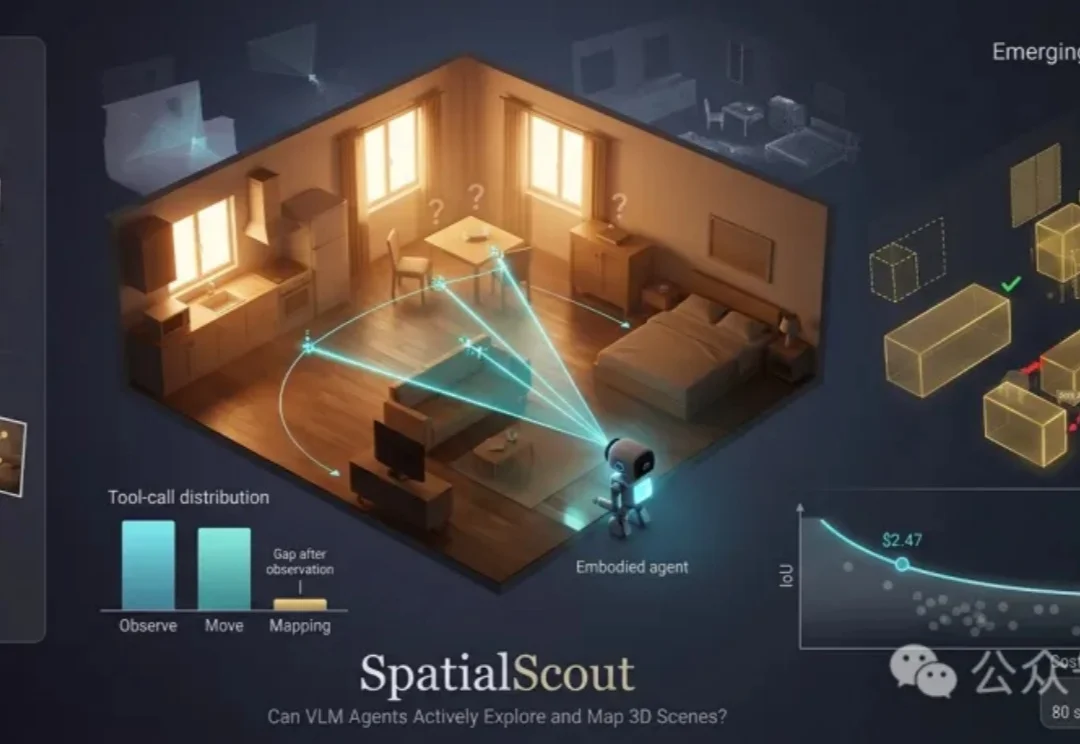
想象一项任务:把相机交给AI,让它进入一间从未见过的虚拟房间。没有预先给定的物体坐标,也没有替它安排好的参观路线。它需要决定朝哪里转、向哪里移动、何时再拍一张图,并最终说清楚各个目标物体在三维空间中的位置。
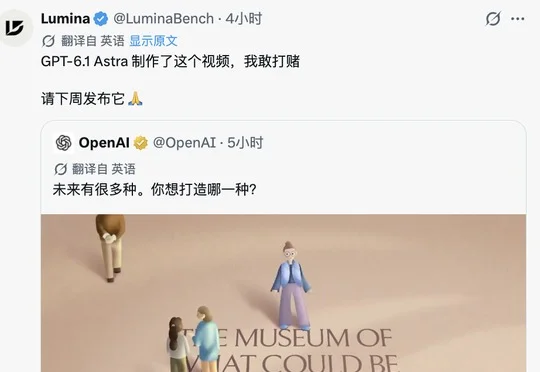
OpenAI发布76秒神秘动画,引发对GPT-6.1 Astra即将发布的猜测;第三方模型追踪截图还显示gpt-6.2-betelgeuse - INTERNAL,网传GPT-6.2 Betelgeuse参数规模达12万亿。