撸猫撸出SOTA!3个00后2个月,造出史上最快流式音视频社交模型MaineCoon
撸猫撸出SOTA!3个00后2个月,造出史上最快流式音视频社交模型MaineCoon一觉醒来,AI的新潮流变成了养猫???火速围观一下,刚刚全球流式音视频模型赛道闯进了一匹黑马,能力SOTA级,模型名字就叫缅因猫(MaineCoon)。养过缅因猫的朋友都知道,这个品种有个外号叫「猫狗」,意思是几乎你走到哪儿,它就跟到哪儿,相当粘人,互动感MAX。
搜索
一觉醒来,AI的新潮流变成了养猫???火速围观一下,刚刚全球流式音视频模型赛道闯进了一匹黑马,能力SOTA级,模型名字就叫缅因猫(MaineCoon)。养过缅因猫的朋友都知道,这个品种有个外号叫「猫狗」,意思是几乎你走到哪儿,它就跟到哪儿,相当粘人,互动感MAX。
早在3月20日,纽约时报的凯文·罗斯就发现了在硅谷开发者中,出现了一种叫做 Tokenmaxxing的现象。这个现象最早出现在OpenAI、Anthropic等前沿模型开发公司。OpenAI 的工程师一周用了 2100 亿个token,大概是 33 个维基百科的量;Claude Code 的工程师则一个月单人可以烧15万美元token。
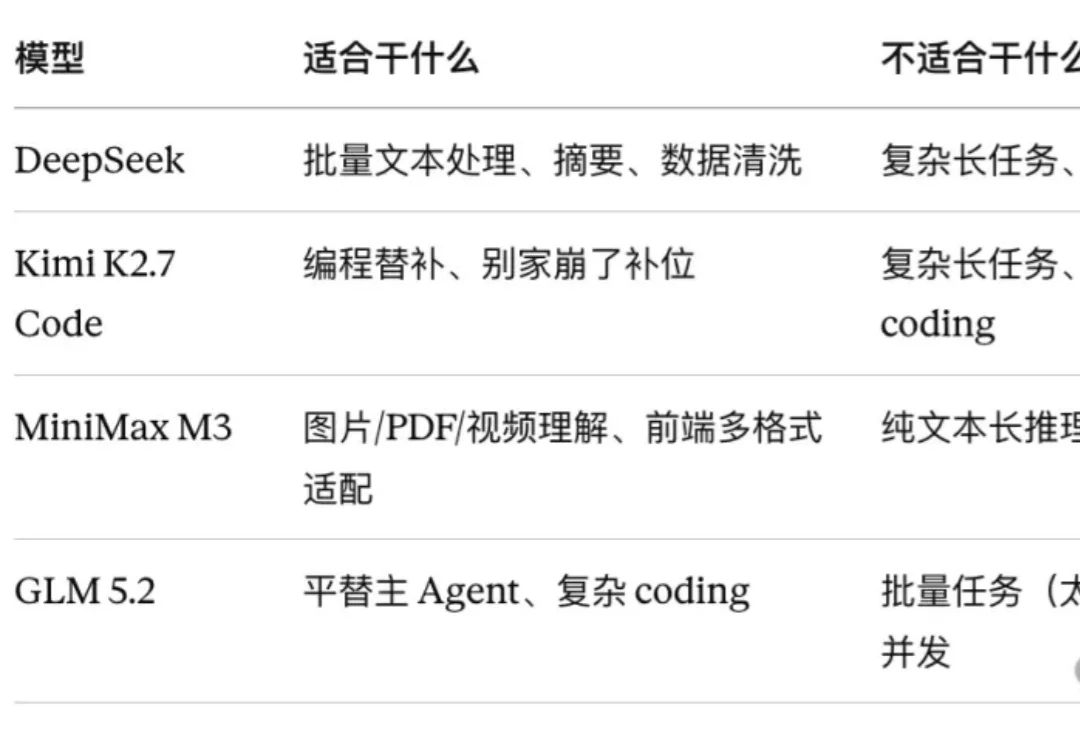
最近,Kimi 2.7 Code 和 GLM 5.2 接连发布,一周双发,国产模型又崛起了。
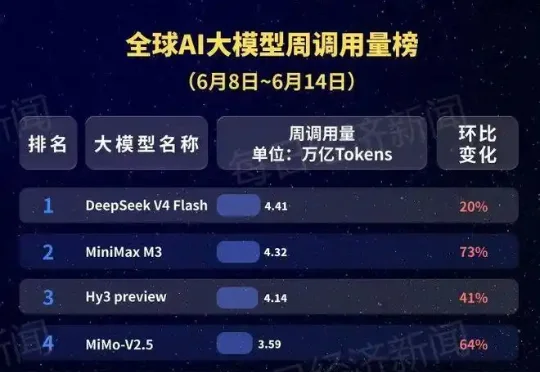
根据OpenRouter最新数据测算,上周(6月8日至14日)全球AI大模型总调用量为44.6万亿Token,较此前一周增长23.5%,连续八周上涨,大模型调用需求仍在持续释放。
这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。
当智能逼近临界点。
我们在上周五开源了 MiniMax M3 模型权重,同步发布了 MSA(MiniMax Sparse Attention)技术论文。MSA 的架构设计让 M3 在长上下文下的计算成本大幅降低,论文中完整披露了架构与工程实现细节。
根据我长期使用的观察,0.3 倍率说是用 Kiro 逆向出来的 Claude,2.0 倍率说是正经 Claude Max 号池接出来的。听起来后者肯定更靠谱。我一开始也这么想的。毕竟倍率差了快七倍,价格摆在那,总不至于拿假货糊弄人吧。
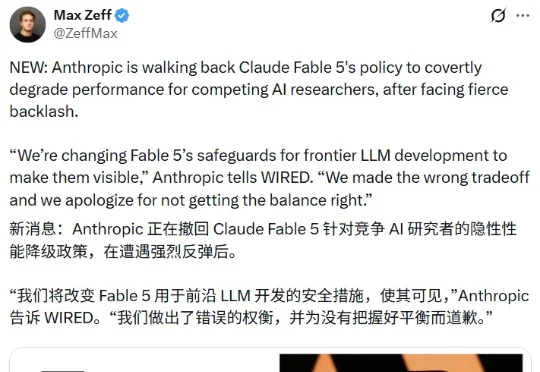
压力之下,刚刚,《连线》记者 Max Zeff 爆料称,Anthropic 正在撤销这一政策。该媒体从 Anthropic 获得了一份声明,其中写到:「我们正在调整 Fable 5 针对前沿 LLM 开发的安全限制,使其变得可见。」
最近Max Leiter写了一篇文章《它们是权重做的》:https://maxleiter.com/blog/weights 专门用来调侃大模型,我看了以后,觉得虽然有趣,但是不太符合国人的阅读习惯,就重新写了一遍,希望大家喜欢。