AI资讯新闻榜单内容搜索-ODE

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: ODE
Claude Code发布4个月,用户已经11.5万了,开发者:200 美元/月不算贵

Claude Code发布4个月,用户已经11.5万了,开发者:200 美元/月不算贵

Claude Code发布4个月,用户已经11.5万了,开发者:200 美元/月不算贵

根据 Anthropic 最近公布的一项数据,他们的 Claude Code 已经吸引了 11.5 万名开发人员,并在一周内处理了 1.95 亿行代码。而这款工具,才刚刚发布 4 个多月。Menlo Ventures 风险投资家 Deedy Das 据此推断,仅靠 Claude Code 这个产品,Anthropic 的年收入就可能达到 1.3 亿美元。

来自主题: AI资讯
10234 点击    2025-07-08 09:34
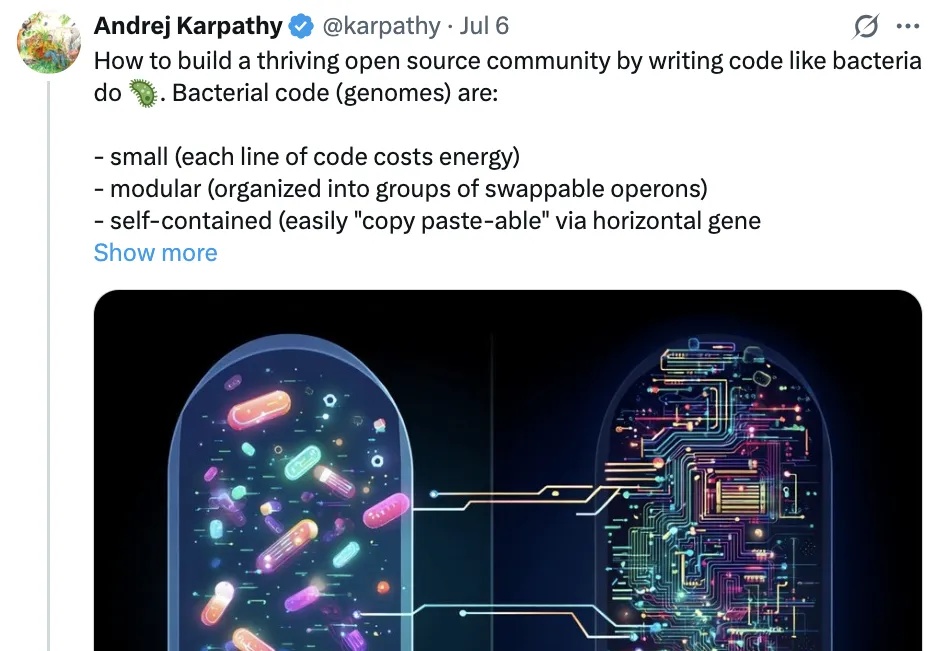
Karpathy最新脑洞「细菌编程」:优秀的代码应该具备细菌的三大特质

Karpathy最新脑洞「细菌编程」:优秀的代码应该具备细菌的三大特质

Karpathy最新脑洞「细菌编程」:优秀的代码应该具备细菌的三大特质

像细菌一样编写代码!创造出“氛围编程”、“软件3.0”的大神Karpathy又抛出一个新概念,引起网友广泛讨论——细菌编程(Bacterial code),要有三个特点:代码块小而精、模块化、自包含且易于复制粘贴。

来自主题: AI资讯
8791 点击    2025-07-07 15:53
“10x Cursor”开发体验, Claude Code 如何带来 AI Coding 的 L4 时刻?|Best Ideas

“10x Cursor”开发体验, Claude Code 如何带来 AI Coding 的 L4 时刻?|Best Ideas

“10x Cursor”开发体验, Claude Code 如何带来 AI Coding 的 L4 时刻?|Best Ideas

今年以来 Coding 领域的最大变量是 AI labs 们的加入,模型大厂纷纷发力,和创业公司共同竞争这一关键场景:两周前,all-in coding 的 Anthropic 更新了 Artifacts 功能,用户可以在聊天界面里直接生成、预览和编辑代码,实现类 vibe coding 的体验;

来自主题: AI资讯
11967 点击    2025-07-07 12:38
Test Time Scaling Law远未达到上限! o4-mini仅15.8%通过率,华为诺亚提出代码HLCE终极基准

Test Time Scaling Law远未达到上限! o4-mini仅15.8%通过率,华为诺亚提出代码HLCE终极基准

Test Time Scaling Law远未达到上限! o4-mini仅15.8%通过率,华为诺亚提出代码HLCE终极基准

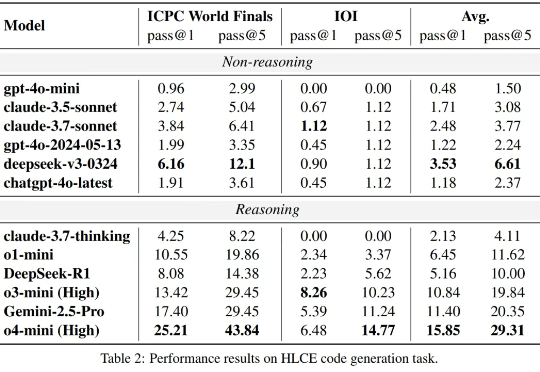
大语言模型(LLM)在标准编程基准测试(如 HumanEval,Livecodebench)上已经接近 “毕业”,但这是否意味着它们已经掌握了人类顶尖水平的复杂推理和编程能力?

来自主题: AI技术研报
9230 点击    2025-07-07 10:39
腾讯入局AI IDE,这次他们直接造了个「AI全栈高级工程师」

腾讯入局AI IDE,这次他们直接造了个「AI全栈高级工程师」

腾讯入局AI IDE,这次他们直接造了个「AI全栈高级工程师」

辣个前端时间爆火的腾讯云代码助手-CodeBuddy。最近出IDE了,还是叫CodeBuddy(不是插件),跟之前的Trae一样,目前先发布的是国际版,codebuddy.ai。现在除了海外的以Cursor为代表的AI IDE之外,国内大厂(字节、阿里、百度、腾讯)纷纷都发布了自己的AI IDE产品。

来自主题: AI资讯
11993 点击    2025-07-07 10:38
人机协同筛出2600万条数据,七项基准全部SOTA,昆仑万维开源奖励模型再迎新突破

人机协同筛出2600万条数据,七项基准全部SOTA,昆仑万维开源奖励模型再迎新突破

人机协同筛出2600万条数据,七项基准全部SOTA,昆仑万维开源奖励模型再迎新突破

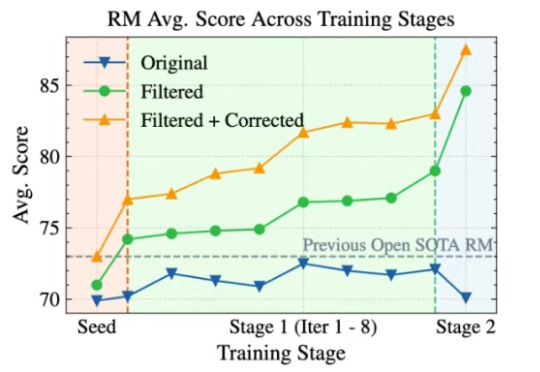
大语言模型(LLM)以生成能力强而著称,但如何能让它「听话」,是一门很深的学问。 基于人类反馈的强化学习(RLHF)就是用来解决这个问题的,其中的奖励模型 (Reward Model, RM)扮演着重要的裁判作用,它专门负责给 LLM 生成的内容打分,告诉模型什么是好,什么是不好,可以保证大模型的「三观」正确。

来自主题: AI技术研报
10121 点击    2025-07-05 12:10
刚刚,Grok4跑分曝光:「人类最后考试」拿下45%,是Gemini 2.5两倍,但网友不信

刚刚,Grok4跑分曝光:「人类最后考试」拿下45%,是Gemini 2.5两倍,但网友不信

刚刚,Grok4跑分曝光:「人类最后考试」拿下45%,是Gemini 2.5两倍,但网友不信

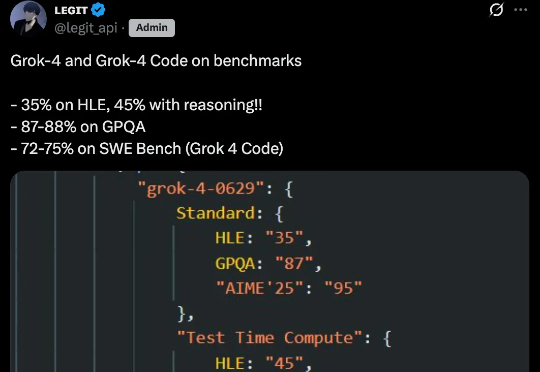
刚刚,Grok 4 和 Grok 4 Code 的基准测试结果疑似泄露。X 博主 @legit_api 发帖称,Grok 4 在 HLE(Humanities Last Exam,人类最后考试)上的标准得分是 35%,使用推理技术后提高到 45%;在 GPQA 上的得分是 87-88%;而Grok 4 Code 在 SWE Bench 上的得分则达到 72-75%。

来自主题: AI资讯
11781 点击    2025-07-05 11:38
Meta-Think ≠ 记套路,多智能体强化学习解锁大模型元思考泛化

Meta-Think ≠ 记套路,多智能体强化学习解锁大模型元思考泛化

Meta-Think ≠ 记套路,多智能体强化学习解锁大模型元思考泛化

最近,关于大模型推理的测试时间扩展(Test time scaling law )的探索不断涌现出新的范式,包括① 结构化搜索结(如 MCTS),② 过程奖励模型(Process Reward Model )+ PPO,③ 可验证奖励 (Verifiable Reward)+ GRPO(DeepSeek R1)。

来自主题: AI技术研报
10684 点击    2025-07-04 09:44
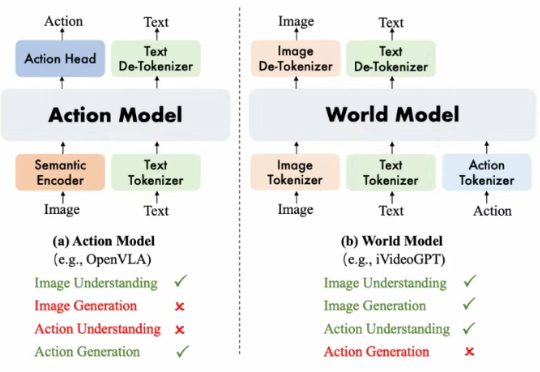
首次!世界模型、动作模型融合,全自回归模型WorldVLA来了

首次!世界模型、动作模型融合,全自回归模型WorldVLA来了

首次!世界模型、动作模型融合,全自回归模型WorldVLA来了

阿里巴巴达摩院提出了 WorldVLA, 首次将世界模型 (World Model) 和动作模型 (Action Model/VLA Model) 融合到了一个模型中。WorldVLA 是一个统一了文本、图片、动作理解和生成的全自回归模型。

来自主题: AI技术研报
9659 点击    2025-07-03 18:59
微软 GitHub Copilot Chat 扩展正式开源

微软 GitHub Copilot Chat 扩展正式开源

微软 GitHub Copilot Chat 扩展正式开源

上个月,微软分享了将 VS Code 打造成开源 AI 编辑器的计划。今天,微软在 VS Code 官网表示已经达成了第一个里程碑:GitHub Copilot Chat 扩展程序现已在 GitHub 上根据 MIT 许可证 开源。

来自主题: AI资讯
8289 点击    2025-07-03 13:26