手把手教机器人:斯坦福大学提出RTR框架,让机械臂助力人形机器人真机训练
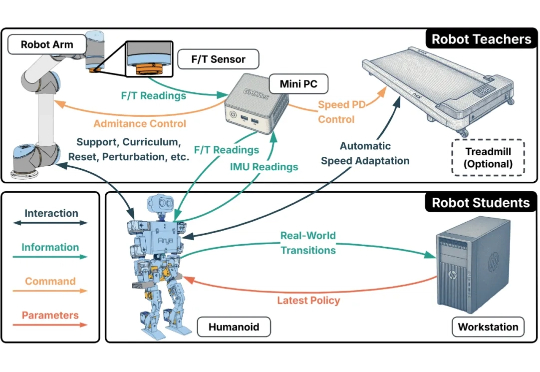
手把手教机器人:斯坦福大学提出RTR框架,让机械臂助力人形机器人真机训练人形机器人的运动控制,正成为强化学习(RL)算法应用的下一个热点研究领域。当前,主流方案大多遵循 “仿真到现实”(Sim-to-Real)的范式。研究者们通过域随机化(Domain Randomization)技术,在成千上万个具有不同物理参数的仿真环境中训练通用控制模型,期望它能凭借强大的泛化能力,直接适应动力学特性未知的真实世界。
搜索
人形机器人的运动控制,正成为强化学习(RL)算法应用的下一个热点研究领域。当前,主流方案大多遵循 “仿真到现实”(Sim-to-Real)的范式。研究者们通过域随机化(Domain Randomization)技术,在成千上万个具有不同物理参数的仿真环境中训练通用控制模型,期望它能凭借强大的泛化能力,直接适应动力学特性未知的真实世界。
只靠说话和AI眼镜互动,确实有点不方便。现在新玩法来了!数字替身帮你“隔空抓物”,混合现实即时选择现实世界的物体作为上下文。
假作真时真亦假,无为有处有还无。
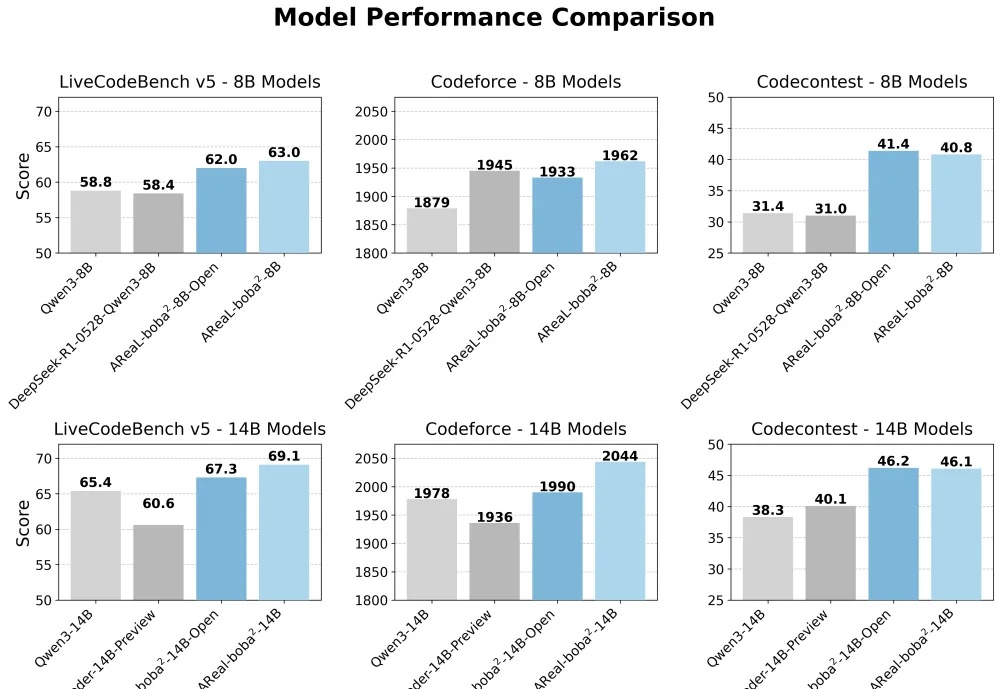
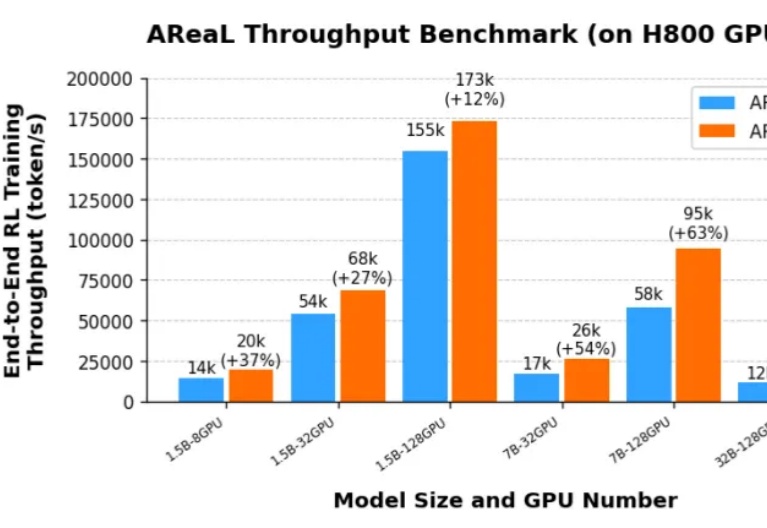
清华与蚂蚁联合开源AReaL-boba²,实现全异步强化学习训练系统,有效解耦模型生成与训练流程,GPU利用率大幅提升。14B模型在多个代码基准测试中达到SOTA,性能接近235B模型。异步RL训练上大分!
AI 并非突然突破,而是一项长期投资,旨在改变企业运营模式,最终让复杂流程更智能。
想训练属于自己的高性能推理模型,却被同步强化学习(RL)框架的低效率和高门槛劝退?AReaL 全面升级,更快,更强,更好用!
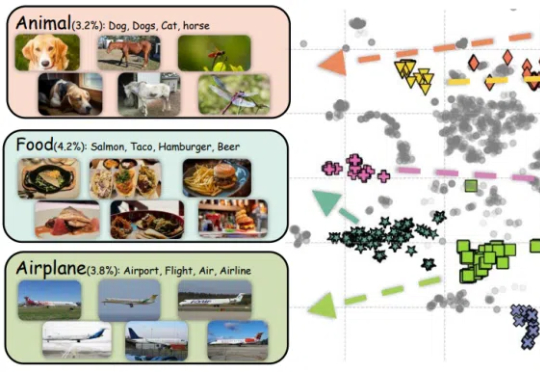
新的亿级大规模图文对数据集来了,CLIP达成新SOTA!
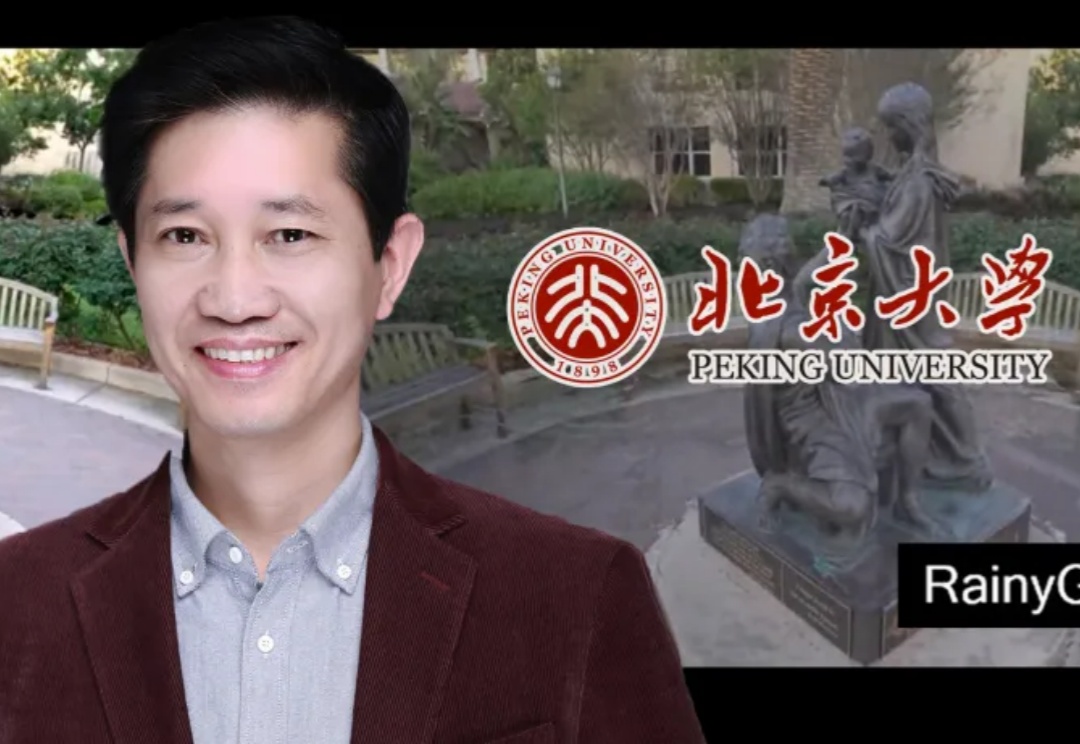
北京大学陈宝权教授团队提出RainyGS技术,通过结合物理模拟和3D高斯泼溅渲染框架,实现了真实场景中动态雨效的高质量仿真与呈现,真正实现「从真实到真实」,或者「以仿真乱真」,即Real2Sim2Real !相比现有的视频编辑工具(如 Runway),其物理真实性获得保证。
从Google Glasses到HoloLens,再到近几年雷鸟创新、Even Realities、影目、星纪魅族、Rokid等陆续发布量产产品,AR眼镜在不断刷新其轻薄程度。
由于 DeepSeek R1 和 OpenAI o1 等推理模型(LRM,Large Reasoning Model)带来了新的 post-training scaling law,强化学习(RL,Reinforcement Learning)成为了大语言模型能力提升的新引擎。然而,针对大语言模型的大规模强化学习训练门槛一直很高: