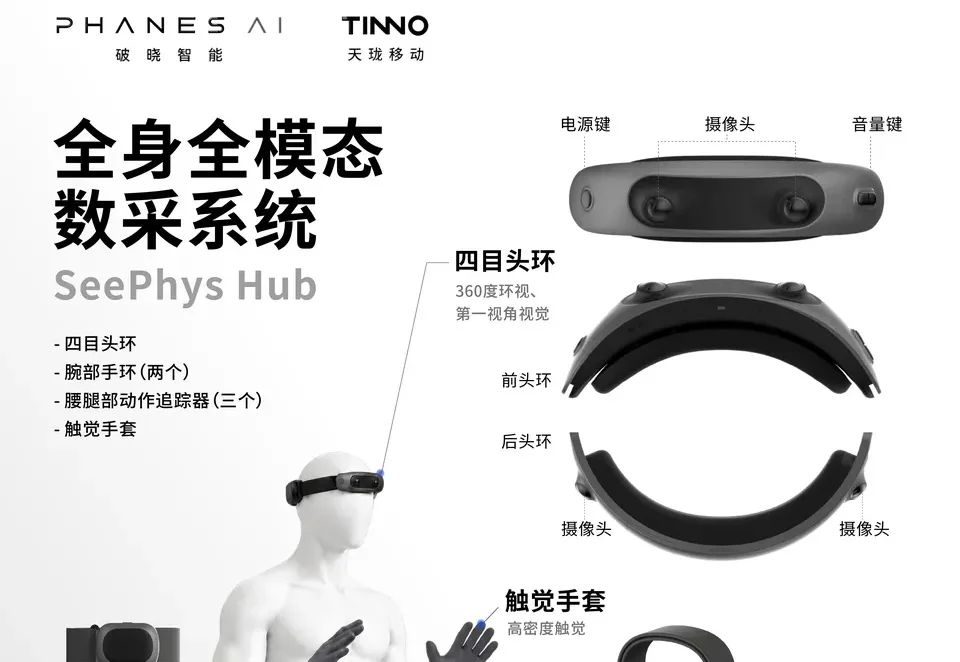
国内最年轻AI教授创业:要让世界模型走向全身全模态
国内最年轻AI教授创业:要让世界模型走向全身全模态数据越采越多,机器人就能越来越会干活吗?
来自主题: AI资讯
10092 点击 2026-10-14 11:55

 搜索
数据越采越多,机器人就能越来越会干活吗?
相比以往的Agent工具,9月8日正式上线的Muse,凭借更低的使用门槛和更便捷的操作体验,迅速走出技术圈,吸引更广泛的普通用户关注。
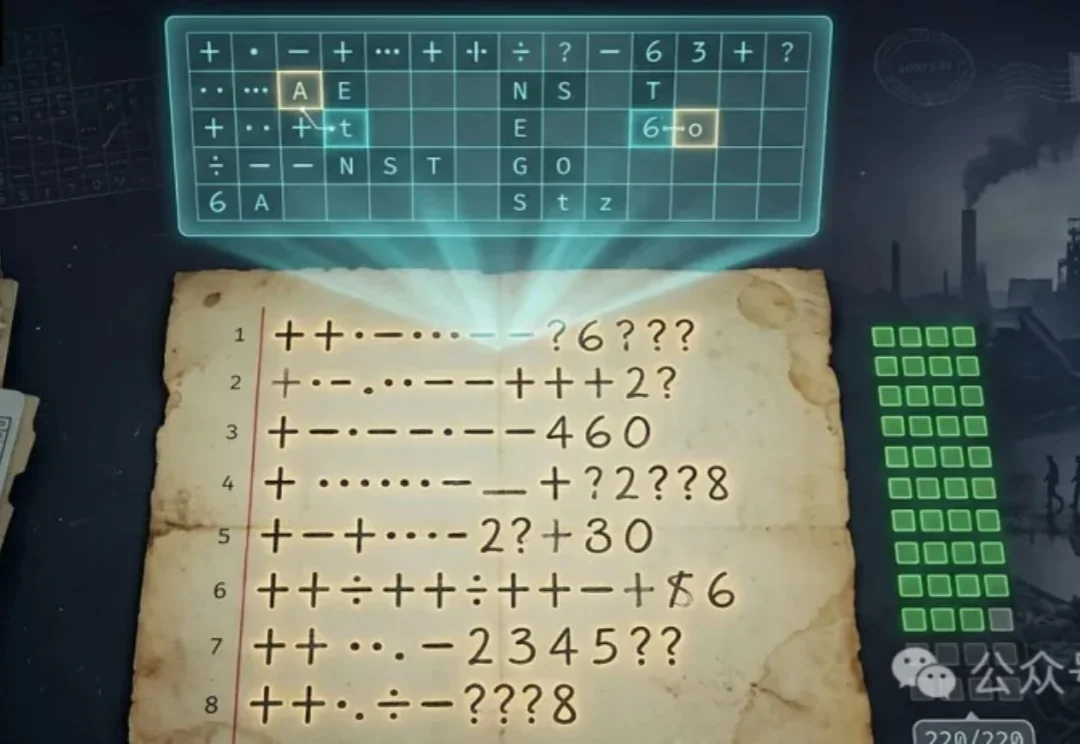
九位同志,去俄斯特拉发,待上一年。
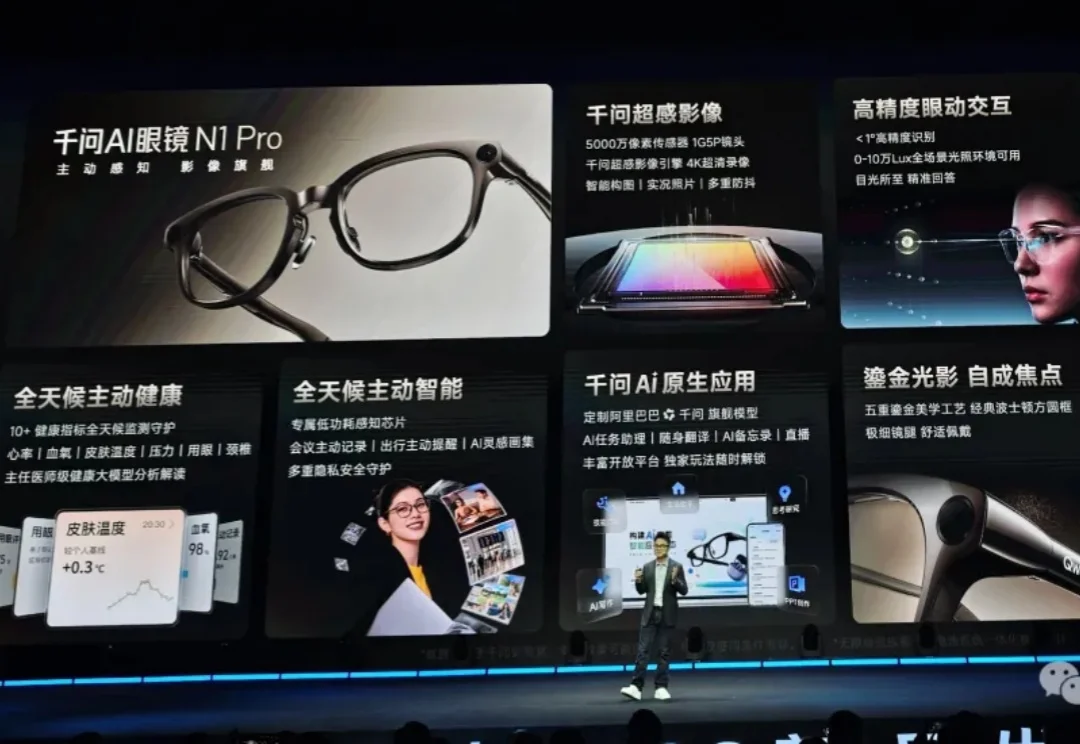
不用说话、不用按钮,现在的AI眼镜戴上就能自动上班了。
事情大家都知道了,田柯宇昨天一炒作,一堆人联合出来打假田神,不仅列时间线、列代码、还列上了自己的Github主页,搞学术的就是严谨啊👇 https://keyu-tian-sabotage.github.io
OpenAI正与一家影视制作AI视频初创公司洽谈,拟向其开放已关停的Sora模型使用权并针对影视制作深度定制,若达成协议,OpenAI将获得该公司部分股权。
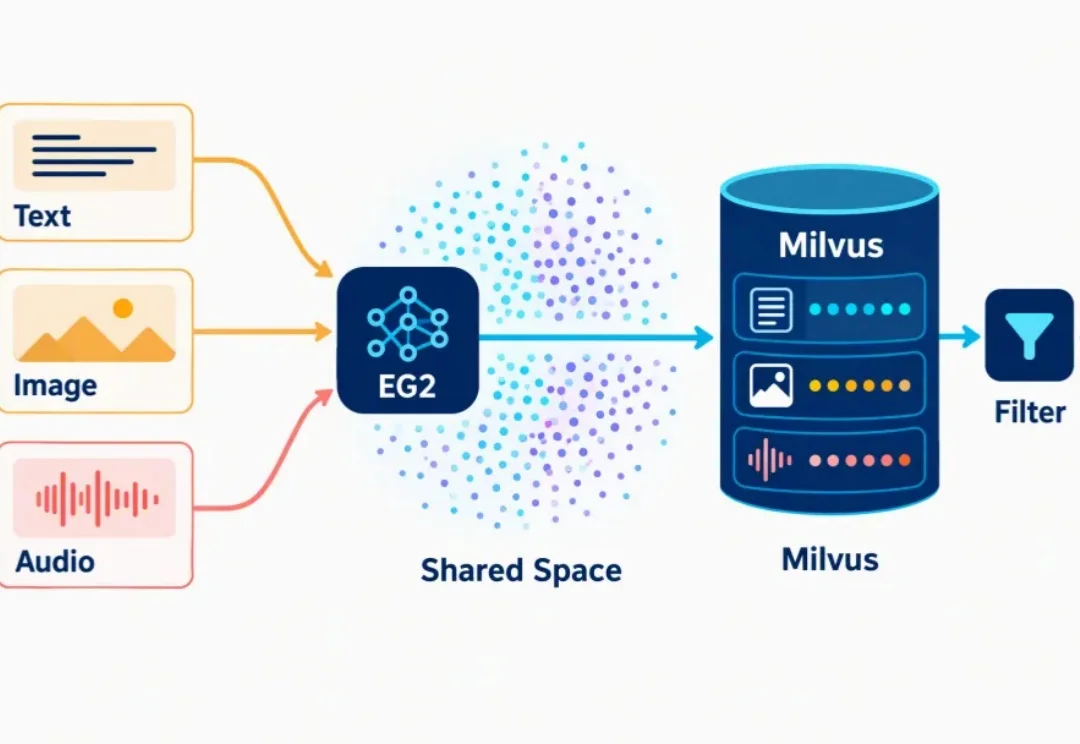
传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
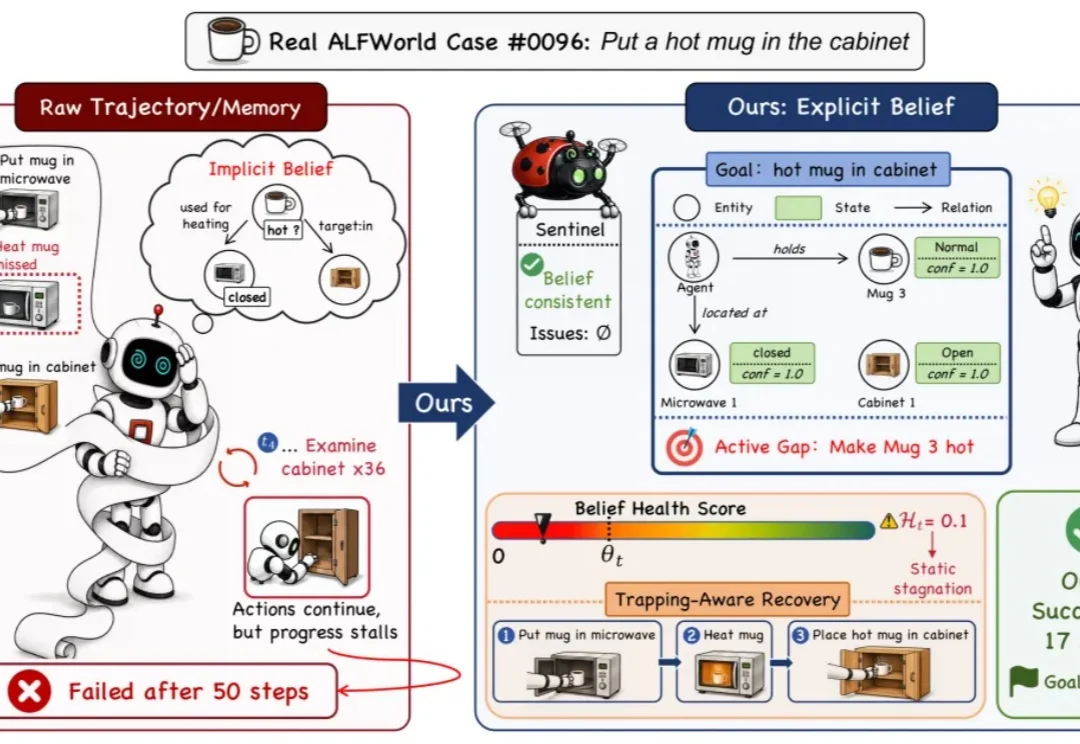
任务很简单:把一个加热后的杯子放进柜子。一个智能体先把杯子放进微波炉,再放进柜子,随后陷入反复查看柜子的循环。这个无效行为重复了 36 次,直到耗尽行动预算,任务仍然没有完成。
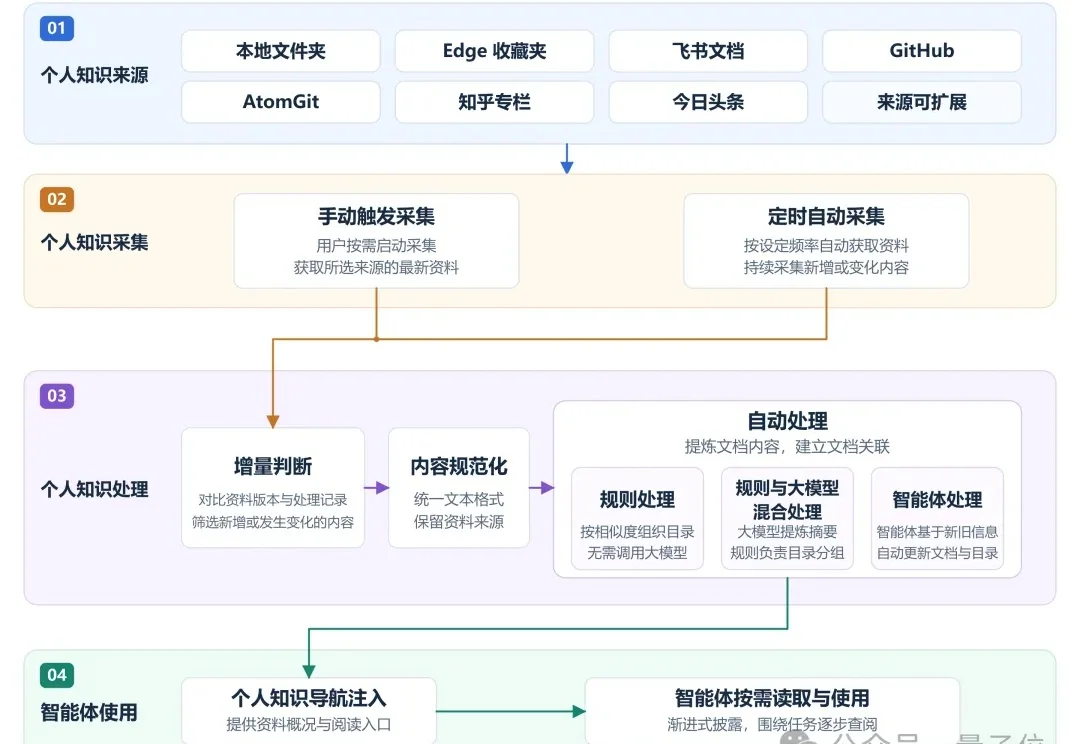
让Agent写周报、分析方案,已经是许多人的日常。但每次开始,用户还得翻找资料、交代背景,智能体也要经过查找、阅读、整理等多个步骤,才能真正开始任务。换个任务,这套流程又得重来。反复处理这些已有资料,既费时间,也增加token消耗。资料越多、步骤越长,还越容易遗漏信息或出现偏差,影响任务完成的准确率。
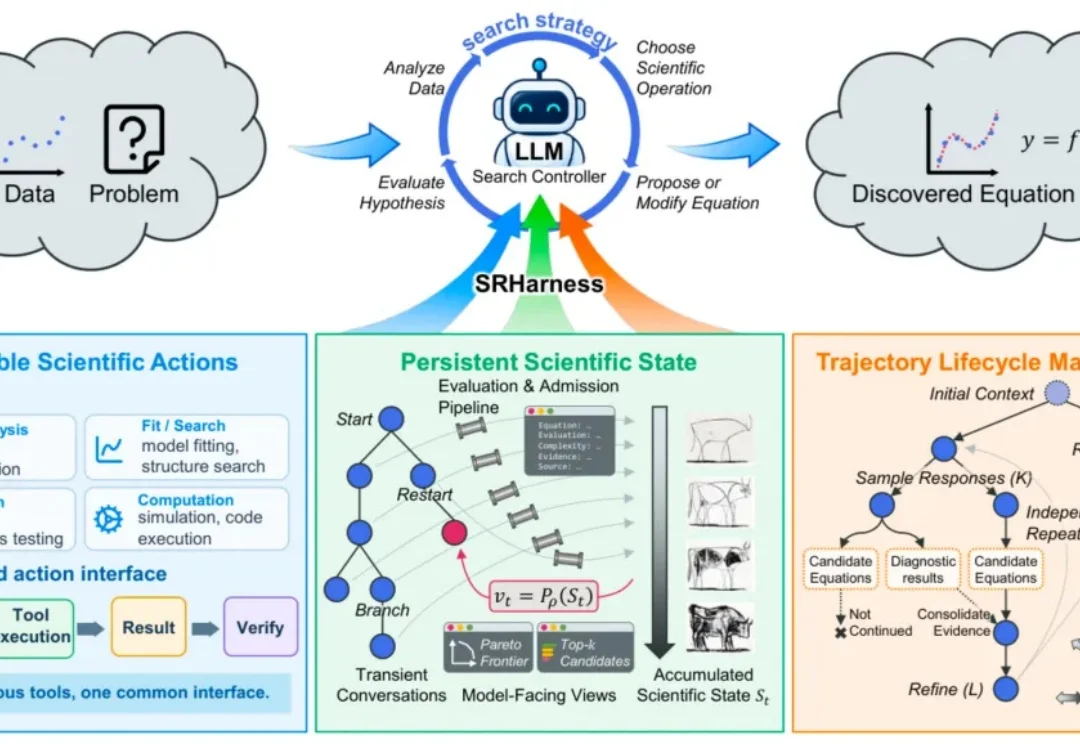
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。