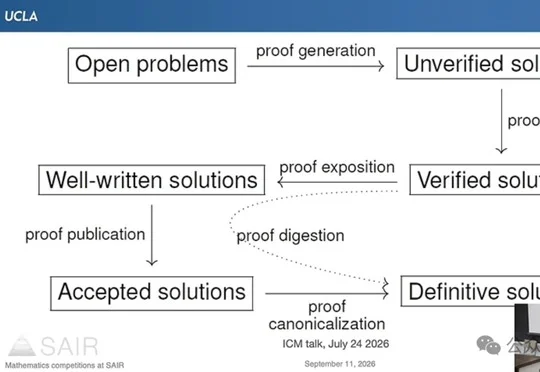
不er,咋陶哲轩也成AI减速派了??
不er,咋陶哲轩也成AI减速派了??陶哲轩在SAIR最新演讲中呼吁AI公司放慢数学解题速度,称AI量产证明却缺乏理解、阐释和传播,将引发“Proof Indigestion”与数据污染风险。
来自主题: AI资讯
10881 点击 2026-10-07 15:19

 搜索
陶哲轩在SAIR最新演讲中呼吁AI公司放慢数学解题速度,称AI量产证明却缺乏理解、阐释和传播,将引发“Proof Indigestion”与数据污染风险。
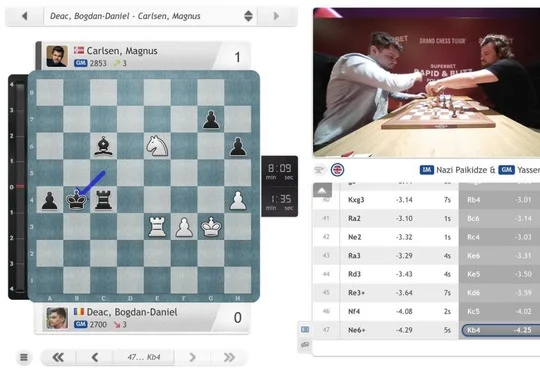
普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
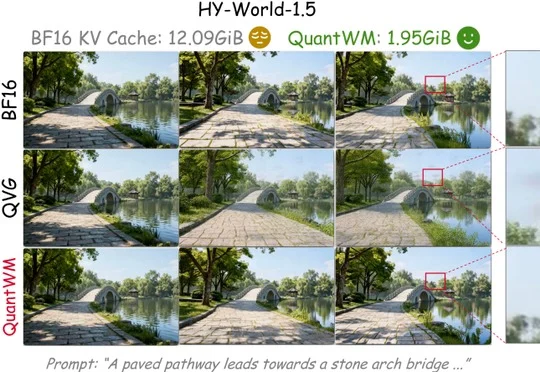
哈尔滨工业大学(深圳)iLearn-Lab与新加坡国立大学LV-Lab提出免训练2-bit KV Cache量化框架QuantWM,改善视频世界模型量化后的时序闪烁与画质,并实现最高6.20倍缓存压缩。
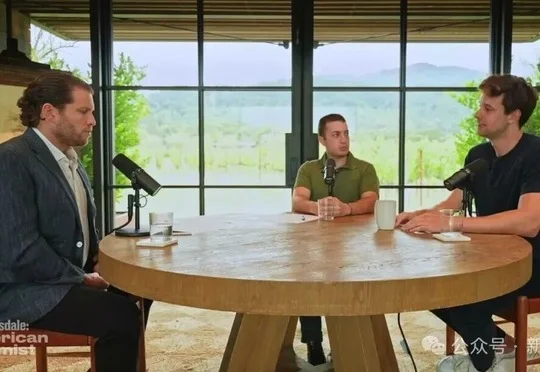
Anthropic强化学习技术负责人Sholto Douglas预测,能力等于甚至超过所有人类的AGI可能在未来几年内出现,2028年AI年度资本开支或达4万亿美元,而研究员Nick Marwell对AI无需人类搭档后的后果表示紧张。
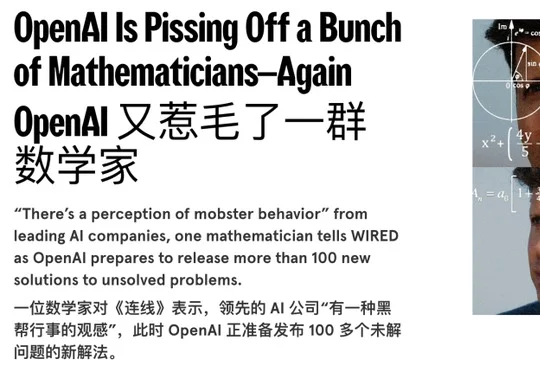
OpenAI在GitHub的openai/math仓库公开722份数学手稿,涉及372个问题家族及Lean形式化证明,并表示多数结果来自未发布的内部模型,部分未形式化结果可能存在问题。
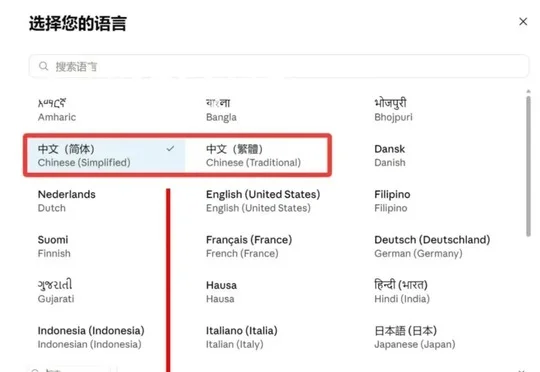
Claude网页端和桌面端新增简体中文、繁体中文界面,但中国大陆及港澳仍不在Anthropic官方支持地区范围内。
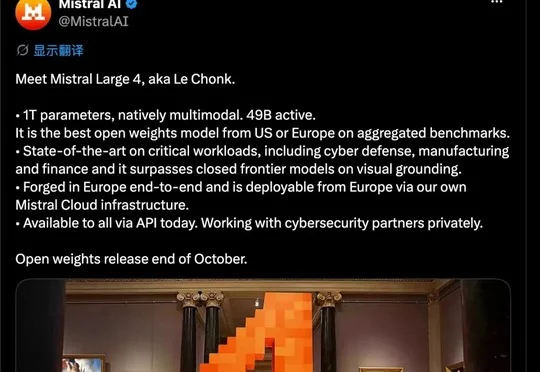
Mistral 发布 Mistral Large 4,采用细粒度混合专家结构,总参数1.05T、每次激活49B,支持图文输入和100万上下文,API现已开放,权重计划于10月27日发布。
据彭博社报道,DeepSeek即将敲定至少800亿元人民币的新一轮融资,腾讯和宁德时代承诺出资金额居前,该轮融资拟为2027年初IPO铺路,但最终条款仍未确定。
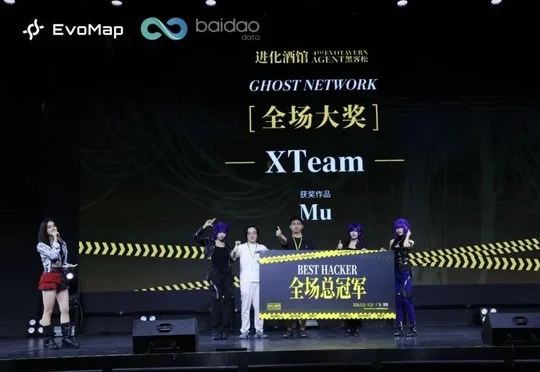
开源项目mu(μ)在进化酒馆黑客松深圳收官战中夺冠,其将Jev深度融合进Harness,通过35个判定点优化上下文管理与多Agent通信。
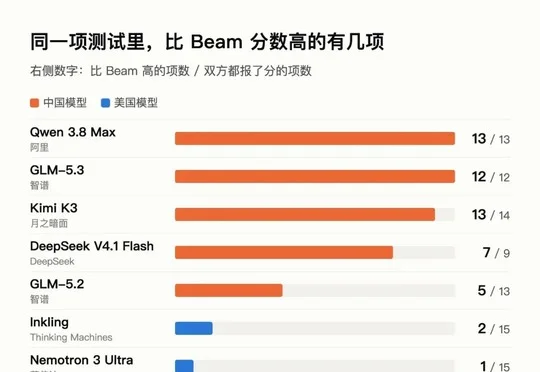
英伟达投资的Reflection发布开源模型Beam,采用MoE架构,专注代码、推理和Agent任务,官方称其以GLM-5.2三分之一至四分之一的推理算力取得相当成绩,但原始能力仍落后部分前沿开源模型,计划月底以Apache 2.0放出权重。