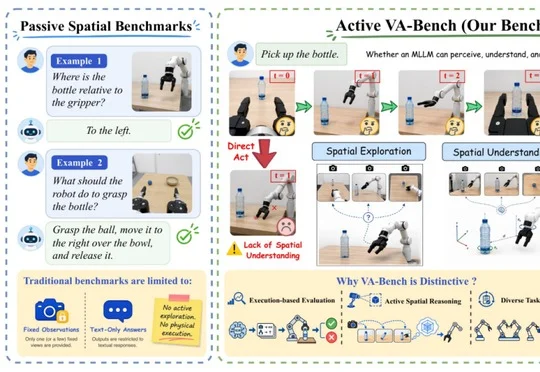
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自主题: AI技术研报
9598 点击 2026-10-05 23:29

 搜索
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
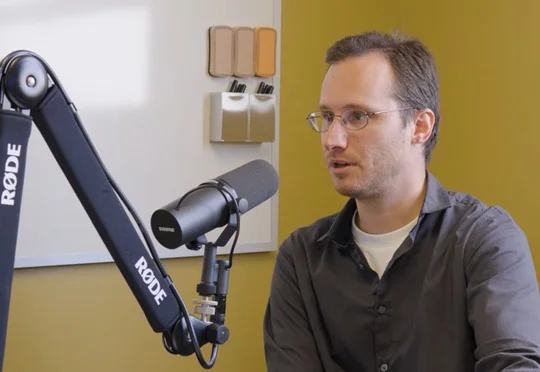
Physical Intelligence联合创始人Sergey Levine指出,机器人尚未进入稳定缩放阶段,应以先验知识、有效决策循环和多样化数据提升泛化与可靠性,并在找到真正可规模化的技术后扩大投入。
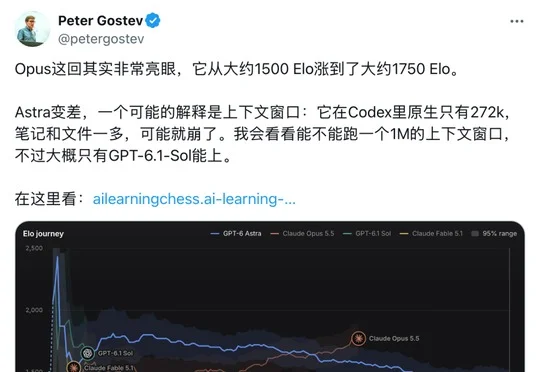
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。
来自上海创智学院、复旦大学、伦敦国王学院与牛津大学等机构的研究团队推出SocioVerse2,将大模型社会模拟扩展为可干预、可迭代、可回溯的开源社会科学研究框架。
Harvey联合创始人Gabe Pereyra表示,AI应用公司不必与大模型公司比拼资金和算力,可借助真实任务评测、领域专家、开源模型和外部研究团队建立持续学习能力。
AMD以约82亿美元股票收购李飞飞创办的World Labs后,作者认为交易更看重人才与模型理解而非成熟产品,并批评世界模型标签滥用及AI圈压制对低质产品的批评。
魔芯科技让4D世界模型MoWorld首次进入华为Mate 90的鸿蒙应用摸小宠,可基于少量照片生成可自由浏览、支持动态与物理交互的4D场景。
UC Berkeley教授宋晓冬带领的Virtue AI团队于今年6月加入Meta超级智能实验室,仅4个月后便因"工作风格不合"被曝遭裁减,合作疑似终止。
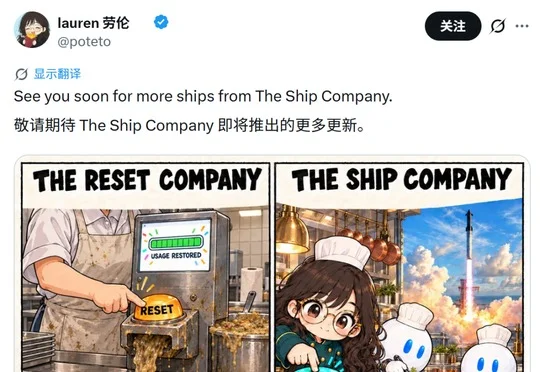
OpenAI在开发者日后因GPT-6.1 Sol实际体验不及预期、使用额度收紧等问题遭遇用户信任危机,Tibo承诺未来将进行连续28天发布或重置,并将简化产品、提高效率作为核心方向,以兑现此前过度宣传的承诺。
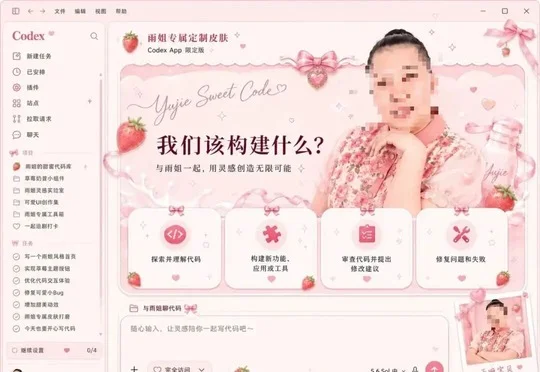
如果你妄图通过 Claude 执行 rm -rf node_modules 守护一方安宁的雨姐就会把你拦下:“整这死出呢?这命令不好使!想都别想” 然后面板里“拦下”那一栏记了 +1 Claude 要