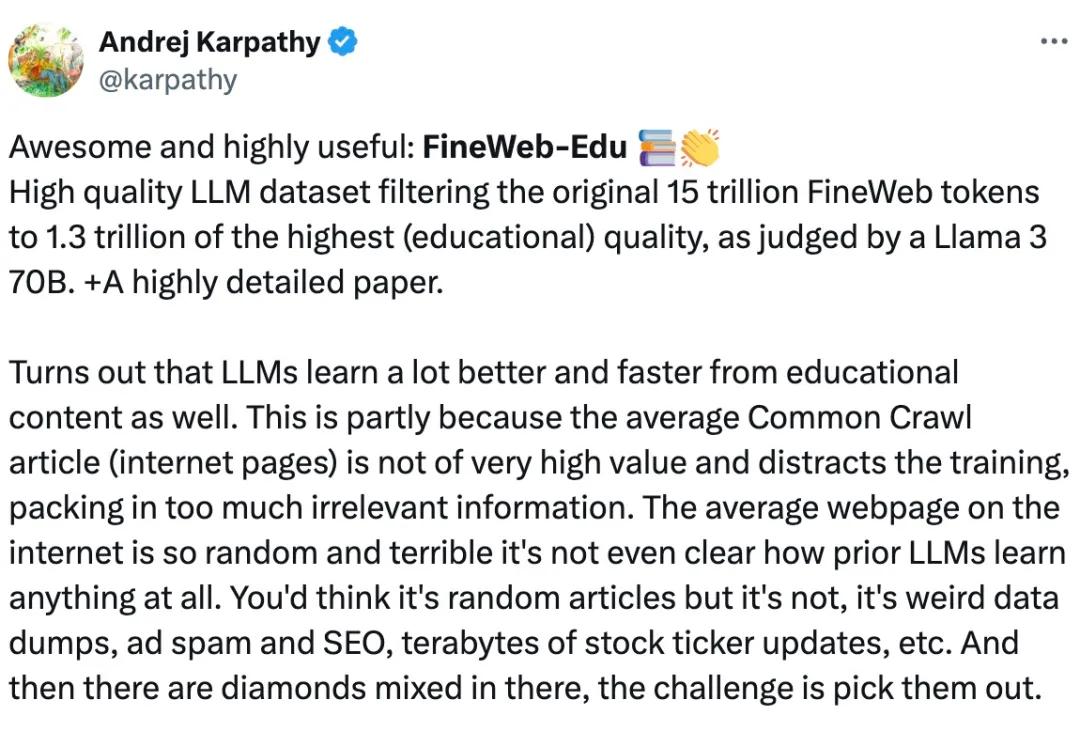
Karpathy点赞,这份报告教你如何用 LLaMa 3创建高质量网络数据集
Karpathy点赞,这份报告教你如何用 LLaMa 3创建高质量网络数据集众所周知,对于 Llama3、GPT-4 或 Mixtral 等高性能大语言模型来说,构建高质量的网络规模数据集是非常重要的。然而,即使是最先进的开源 LLM 的预训练数据集也不公开,人们对其创建过程知之甚少。
来自主题: AI技术研报
10777 点击 2024-06-04 17:45

 搜索
众所周知,对于 Llama3、GPT-4 或 Mixtral 等高性能大语言模型来说,构建高质量的网络规模数据集是非常重要的。然而,即使是最先进的开源 LLM 的预训练数据集也不公开,人们对其创建过程知之甚少。
自 2017 年被提出以来,Transformer 已经成为 AI 大模型的主流架构,一直稳居语言建模方面 C 位。
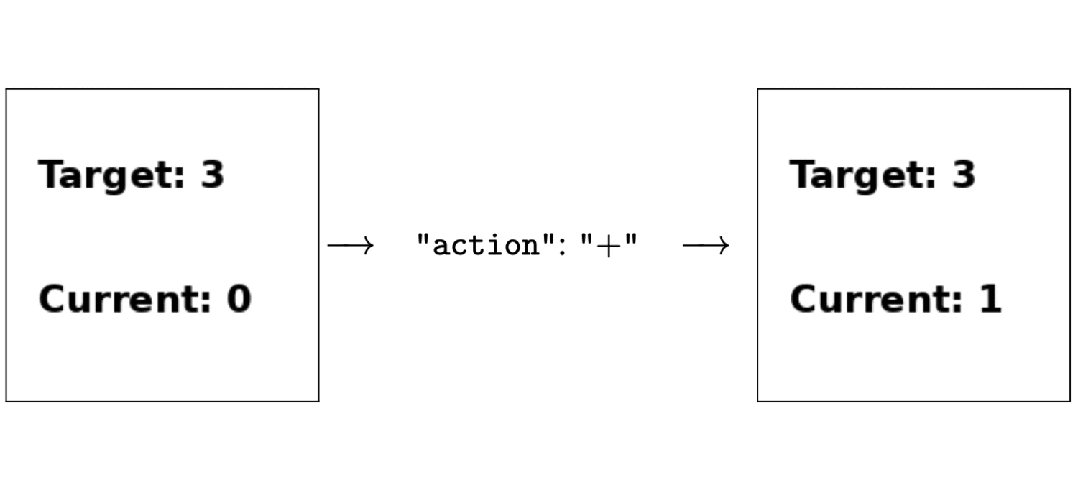
只用强化学习来微调,无需人类反馈,就能让多模态大模型学会做决策!
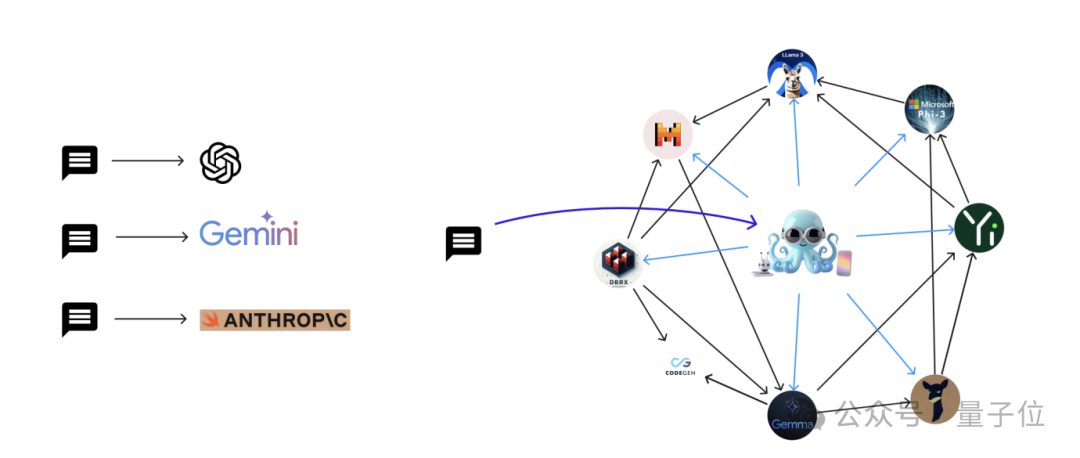
大模型,大,能力强,好用!

Transformer挑战者、新架构Mamba,刚刚更新了第二代:
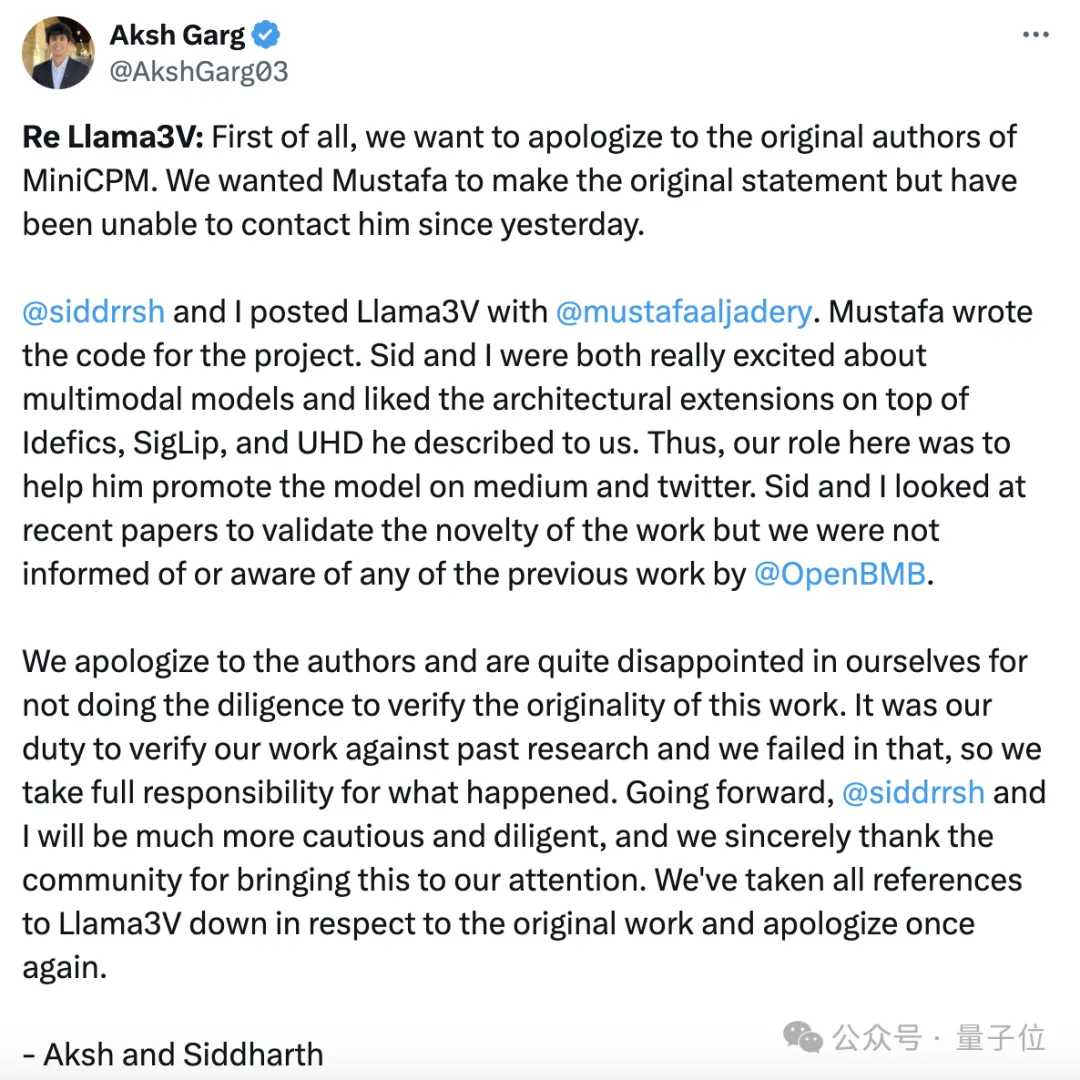
斯坦福团队抄袭清华系大模型事件后续来了—— Llama3-V团队承认抄袭,其中两位来自斯坦福的本科生还跟另一位作者切割了。
华南理工大学和香港大学的研究人员在ICML 2024上提出了一个简单而通用的时空提示调整框架FlashST,通过轻量级的时空提示网络和分布映射机制,使预训练模型能够适应不同的下游数据集特征,显著提高了模型在多种交通预测场景中的泛化能力。
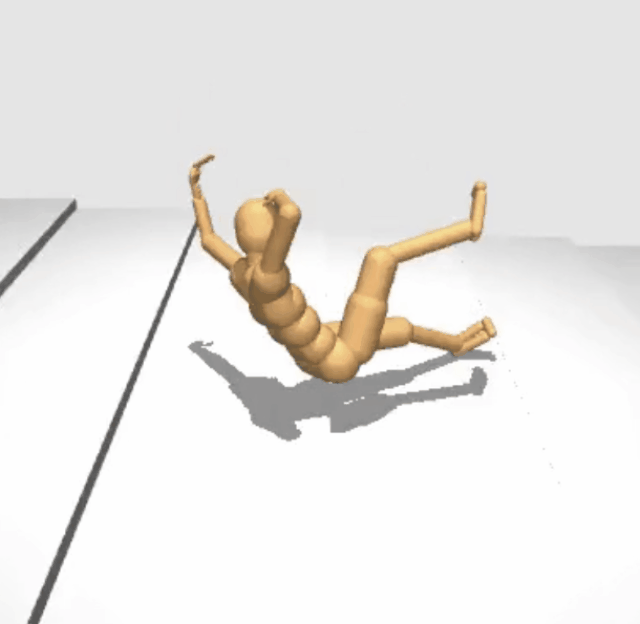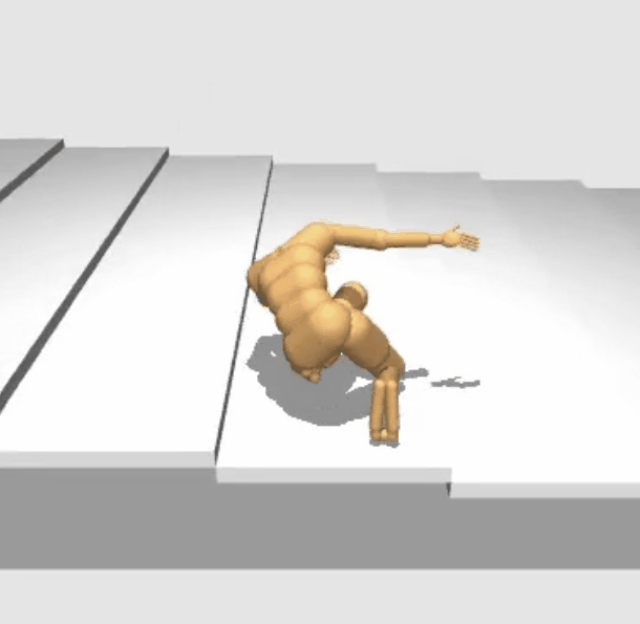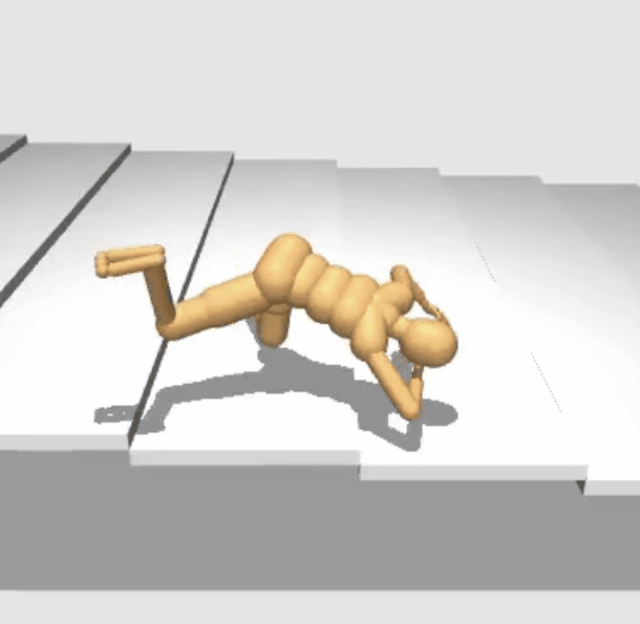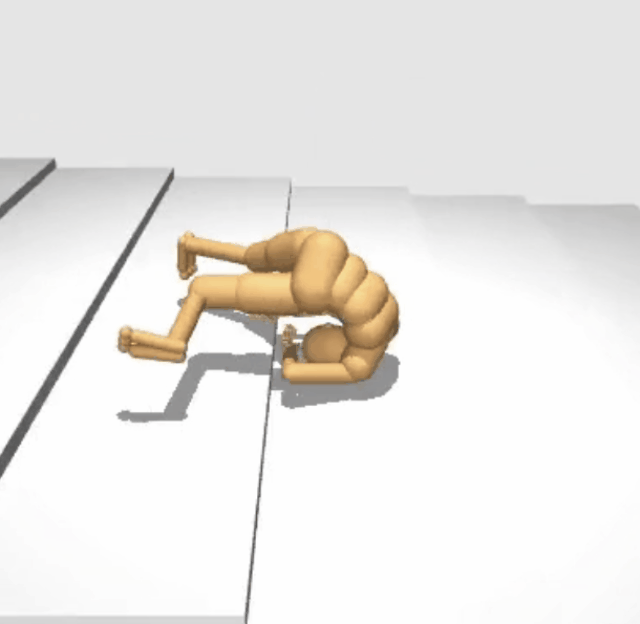
在复杂的物理世界中,人型机器人的全身控制一直是个难题,现有的强化学习做出的效果有时会比较抽象。近日,LeCun参与的一项工作给出了基于数据驱动的全新解决方案。
微软发布首个大规模大气基础模型Aurora,可被用于预测和减轻极端天气影响,模型拥有超高的准确率和效率,与如今数值预报系统界的SOTA相比,它的计算速度提高了约5000倍。
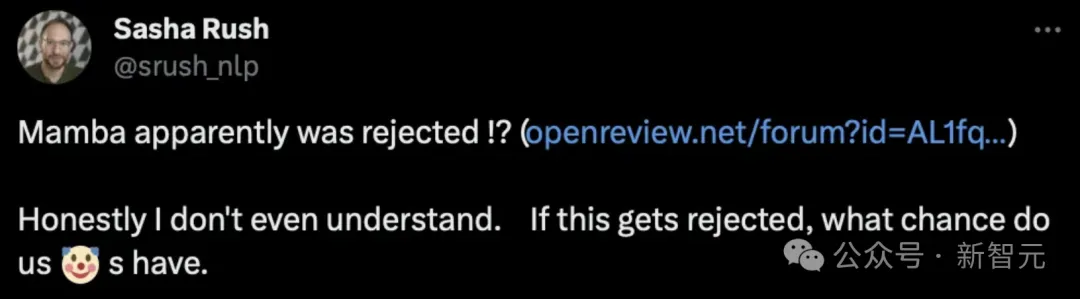
在开源社区引起「海啸」的Mamba架构,再次卷土重来!这次,Mamba-2顺利拿下ICML。通过统一SSM和注意力机制,Transformer和SSM直接成了「一家亲」,Mamba-2这是要一统江湖了?