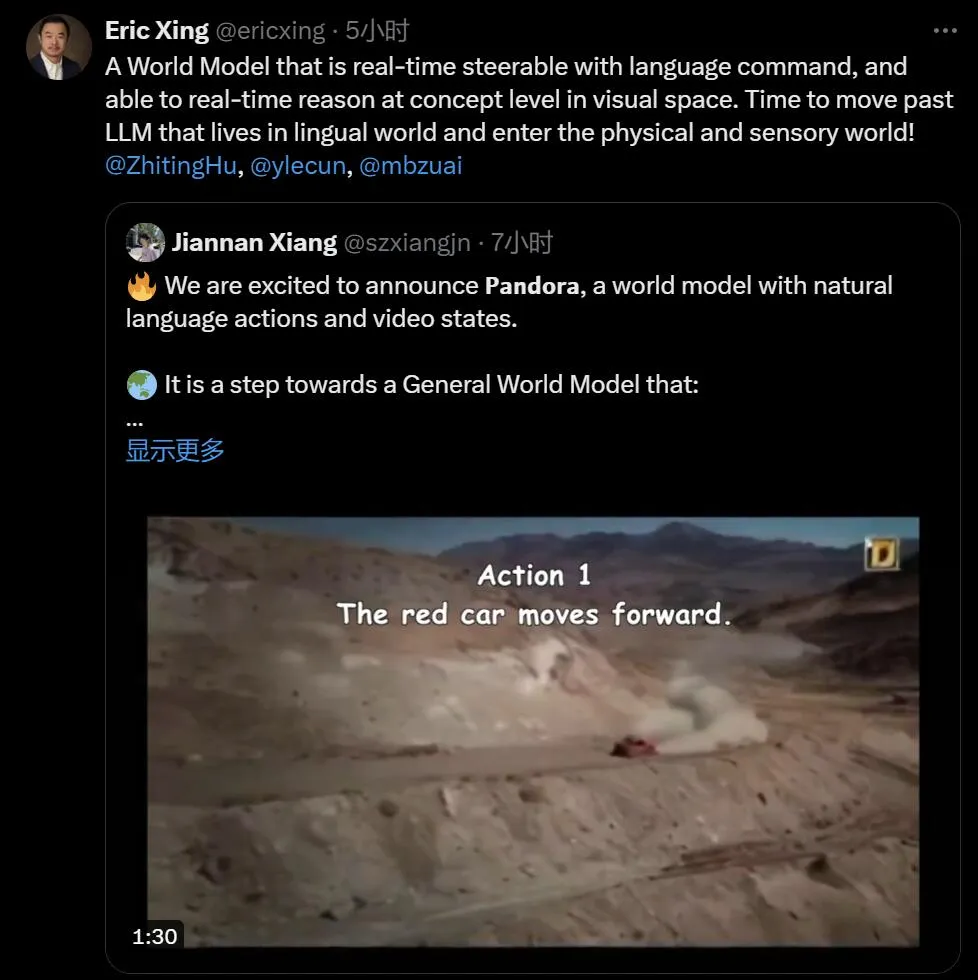
通用世界模型问世:不学习就能生成新领域视频,可实时控制
通用世界模型问世:不学习就能生成新领域视频,可实时控制这才是 AI 视频生成的未来?
来自主题: AI资讯
10009 点击 2024-05-24 20:48

 搜索
这才是 AI 视频生成的未来?
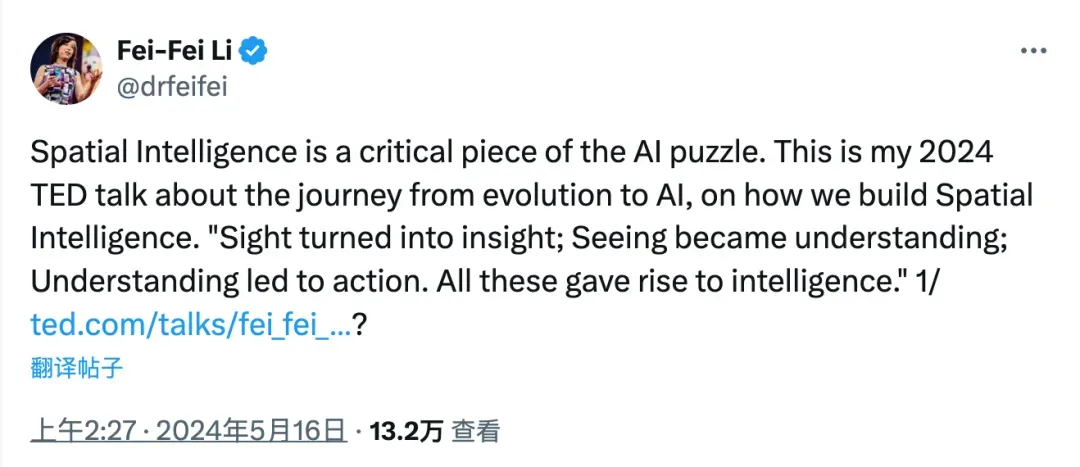
归根结底,大模型的方向还是走错了?
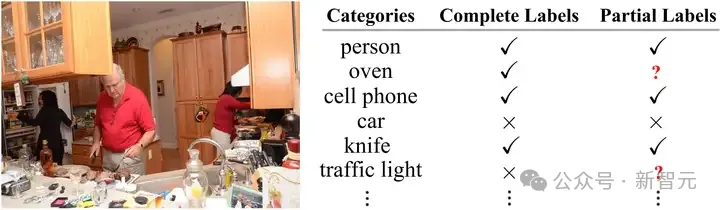
在多标签图像识别领域中,由于图像本身和潜在标签类别的复杂性,收集满足现有模型训练的多标签标注信息往往成本高昂且难以拓展。中山大学联合广东工业大学联手探索标注受限情况下的多标签图像识别任务,通过对多标签图像中的强语义相关性的探索研究,提出了一种异构语义转移(Heterogeneous Semantic Transfer, HST) 框架,实现了有效的未知标签生成。

全世界的目标再次聚焦在巴黎科技活动上的OpenAI。这次,开发者体验负责人带来了更多GPT-4o精彩演示,根据地图导航,修改代码惊艳了在场400+位观众。不仅如此,OpenAI GPT模型路线图曝出,网友推算预计11月发布。

在一个繁忙过后的周五晚上,美食发烧友Melissa和朋友痛快的享受了一顿海底捞火锅,餐毕,她像往常一样留下了服务评价,及时反馈是一位美食家的基本素养。

大家都想“看看牌”。 中国投资圈一度熙熙攘攘的德州扑克牌局,忽然沉寂下去。

大模型价格战打得火热 这几天,大模型的价格战打得火热。模型价格一降再降,百度、科大讯飞、腾讯甚至直接宣布免费。

目标大模型「超级应用」。
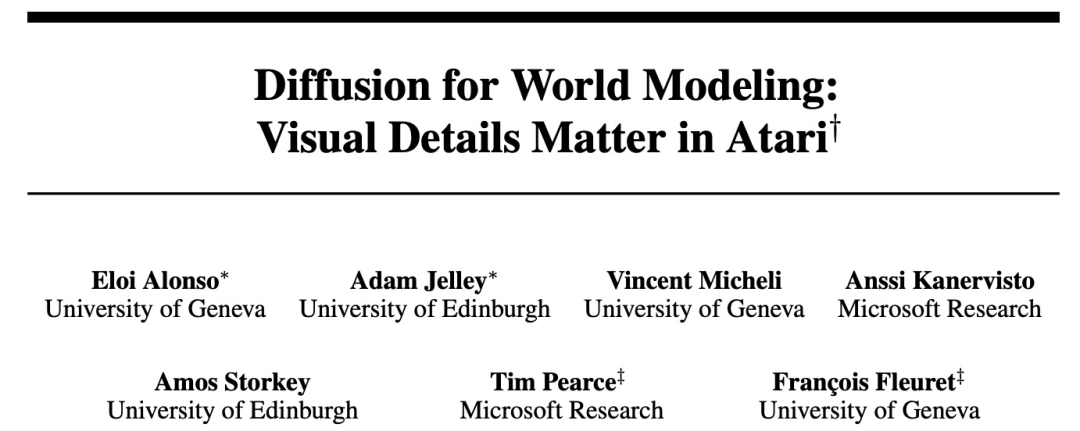
在图像生成领域占据主导地位的扩散模型,开始挑战强化学习智能体。

AI大模型,即将覆盖我们的出行生活。