Transformer解码真实场景!Meta推出70M参数SceneScript模型
Transformer解码真实场景!Meta推出70M参数SceneScript模型抛弃传统方法,只采用Transformer来解码真实场景!
来自主题: AI技术研报
11124 点击 2024-04-27 12:37

 搜索
抛弃传统方法,只采用Transformer来解码真实场景!
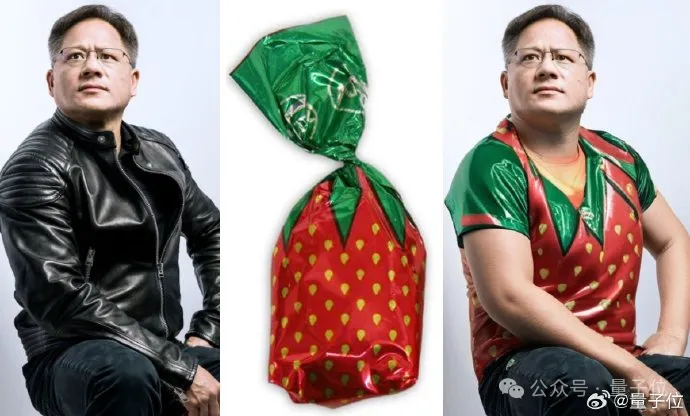
笑不活,最新虚拟试穿神器被网友们玩坏了。 黄院士、马斯克、奥特曼、史密斯等一众大佬衣服集体被扒。
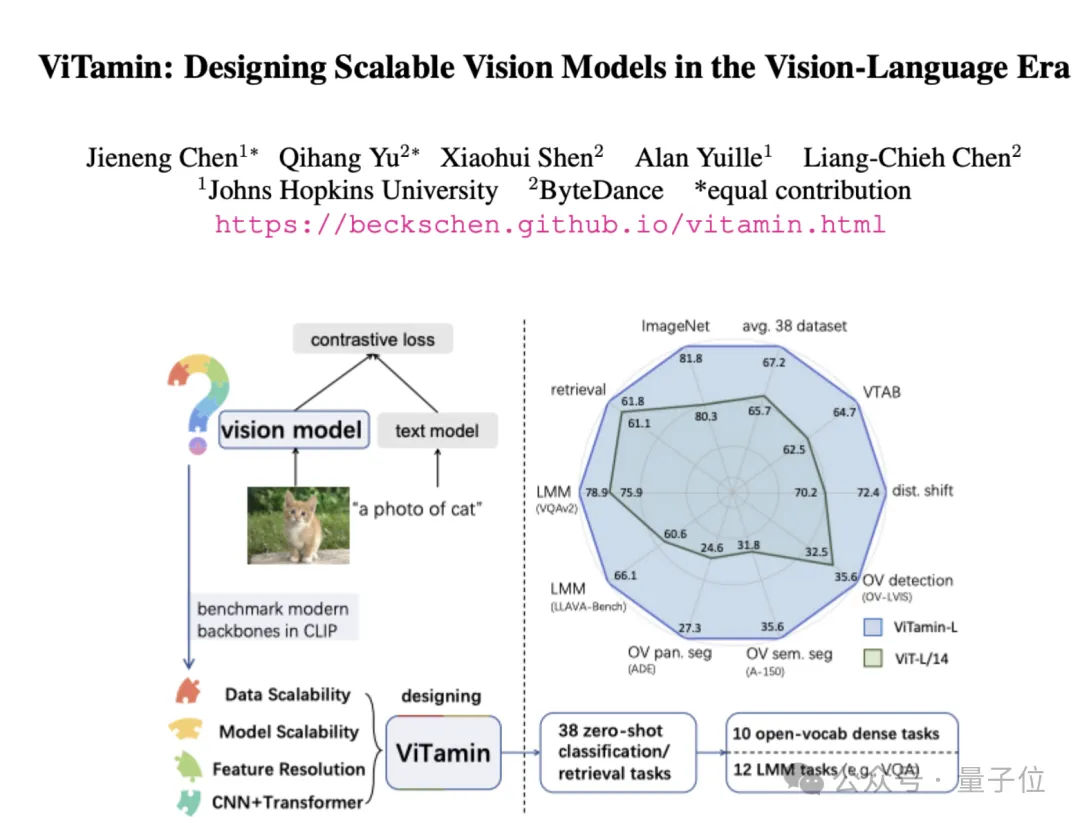
视觉语言模型屡屡出现新突破,但ViT仍是图像编码器的首选网络结构。
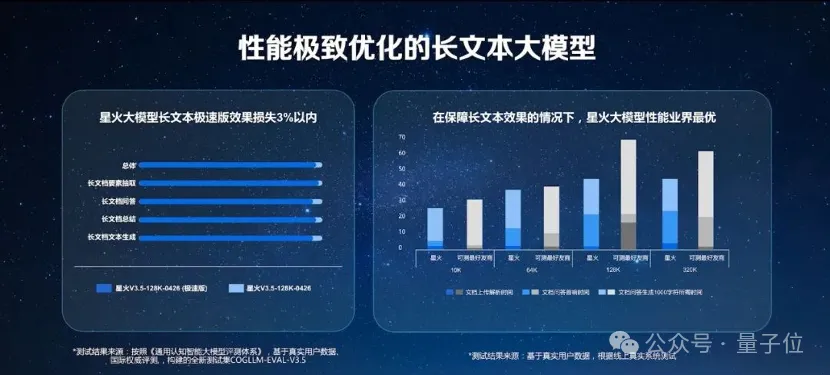
这一次,大模型真的可以让人类解放双手了。
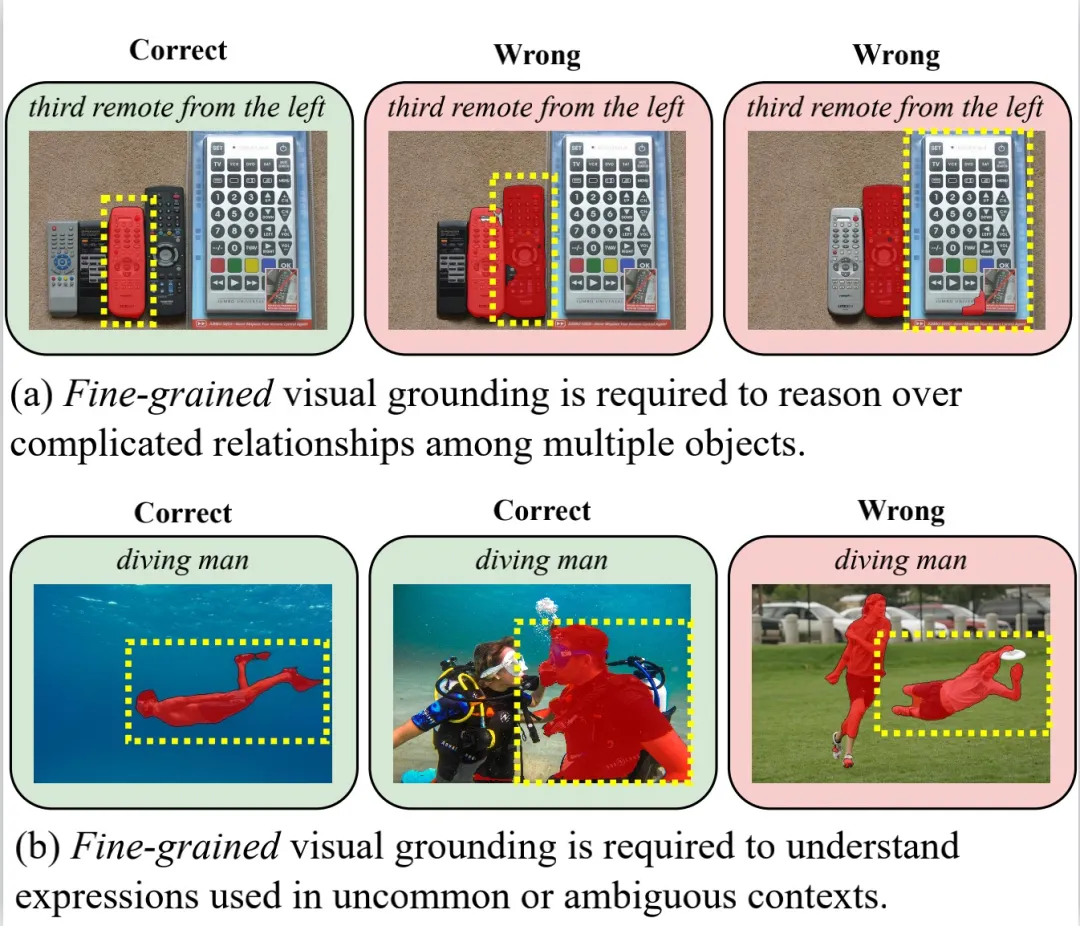
指代分割 (Referring Image Segmentation,RIS) 是一项极具挑战性的多模态任务,要求算法能够同时理解精细的人类语言和视觉图像信息,并将图像中句子所指代的物体进行像素级别的分割。
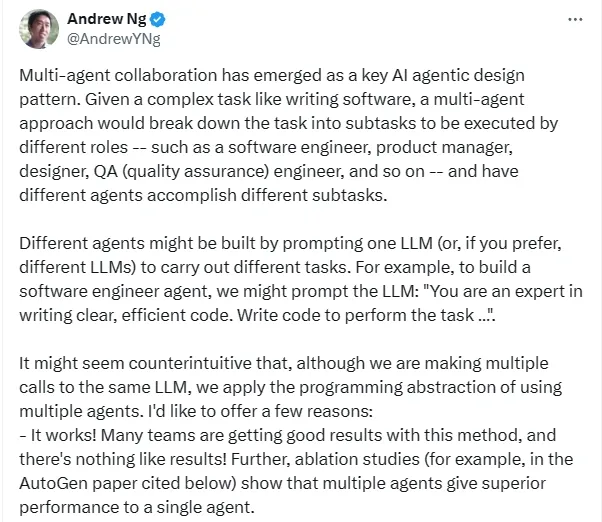
前不久,斯坦福大学教授吴恩达在演讲中提到了智能体的巨大潜力,这也引起了众多讨论。其中,吴恩达谈到基于 GPT-3.5 构建的智能体工作流在应用中表现比 GPT-4 要好。这表明,将目光局限于大模型不一定可取,智能体或许会比其所用的基础模型更加优秀。
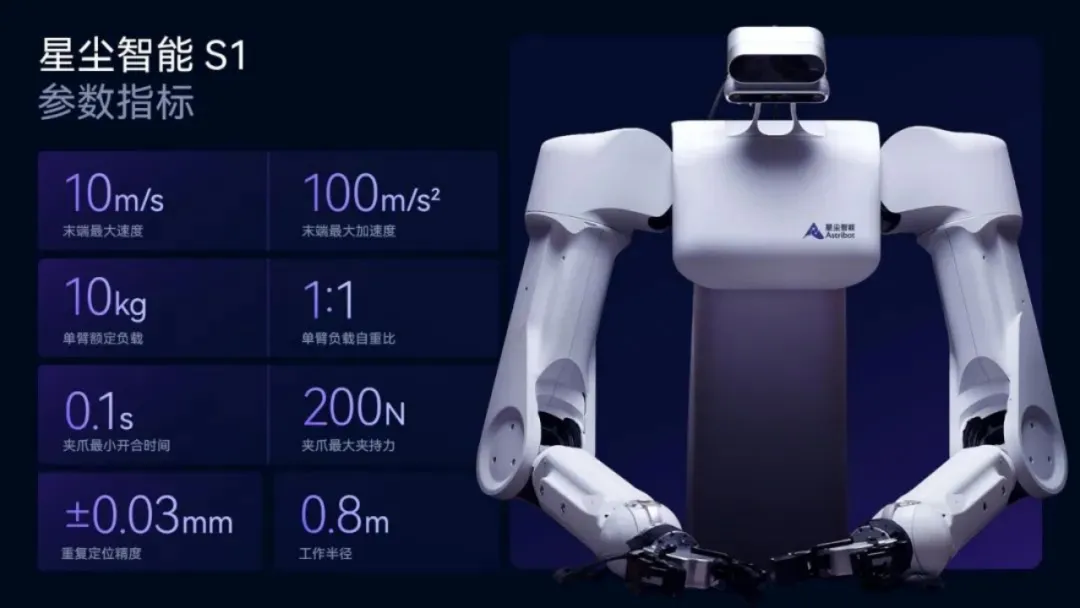
随着 AI 向 AGI(通用人工智能)的圣杯方向加速发展,大模型与机器人的结合是必然趋势。数十年来,单一用途机器人市场已趋于饱和,AI 通用机器人的巨大潜力急待开垦。
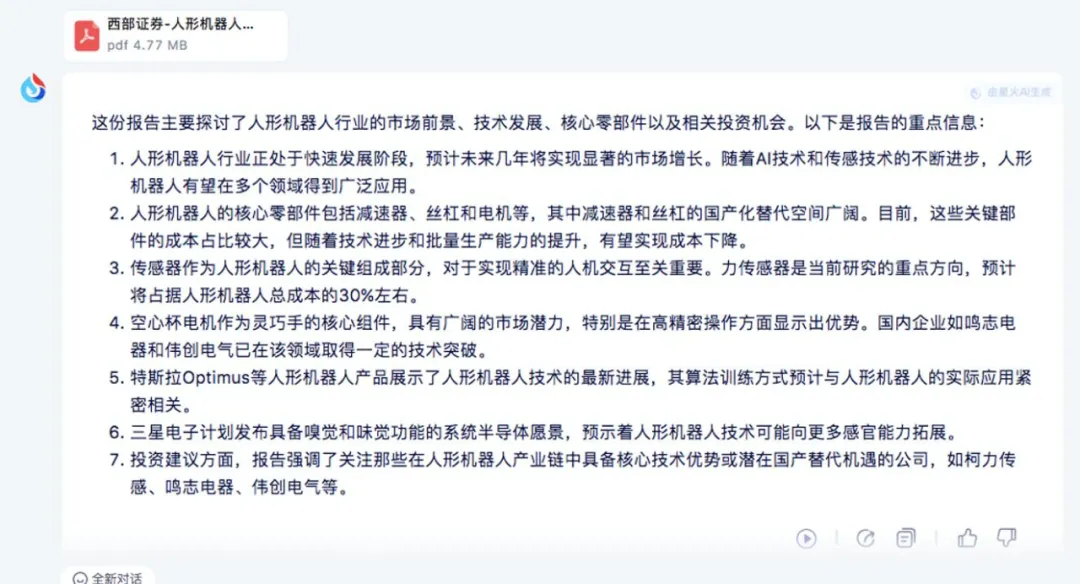
4 月 26 日,科大讯飞发布讯飞星火大模型 V3.5 的功能上新,其中一个重点就是面向用户各种场景中高效获取信息需求,发布首个长文本、长图文、长语音的大模型,能够支持文档、图文资料、会议录音等各种信息来源的快速理解和学习,还能够结合各种行业场景知识给出专业、准确回答。
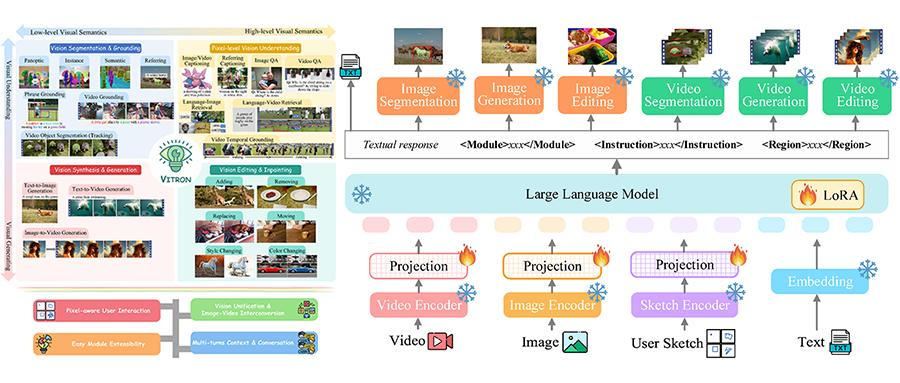
奔向通用人工智能,大模型又迈出一大步。
开源最近成了 AI 圈绕不开的高频热门词汇。