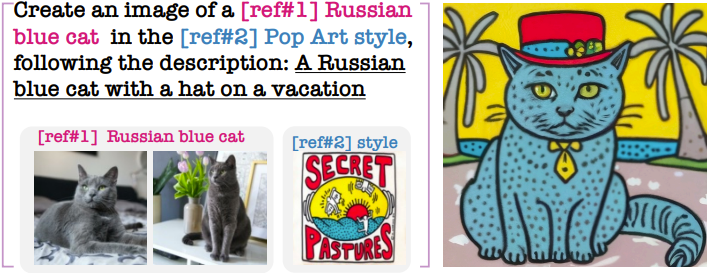
看见这张图没有,你就照着画:谷歌图像生成AI掌握多模态指令
看见这张图没有,你就照着画:谷歌图像生成AI掌握多模态指令谷歌新设计的一种图像生成模型已经能做到这一点了!通过引入指令微调技术,多模态大模型可以根据文本指令描述的目标和多张参考图像准确生成新图像,效果堪比 PS 大神抓着你的手助你 P 图。
来自主题: AI技术研报
4473 点击 2024-01-06 16:42

 搜索
谷歌新设计的一种图像生成模型已经能做到这一点了!通过引入指令微调技术,多模态大模型可以根据文本指令描述的目标和多张参考图像准确生成新图像,效果堪比 PS 大神抓着你的手助你 P 图。

琳琅满目的乐高积木,通过一块又一块的叠加,可以创造出各种栩栩如生的人物、景观等,不同的乐高作品相互组合,又能为爱好者带来新的创意。
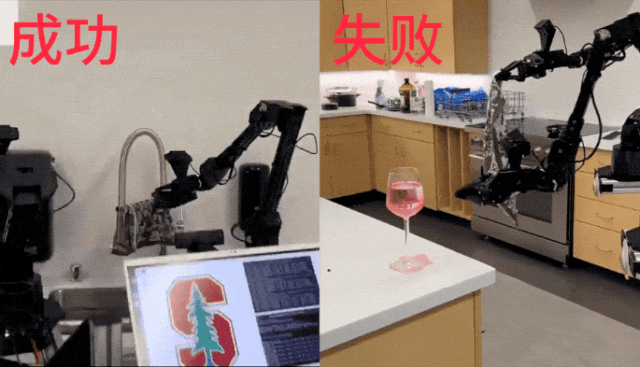
爆火的斯坦福全能家务机器人Mobile ALOHA,大!翻!!车!!!你以为它擦个红酒轻而易举,但实际上却是这样的:
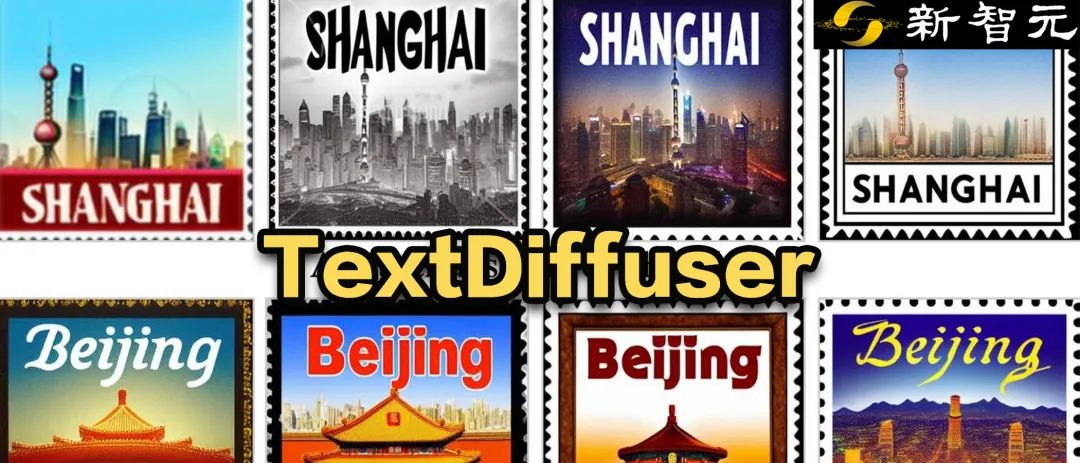
解决扩散模型「不识字」的问题,Textdiffuser采用两阶段(布局+图像)生成框架,显著提升了相关性能的指标!
在 AI 领域,近年来各个子领域都逐渐向 transformer 架构靠拢,只有文生图和文生视频一直以 diffusion + u-net 结构作为主流方向。diffusion 有更公开可用的开源模型,消耗的计算资源也更少。
进入现今的大模型 (LLM) 时代,又有研究者发现了左右互搏的精妙用法!近日,加利福尼亚大学洛杉矶分校的顾全全团队提出了一种新方法 SPIN(Self-Play Fine-Tuning),可不使用额外微调数据,仅靠自我博弈就能大幅提升 LLM 的能力。
这篇论文介绍了一项新的任务 —— 指向性遥感图像分割(RRSIS),以及一种新的方法 —— 旋转多尺度交互网络(RMSIN)。
iPhone迎来AI时刻?岁末年初,苹果加快了在大模型领域的步伐。
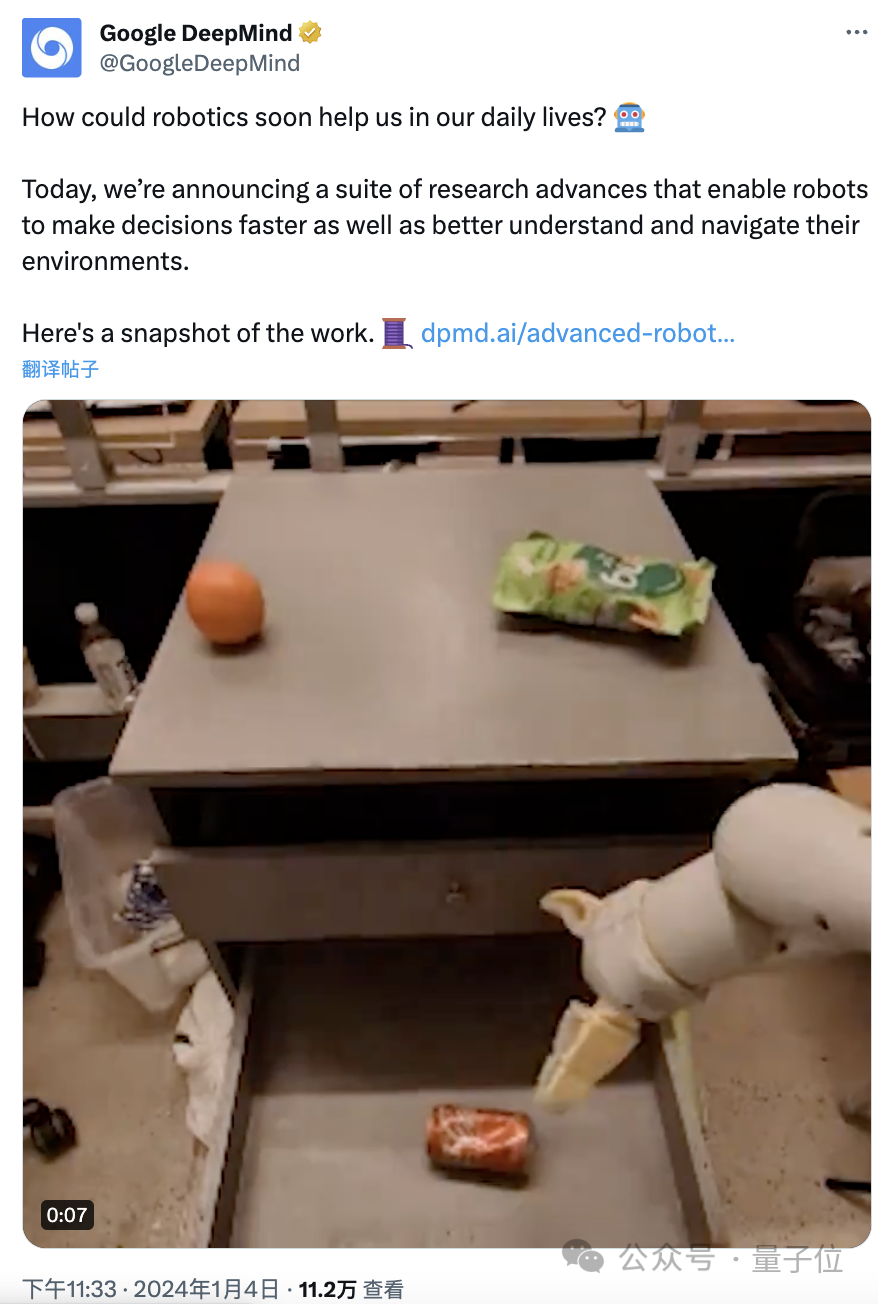
几乎是和斯坦福“炒虾洗碗”机器人同一时间,谷歌DeepMind也发布了最新具身智能成果。
大模型元年里,哪怕是跑在趋势最前沿的基座模型厂商,都难逃算力焦虑。