独家|混元多模态理解负责人胡瀚离职创业,原团队或将聚焦世界模型
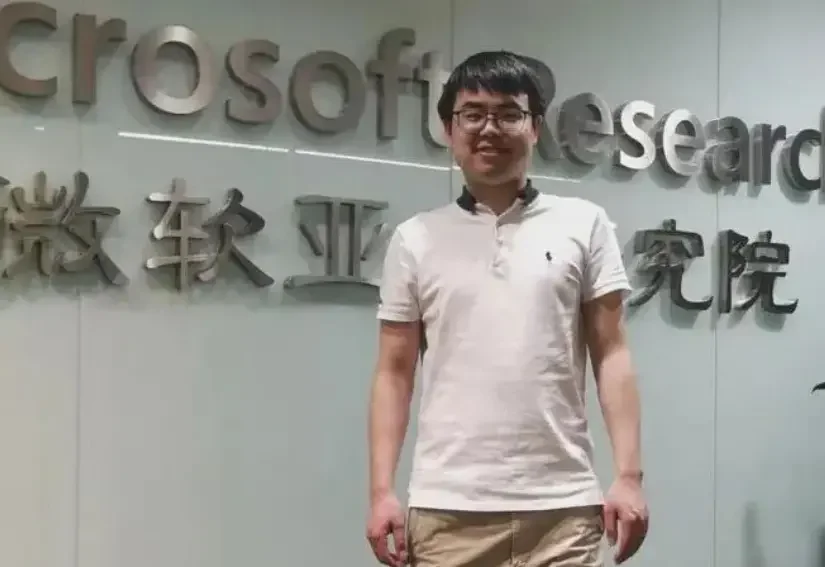
独家|混元多模态理解负责人胡瀚离职创业,原团队或将聚焦世界模型独家获悉,近期,腾讯混元多模态理解负责人胡瀚提出了离职。此前,他曾担任微软亚洲研究院视觉计算组首席研究员。2025年初加入腾讯后,负责视觉大模型的研究。在后续的调整中,他加入大语言模型部旗下的“Frontier”前沿技术研究组,负责多模态理解的相关研究,汇报给姚顺雨。
来自主题: AI资讯
10342 点击 2026-07-23 16:56

 搜索
独家获悉,近期,腾讯混元多模态理解负责人胡瀚提出了离职。此前,他曾担任微软亚洲研究院视觉计算组首席研究员。2025年初加入腾讯后,负责视觉大模型的研究。在后续的调整中,他加入大语言模型部旗下的“Frontier”前沿技术研究组,负责多模态理解的相关研究,汇报给姚顺雨。
今天,腾讯正式发布了其首个研究智能体(Research Agent)——Hyra(Hunyuan Research Agent)。Hyra能够像科研人员一样,提出假设、完成实验、总结经验,再基于经验不断提出新的方案,最终实现递归自我改进(Recursive Self-Improvement,RSI)。
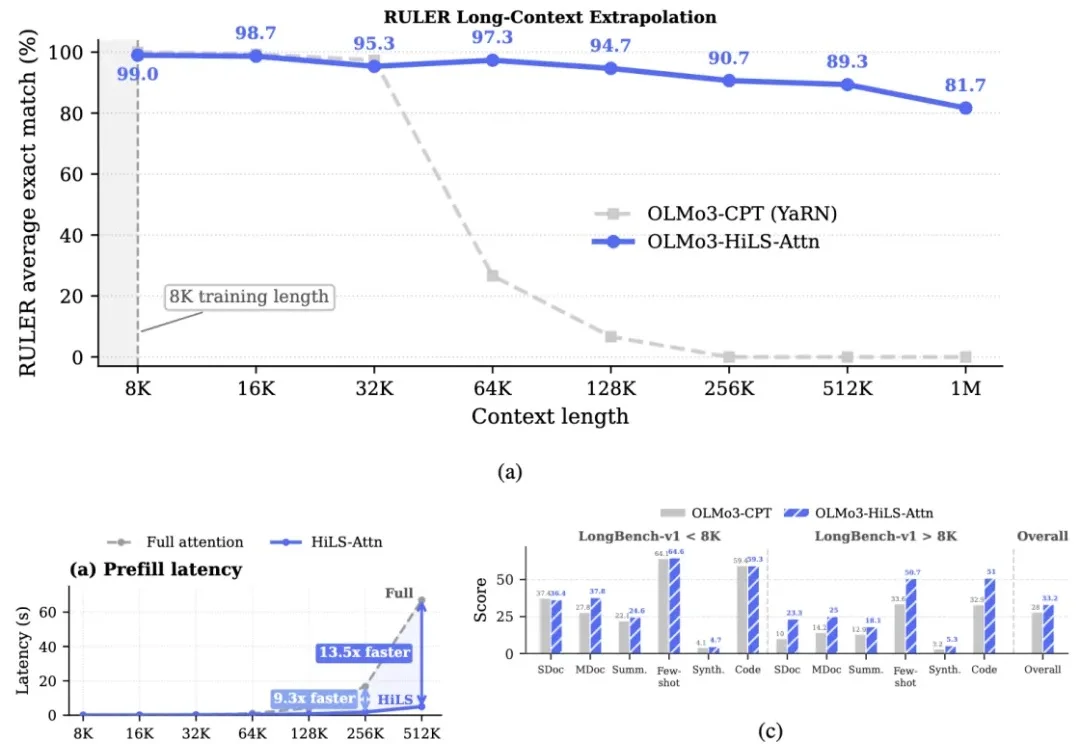
让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
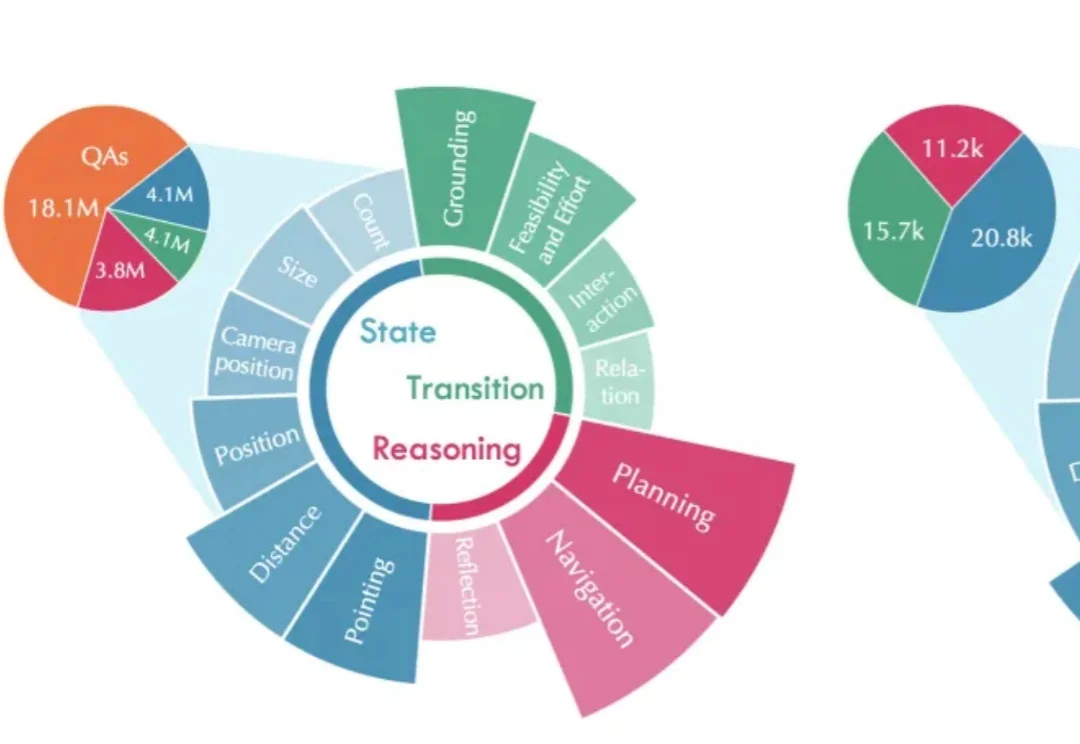
7 月 15 日,腾讯 Robotics X 实验室以及福田实验室联合腾讯混元推出两款具身智能基座模型 —— 具身 VLM 基座模型 Hy-Embodied-VLM-1.0 以及 具身世界认知基座模型 Hy-Embodied-RxBrain-1.0,不仅让具身大脑能够 “看” 懂现实世界,还学会同时推理和想象。
7月6日,腾讯混元Hy3正式版发布。
昨天,腾讯混元 Hy3 正式版上线,小程序更新了「成长计划」:小程序开发者的可以获得 10 亿的文本 Token,和 10 万张生图额度→ 10 亿 token 按官方 API 价折算,约 1000~4000 块
南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。
过去一年,Mobile/Phone-use Agent在各类评测榜单上进展很快。
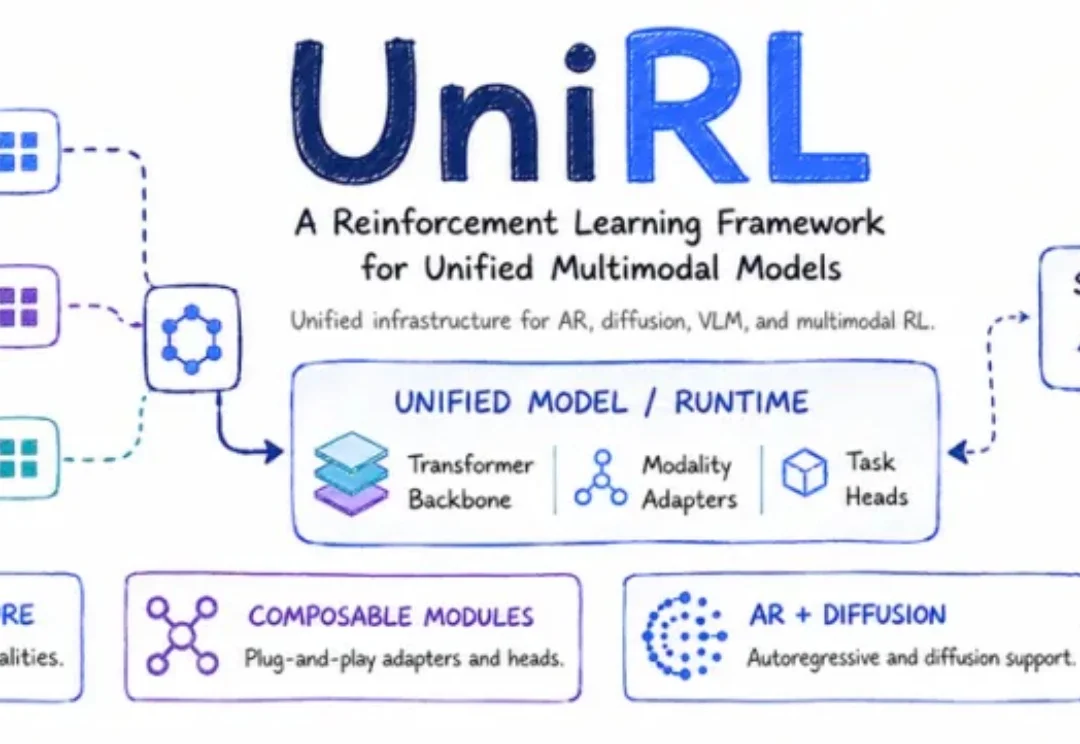
大语言模型的RL技术已日趋成熟,多模态生成模型的强化学习训练却仍在“各自为战”——图像扩散模型一套流程、视频生成另一套标准、VLM和LLM又有不同的技术栈。
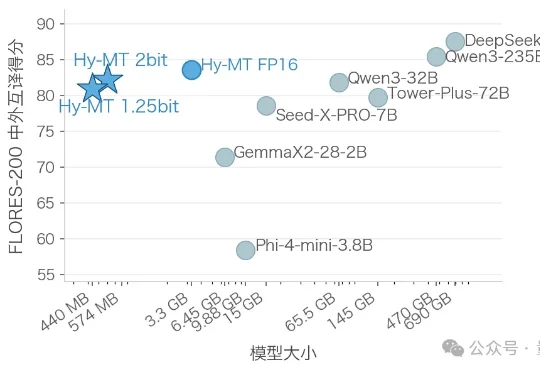
腾讯混元团队刚刚开源了一份硬核解决方案:推出极致量化压缩版本翻译模型Hy-MT1.5-1.8B-1.25bit,把支持33种语言的翻译大模型压缩至440MB。无需联网,下载后即可在手机本地运行 。官方测试显示,其翻译质量优于谷歌翻译。