
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
大语言模型智能体正越来越多地进入长期陪伴聊天这类场景 —— 不再答完一个问题就走,而是和用户处成一段长久的关系。
这种关系对记忆提出了一个具体要求:用户不会年复一年用同样的话重复同一件事,记忆系统得在措辞、话题甚至语境都变了的情况下,依然把当年那段记忆找回来。
但今天几乎所有长期记忆方案,无论底层用向量库、图数据库还是其他存储形式,在检索环节都共享同一个假设:只要查询与记忆足够 "像",记忆就能被召回。这个假设只在记忆和对话字面或语义有相似度时成立。然而现实对话里,措辞会变,场景会变,记忆却依然需要被召回。认知科学中的经典概念 ——"情景未来思维"(episodic future thinking)表明:人可以通过预演未来场景,把本应在当前对话中被想起的记忆关联起来,而这一切并不需要对方在相似的场景下说出相似的话。可教给机器的,恰恰只有 "找相似内容" 这一种检索方式;问题不出在某一环节,而出在设计根基本身。
T-Mem 给出的解法,是把这个假设反过来:与其在检索时苦苦寻找相似度,不如在记忆写入的那一刻,就把能够触发这个记忆的预设场景作为桥接提前保存,这样在记忆和对话完全没有语义相似度的情况下,依旧可以通过场景联想回忆起关键的记忆,进而让 AI 也学会 “联想回忆”。这项工作已被 EMNLP 2026 主会议接收,代码与数据已开源。
几个月前,你跟你常用的 AI 助手随口提过一句:
“小张海鲜过敏,上周都吃进医院了,以后真得注意点。”
下周就要团建聚餐了,你在群里和同事讨论得正热闹,回头问它:
“下周团建我们去哪儿呢?”
这两句话,不存在任何语义和字面的相似度。但组织者当然应该想到:团建就要选餐厅,当然要考虑大家的偏好和忌口,"小张海鲜过敏" 这条记忆,恰恰是 "团建聚餐别只吃海鲜" 这个决策的关键。
一个懂你的 AI 应该做到:当查询落到 "团建我们去哪儿呢",自动召回几个月前那条 "小张海鲜过敏",然后给你一句 "要不别去海边?小张可吃不了海鲜" 的建议。
可相似度检索接不上:它只认字面上的像,这个例子的记忆和当前对话之间天然看不见这条藏在深处的语义线。
这不是哪个系统没做好,而是整个技术路线的结构性盲区。论文里,我们把这种 "靠潜在语义关联想起旧事" 的能力,叫作联想性回忆(associative recall)。
T-Mem 想做的事情,一句话说清楚:让记忆在写下的那一刻,就准备好 "将来会被怎样想起"。
这背后是认知科学里一个经典概念 ——“情景未来思维”(episodic future thinking):人回忆过去,往往不是为了存档,而是为了预演未来。那句 "小张海鲜过敏" 之所以值得被记住,是因为它会在 "下周团建我们去哪儿呢" 这个未来场景里被用到。
T-Mem 把这个机制工程化了:写入记忆时,为每条记忆预写一组 "联想线索",论文里叫 triggers。有了这些线索,一条记忆既能被 "表面相似" 找到,也能被 "语义相关" 想起。
回到刚才的例子。那句 "小张海鲜过敏" 写进记忆的那一刻,T-Mem 会多问一句:这条信息,将来会在什么场景里被用到?
这些场景,T-Mem 都会在写入时提前记录。你可能会担心:每条记忆都这么铺路,开销会不会失控?T-Mem 在工程上做了收敛 —— 联想线索相互去重、适时合并,并随对话进展增量更新,让 "提前铺路" 的成本始终可控。
而在一段时间后,当 “下周团建我们去哪儿呢 "这个场景真的来了,T-Mem 点亮提前铺好的联想线索,先召回这条线索(如这里预设的团建聚餐吃什么的场景),再由它把线索对应的那条 “小张海鲜过敏” 的事实记忆一并从记忆深处捞出来,摆到 AI 面前。AI 这才说出那句" 要不别去海边?小张可吃不了海鲜”。
一句话:相似度检索等着你开口 "复述",T-Mem 提前为你的 "联想" 铺好了路。
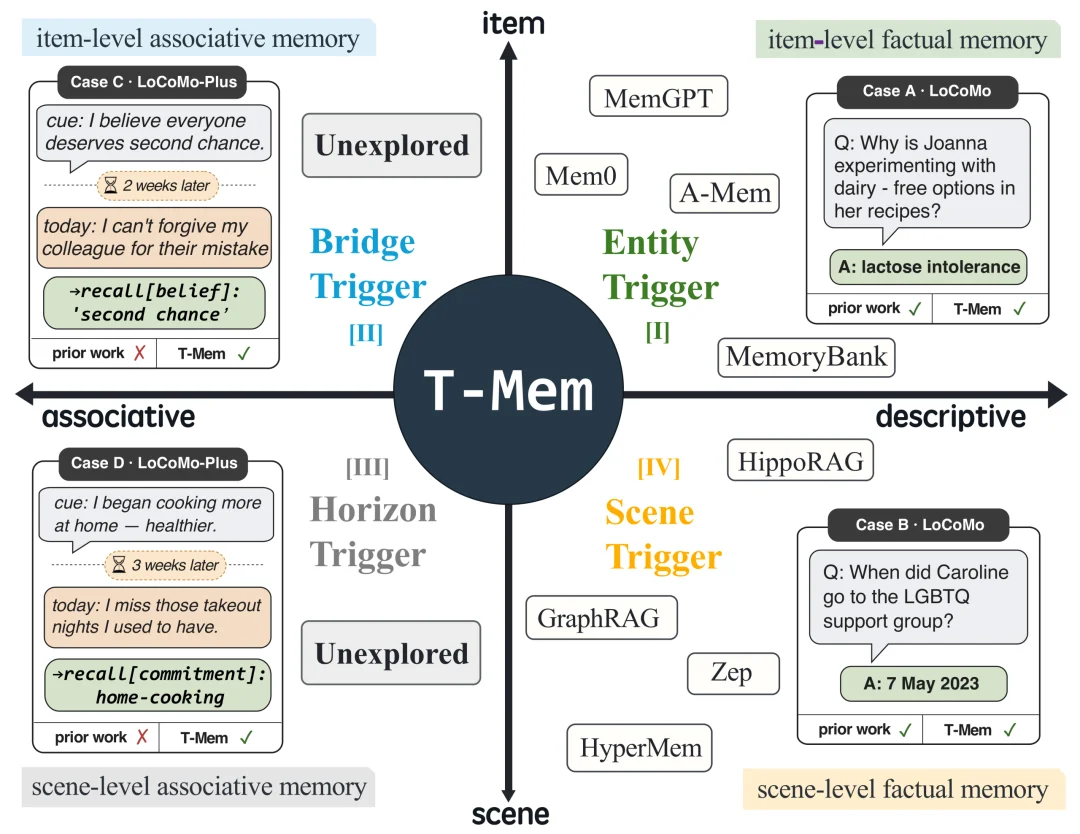
T-Mem 建模总览,展示 "记忆粒度(事实 / 场景)× 检索方向(描述 / 联想)" 的四象限空间
T-Mem 的建模思想,一张图就能讲清。记忆有两条正交的轴:
两条轴划出的 2×2 四个象限中,主流记忆系统,几乎全挤在 "描述" 这半边,"联想" 那半边长期一片空白。原因是无论记忆被存成向量还是图,主流系统检索的最后一跳都是同一件事:拿用户当下的问法,挑出记忆里 "最像" 的那一条。问得像就命中,问法一漂移就落空。存储做得再精巧,更新做得再及时,这道相似度闸门不变,能力也就被锁死在 "描述" 半边。
T-Mem 的做法,是填满这个坐标系:每个象限放一个触发族,编号 QI–QIV 与象限图一一对应。描述向的两格(QI 实体触发、QIV 场景触发)是对事实记忆能力的强化,实体触发给单条事实贴泛化标签、场景触发把整段场景写成多维档案,增强相似检索能力。真正的创新在联想向的两格:桥接触发(QII)在事实粒度预判 "这条事实将来会在什么情境里被用到",小张海鲜过敏的记忆,就连到了团建餐厅选择的触发线索;前瞻触发(QIII)在场景粒度顺着对话往前多想几步,比如,你深夜说过最怕一个人去医院,将来再在深夜聊起身体不舒服,这段对话就会被翻出来,让它多问一句要不要陪你去医院,不让你一个人。
一句话概括这套思想:相似度回答 "你像什么",触发器回答 "你会被怎样想起"。
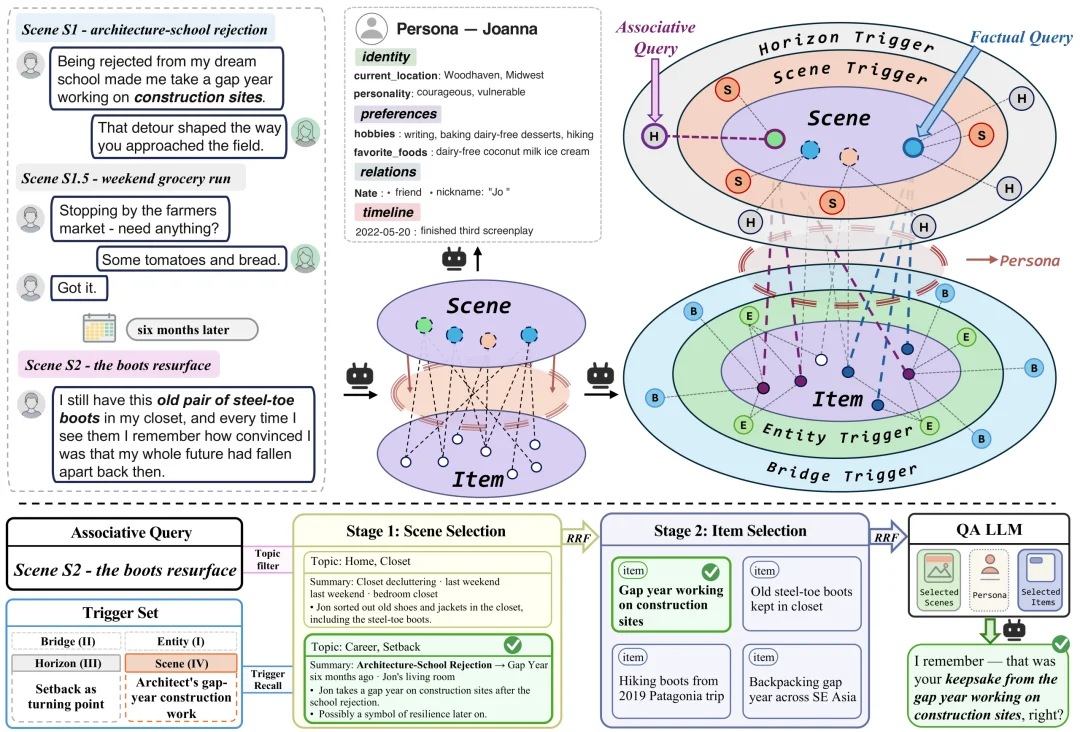
T-Mem 整体框架图,展示写入与读取两条链路
写入链路解决的是 "记住什么、怎么记"。一段段对话进来后,T-Mem 先把对话切成一个个有完整情节的独立场景,再把多个场景归入到相同主题下,接着从场景里抽出原子化的事实条目并将对应的场景 - 事实条目连接,构建一个场景 - 事实图。最后为每条事实和每个场景配上对应的 Trigger,替记忆想好 "将来会被怎样想起"。这一步不在问答的时刻占用响应时间,对话每推进一段,后台就把记忆库更新一段。
读取链路解决的是 "新问题来了,怎么把对的记忆翻出来"。收到一个问题后,T-Mem 自上而下逐层检索:先判断问题落在哪个主题,再在这个主题下挑出相关的场景,最后取出具体的事实交给模型作答。与传统方案的关键差别在于,联想线索在最开始就会参与检索:哪怕一个问题跟某条记忆毫无表面相似,只要它在语义上 "踩中" 了这条记忆的线索,记忆也会被直接带进候选,而不会被主题过滤挡在门外。
一写一读,正好对应图中上下两条通道:写入时做的那些准备,全都在读取时兑现。
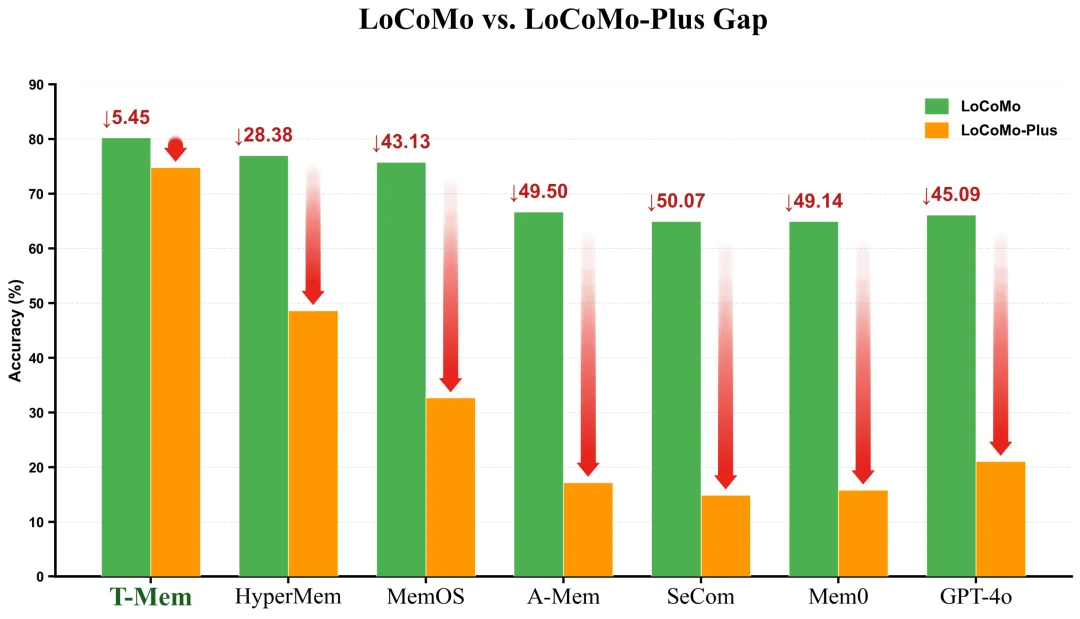
T-Mem 在 2 个记忆 benchmark 上取得双 SOTA
LoCoMo 是主流的长对话事实记忆基准,但它的题目本质上是相似召回:查询和记忆共享词面、实体就能命中,整套题里没有一道需要联想能力的题。T-Mem 在这里刷新 SOTA,说明它的基础记忆能力不输任何主流系统。
真正的考验是 LoCoMo-Plus。它在 LoCoMo 的基础上,刻意加入了一个 "认知子集":这个子集里的每道题,线索和答案之间都抹掉了词汇与语义上的相似度,只靠叙事或因果线索相连,任何靠相似度检索的系统在这里都会直接失灵。据我们所知,它也是目前唯一能单独检验 "联想记忆" 的公开基准。
T-Mem 更亮眼的数据,是跨域落差:主流系统从 LoCoMo 掉到 LoCoMo-Plus,平均要掉 28–50 个百分点,T-Mem 只掉了 5.45 个百分点。
这个数字,正是 T-Mem 想证明的结论:联想记忆并非锦上添花的加分项,而是相似度路线从结构上缺失的那半边能力。
论文的最后,我们引用了认知科学中一个由来已久的判断,它也是 T-Mem 设计的注脚:
"A long-term memory system earns its adaptive value not by archiving the dialogue stream faithfully, but by anticipating, at write time, the future cues under which its contents will need to be reached." (一个长期记忆系统的价值,不在于忠实地归档对话流,而在于写入的那一刻就预见到:未来的查询会通过怎样的线索来触及它。)
T-Mem 想做的,就是把这句话变成现实:让记忆不再是存档,而是提前为未来备好的答案。
欢迎对对话式 AI、智能体与长期记忆感兴趣的研究者与工程师关注、复现与交流。
作者团队来自腾讯 PCG,主要贡献者包括:郭伟东、王达凯、汪子轩、刘辉和徐羽,工作发表在 EMNLP 2026。该团队长期专注角色扮演领域的研究,在指令遵循、记忆等领域已经发表多篇论文,本文的工作在 QQ AI 伙伴项目中已经上线,大家有兴趣可以体验试用。
文章来自于"机器之心",作者 "郭伟东、王达凯、汪子轩、刘辉和徐羽"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
