
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
过去几年,单目深度估计快速 “Foundation Model 化”。从 Metric3D、Depth Anything 到 UniDepth,大规模数据、更强 backbone 和显式相机建模不断提高模型的跨场景泛化能力。
但与此同时,一个明显的断层也在扩大:基础深度估计能力越来越强,模型却越来越难部署。传统轻量深度估计模型虽然速度快,却往往针对单一数据集训练;Foundation Model 泛化更强,却通常需要数千万甚至数亿参数。于是我们想回答一个更直接的问题:如果模型只有约 6M 参数,还能不能保留基础深度估计的跨场景泛化能力?
这就是 DepthART(Depth Anything Rethought for Tiny Models)关注的问题。该工作已被 ACM Multimedia 2026 接收。
与其说它是在 “压缩 Depth Anything”,不如说是在研究:当模型真正进入轻量级范围后,哪些能力最容易丢失,训练方法又需要怎样改变。
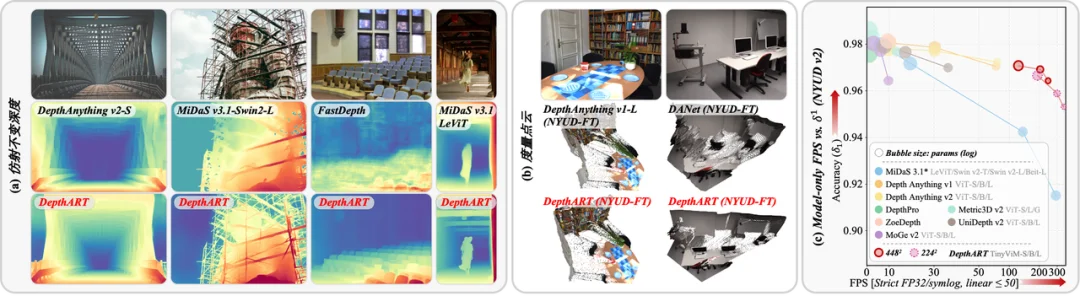
图 1. 深度可视化对比与精度 - 效率表
小模型真正难在哪里?
我们发现,模型变小后首先暴露出的并不只是网络结构问题,而是数据问题。多源训练数据中,室内、车载、建筑、物体中心图像等分布并不均衡。大模型有足够容量同时吸收这些差异,但对 6M 级模型,高频数据更容易占据有限表示能力,最终让模型 “学偏”。
因此,DepthART 提出抗偏置数据采样(Bias-Resistant Data Sampling,BRDS)。我们从约 4400 万张多源候选图像出发,根据视觉特征空间中的样本密度降低高密度重复样本的采样概率,同时保留稀疏区域,最终得到约 170 万张更均衡的训练数据。随后利用 Depth Anything V2-L 生成的伪深度监督,将相对深度先验蒸馏到 TinyViM + DPT 构成的小模型中。
其核心是在固定训练预算下,把更多训练机会重新分配给不同场景、视角和成像条件。实验表明,对于轻量级基础模型,训练数据如何组织,可能和网络结构本身一样重要。
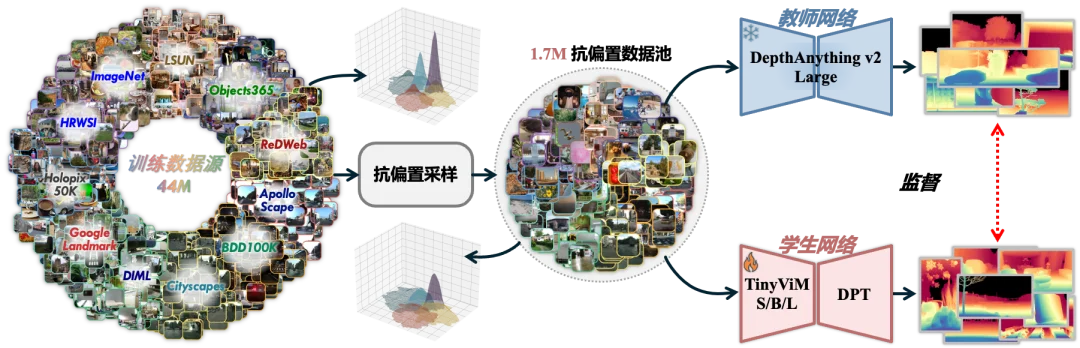
图 2. 抗偏置数据采样流程与蒸馏学习
第二个问题出现在度量深度。一个已经学会跨场景相对几何的小模型,如果直接在 NYUD 或 KITTI 上进行全量微调,虽然可以提高目标域的度量精度,却很容易覆盖原有的通用几何表示。小模型不仅更容易 “学偏”,也更容易 “忘掉”。
为此,我们设计了相机条件化微调(Camera-conditioned Fine-tuning,CamFT)。DepthART 冻结已经完成蒸馏的编码器,通过轻量相机适配模块引入相机内参,并利用多查询尺度估计头(Multi-query Scale Estimation Head)恢复真实尺度。它遵循一个简单原则:先保护已经学会的几何,再学习尺度。这样,相对深度和度量深度不再是两套割裂的目标,而是先学习可迁移几何,再低成本恢复真实尺度的连续过程。
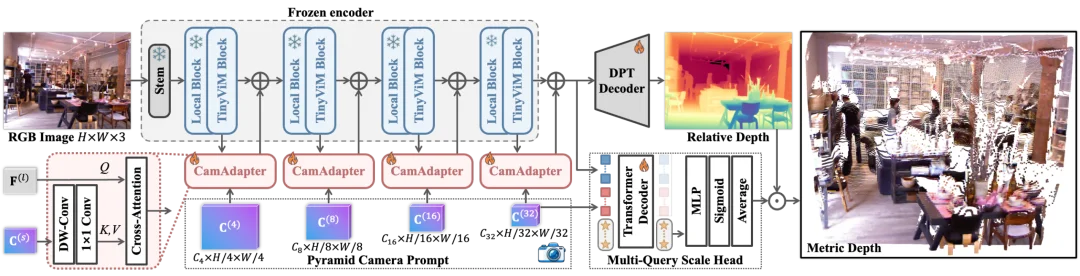
图 3. 相机条件化微调的流程
6M 参数,真正能做到什么?
DepthART 最初提供 S、B、L 三个规模,参数量分别为 6.0M、11.4M 和 32.6M。仅 6.0M 参数的 DepthART-S 在 NYUD v2 的零样本相对深度评估中达到 δ1=0.964;DepthART-L 在 ETH3D 上达到 δ1=0.958。作为参考,Depth Anything V2-S 约为 24.8M 参数,而 DepthART-S 只有其约四分之一。
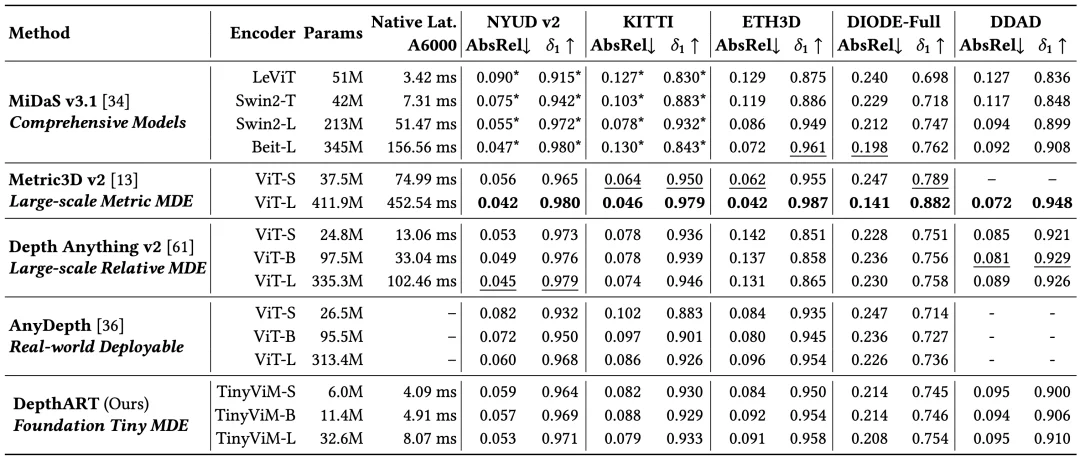
表 1. 深度估计性能对比
在论文的 strict FP32 测试中,DepthART-S 在 RTX A6000、224² 输入下约为 347 FPS;后续公开的 TensorRT FP16 版本进一步将 224 输入的 model-only latency 降至 0.918 ms。项目目前同时提供 PyTorch、ONNX、TensorRT 以及 Jetson Orin NX 部署路径。
但 DepthART 的重点并不是单纯追求 FPS,而是:当模型进入几百万参数后,能否仍然同时保留跨数据集泛化、度量适配和真实设备部署能力。大型基础模型仍然定义着性能上限,DepthART 试图推进的,是更靠近端侧区域的 accuracy-efficiency Pareto frontier。
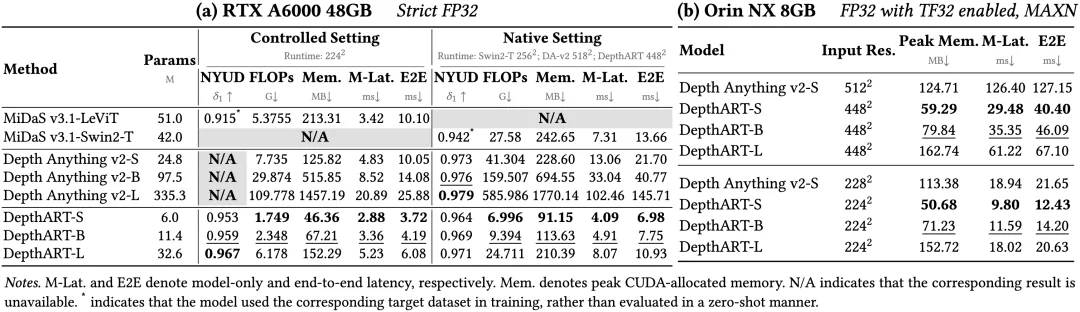
表 2. 深度估计效率对比
轻量级深度估计正在成为独立方向
2026 年 7 月,多条 lightweight /zero-shot monocular depth 路线几乎同时出现。ZipDepth 于 7 月 9 日公开,DepthART 于 7 月 19 日公开;7 月 22 日,Ultralytics 又正式发布 YOLO26-Depth。需要说明的是,YOLO26 基础模型本身更早公开,这里的时间顺序指 YOLO26-Depth 作为官方单目深度任务的发布。
DepthART 与 ZipDepth 几乎同期,并早于 YOLO26-Depth 官方深度任务发布。这种集中出现并非偶然:单目深度的竞争正在从 “把 Foundation Model 做得更大”,逐渐转向 “如何把 Foundation 能力真正带到设备上”。
论文之后,我们为什么又做了一套
MobileNetV4 DepthART?
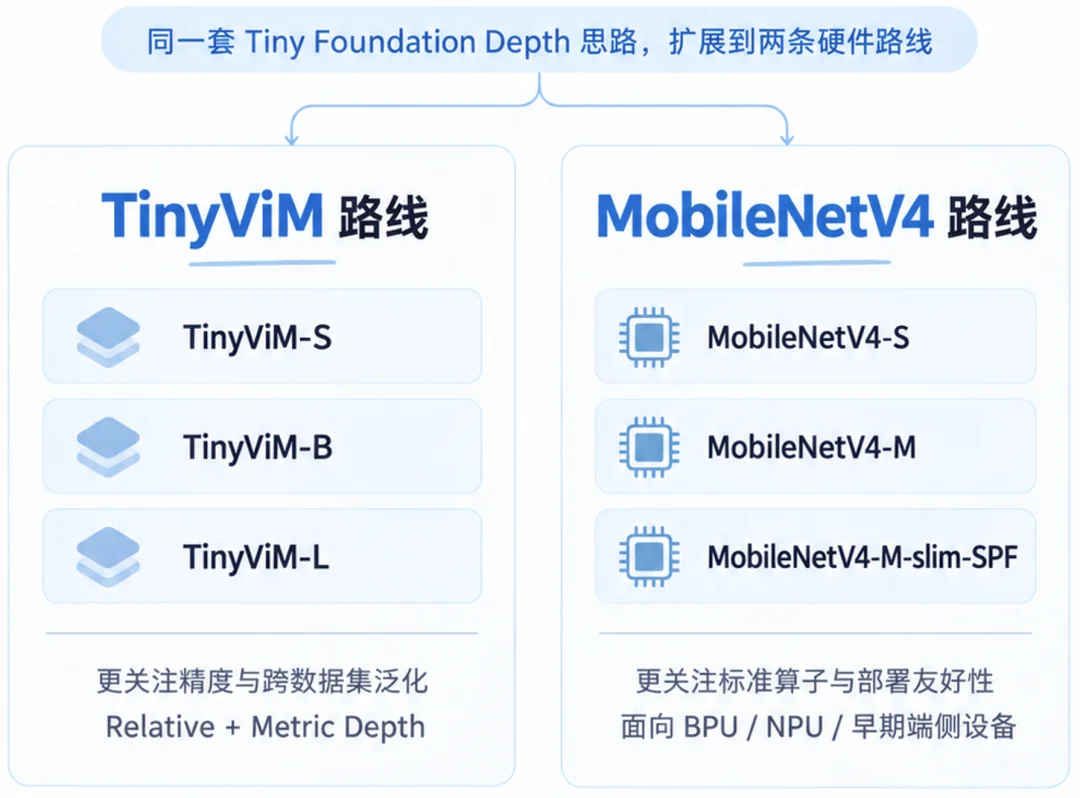
图 4. DepthART 两条并行路线
DepthART 最初采用 TinyViM,是因为它在相近参数量下具有较强表示能力,并可通过 CUDA / TensorRT 的 Selective Scan plugin 获得很高效率。但研究模型在 GPU 上快,并不意味着它适合所有硬件。一些较早的移动平台、BPU 和 NPU 更偏好成熟卷积算子和标准计算图。
因此,2026 年 9 月的新版 DepthART 新增了 MobileNetV4-S 和 MobileNetV4-M,并进一步设计 MobileNetV4-M-slim-SPF:裁剪 MobileNetV4-M 编码器,同时额外设计了计算更轻的 Single-Path Pyramid Fusion(SPF)替代 DPT 解码器。标准 MobileNetV4-M DepthART 为 8.55M 参数、8.63 GMAC;slim-SPF 版本降低到约 6.05M 参数、3.78 GMAC。
与此同时,NYUD δ1 仅从 0.953 降至 0.952,KITTI 从 0.931 降至 0.928。也就是说,计算量减少超过一半,而主要深度性能基本保留。更重要的是,MobileNetV4 版本提供仅依赖标准 ONNX 算子的导出,不再依赖 Selective Scan 自定义算子,从而降低了在早期 BPU/NPU 等资源受限平台上的移植门槛。
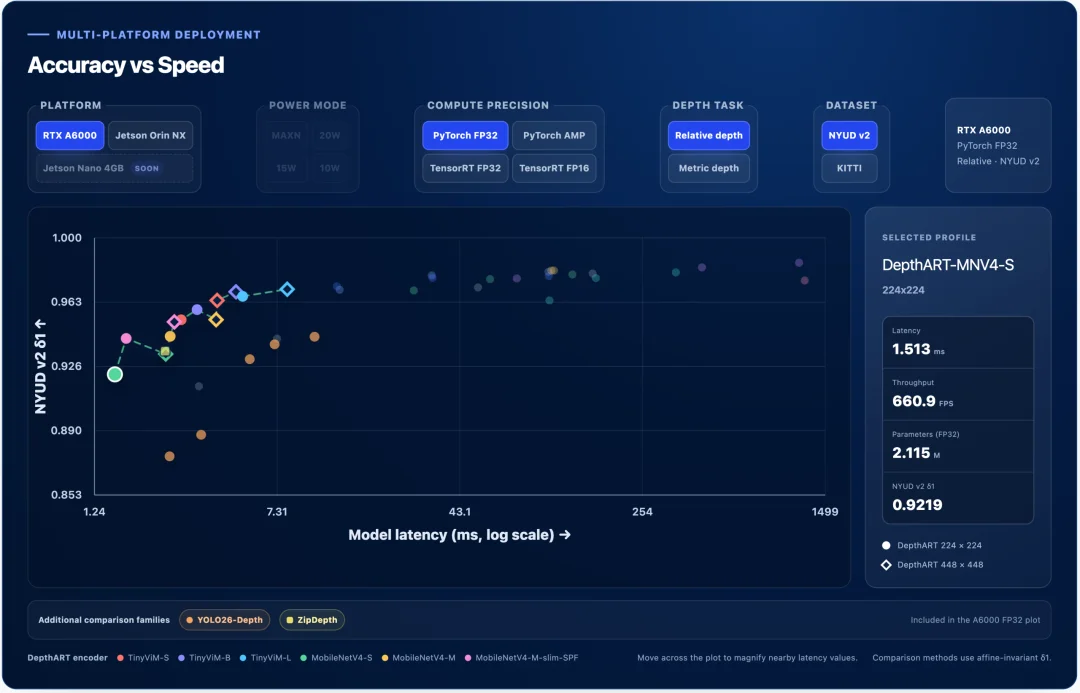
图 5. DepthART 的方案在 NYUD v2 上的模型推理延时与 Delta1 精度对比
从一个模型走向不同硬件约束下的选择
目前 DepthART 已覆盖 TinyViM-S/B/L、MobileNetV4-S/M 和 MobileNetV4-M-slim-SPF,并提供相对深度、相机感知度量深度、ONNX 与 TensorRT 等不同推理路径。最新版仓库还加入了与 Depth Anything V2-S、ZipDepth、YOLO26-Depth 等近期轻量方法的统一横向比较和真实场景可视化。
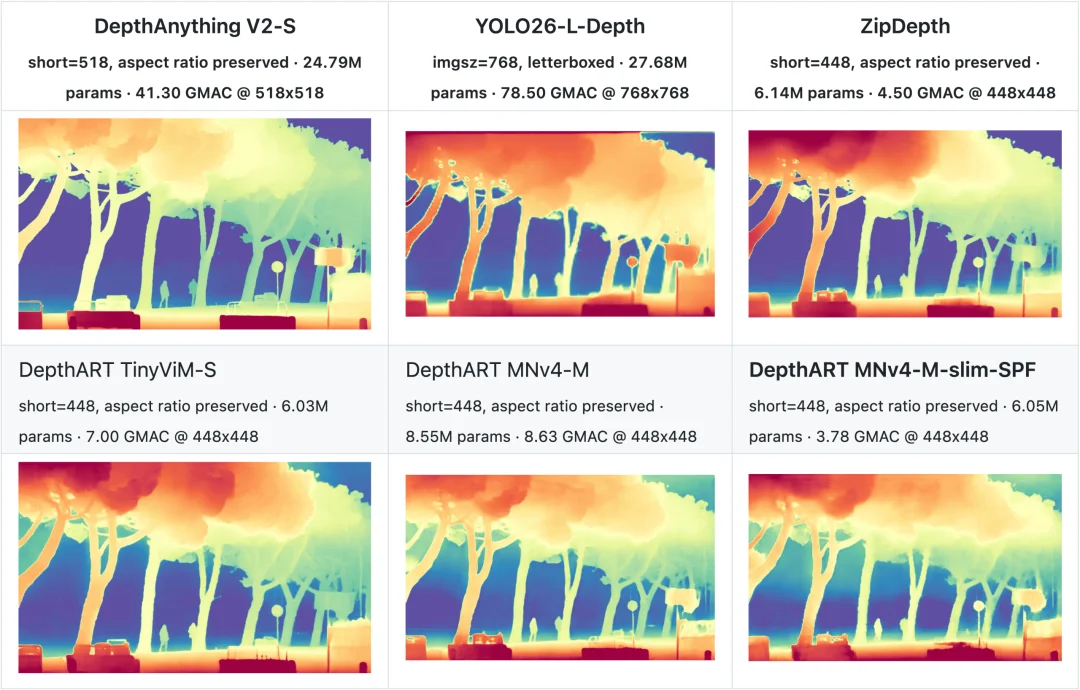
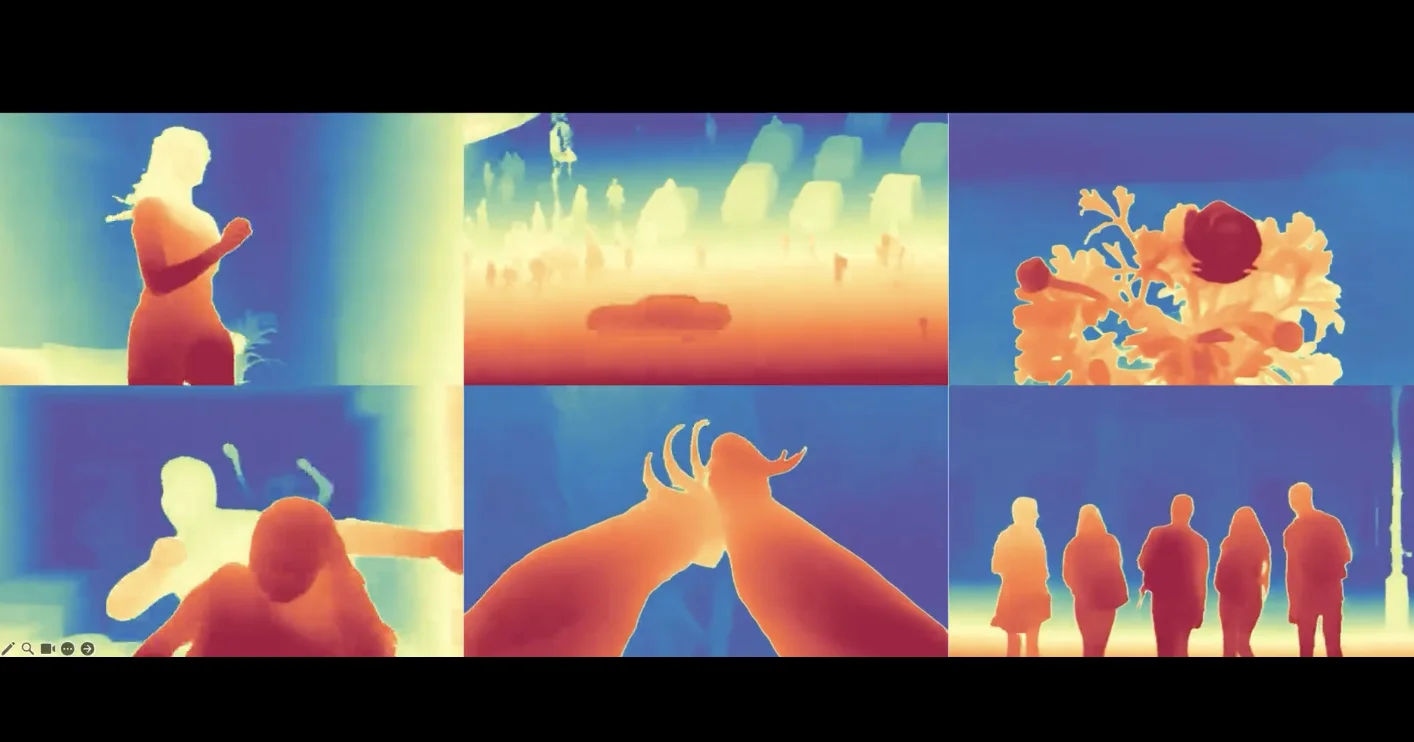
图 6:横向可视化对比
我们越来越认为,真正的轻量级深度基础模型不会只有一个 “最佳模型”。服务器 GPU、Jetson、移动 GPU、NPU 和 BPU 对算子的偏好并不相同;一个模型在 NVIDIA GPU 上吞吐极高,也不意味着它就是另一类芯片上的最佳选择。
因此,我们并不试图证明一个 6M 模型可以全面替代大型 Foundation Model。我们更关心的是:当参数、算力和部署条件都受到严格限制时,Foundation Model 已经获得的泛化能力还能保留多少?从 BRDS、CamFT,到后续的 MobileNetV4 与 SPF,DepthART 想做的是重新思考它应该怎样成为真正可部署的轻量级模型。
作者介绍
薛峰,现为意大利特伦托大学计算机科学与工程系博士后,与 Nicu Sebe 教授合作。博士毕业于北京邮电大学,博士导师为明安龙教授。主要研究方向为计算机视觉与多模态学习,关注单目深度估计、高效视觉模型、视觉语言模型及视觉基础模型的轻量化与端侧部署。
文章来自于微信公众号 “机器之心”,作者 “机器之心”


【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
