
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
当问答系统积累足够多的query–answer对后,常常把它们沉淀成一个静态知识库,让用户问题一进来就能获得低延迟响应。
但这套范式隐含了一个前提——知识是稳定的。
一旦问题涉及复杂上下文或时间敏感型场景,静态知识库将会迅速过期:昨天正确的答案,今天就可能变成幻觉。
ModelScope团队推出的Sirchmunk框架,针对上述问题提出了崭新解法:
传统RAG的流程很标准:解析文档、切分文本、计算embedding、写入向量库,查询时用问题召回top-k片段。
语料稳定时,这条路线成熟、高效,也便于缓存。问题出现在数据持续变化时。每新增、修改或删除一个文件,系统都要做一串同步:哪些文档要重新解析,哪些chunk要更新,哪些旧向量要删除,还要保证索引和原始文件属于同一版本。更严重的是,当embedding模型升级时,全部历史索引数据都需要重新构建。
时间久了,本来服务于检索的索引,变成一条需要长期维护的数据管线。
Sirchmunk换了一种方式:把当前动态原始文件直接作为起点,查询发生时再去搜索、读取、核验,把算力集中在最可能包含答案的热点区域。
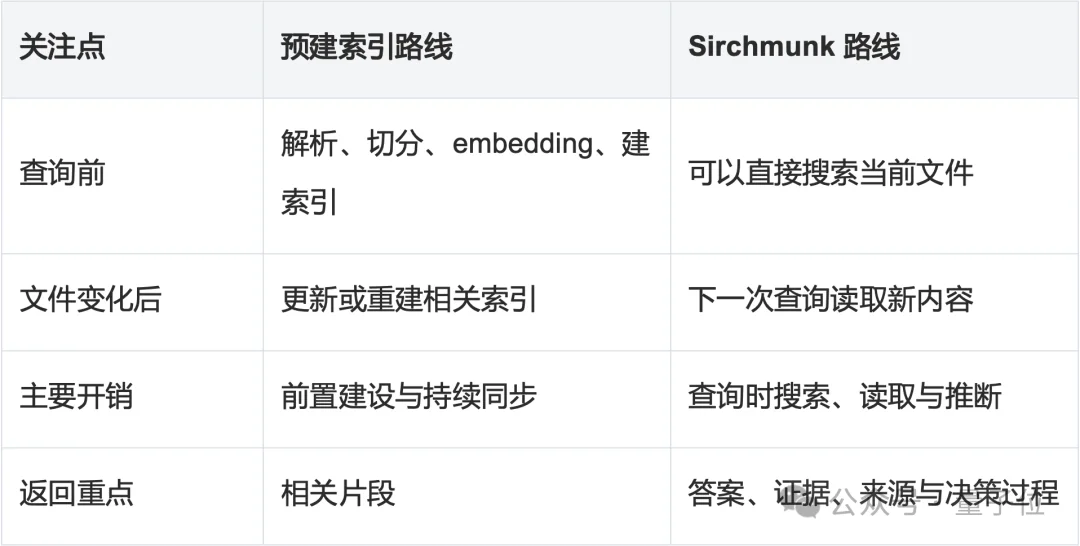
最直接的收益是缩短Time-to-First-Query:文件进入目录后,不必等待一轮全量加工就能查询。
对外,Sirchmunk提供Python SDK、CLI、MCP、HTTP API和Web UI。入口不同,最后都汇进同一套搜索编排,这套编排在尝试回答以下三个问题:
这套核心算法叫LENS,全称Latent Evidence Navigation and Search,即“隐式证据导航与检索”。名字里的“隐式证据空间”,指文档中所有可能作为证据的连续片段共同构成的搜索空间:这里没有现成的索引可查,系统只能在原始文件里边读边定位。LENS要解决的,就是怎样在尽量少的算力下,在这个空间中定位到回答问题所需的证据。
LENS检索算法不是“从固定候选里选一个top-k”,而是先用低成本信号缩小范围,再根据刚读到的内容调整下一步。搜索结束后,验证过的结果还能进入知识层,为后续问题提供先验。
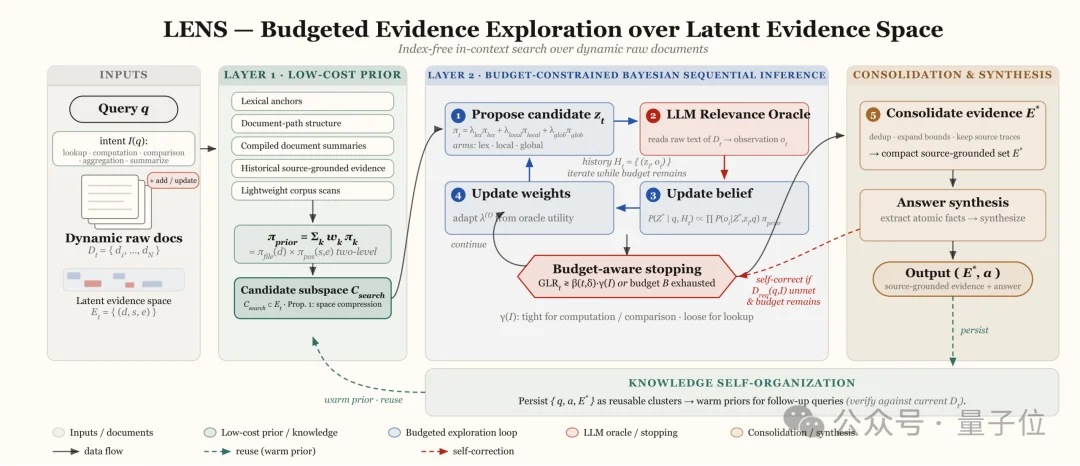
整个算法架构图可以归纳成五个动作:
最后这条反馈线最关键:历史知识能帮助定位,但不能替代对当前文件的读取。来源一旦变化,系统仍要回到原始数据重新核验。
假设有一份500页的维修手册,用户问:“故障码E217为什么会在低温启动时触发?”
答案可能分散在故障码说明、低温限制和启动流程三处。预先切好的固定chunk未必正好把这三块都覆盖到。
LENS的出发点是:文档里的任何一个连续区间,都可能成为与问题相关的证据窗口。
设时刻t的文档集合为:
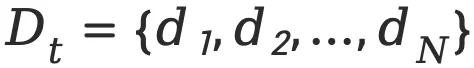
这些文档共同诱导出一个隐式证据空间(latent evidence space):
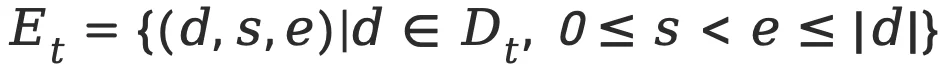
其中(d,s,e)表示文档d从位置s到e的连续片段。
“隐式”的含义是:这些窗口本来就存在于原始文件中,只是没有被提前固定成某一种切分。问题到来后,系统再决定读取哪一段、边界向外扩展到什么位置。
给定问题q,系统先识别它的意图:

再列出回答该问题必须补齐的事实需求:
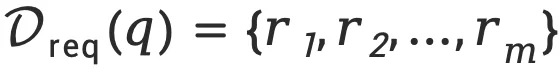
比如“A和B谁更早发布”,至少需要A的日期、B的日期,以及可比较的日期格式。只找到一篇介绍A的文档,即使主题高度相关,也还不足以回答。
对每个事实需求rⱼ,理想目标是找到尽量紧凑、又能支撑它的证据窗口:
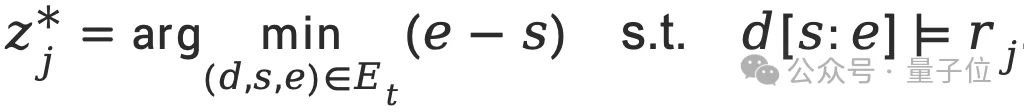
窗口越紧凑,噪声越少,也越容易回到原文核验;但也不能短到丢失上下文。目标不是“最短”,而是“最小充分”。
真实系统还受到成本约束:

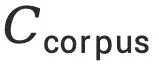
是搜索与读取文件的成本,
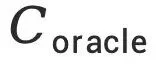
是模型判断与工具循环的成本,
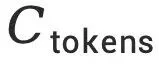
是上下文token成本,B是本次查询的总预算。
问题因此转化为:在预算内,为每个必要事实定位到足够可靠的证据。
如果让模型从第一份文件逐页读到最后一份,索引确实省了,但代价通常难以接受。因此,LENS分成两层。
系统先估计哪个文件、哪个位置值得优先读取:
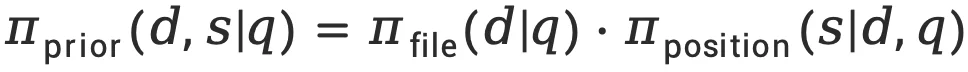
前一项判断文件是否相关,后一项判断文件中的位置是否值得先看。
这个先验由多路信号共同构成:
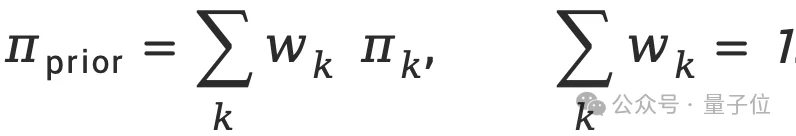
其中

可以来自关键词命中、目录结构、文档摘要、层级索引或历史证据。单独任何一路信号都可能失效:文件名可能只是part-00017,关键词可能被同义表达绕开,历史经验放到刚改过的文件上也可能不再适用。
多路先验的目的不是直接给出答案,而是把庞大的证据空间压缩成一个值得优先探索的候选子空间:
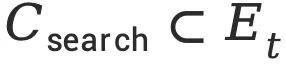
树索引、摘要索引和目录清单都能帮助进一步缩小范围,但它们只是可选的加速器:缺失或过期时,搜索仍可回到原始文件。
第t轮,系统根据问题和历史Hₜ提出一个动作zₜ:
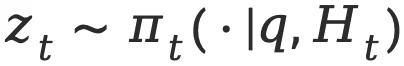
动作可以是读取某个片段、调整关键词、追查新出现的实体,或扩大范围。读取原始数据后,系统得到观察oₜ:
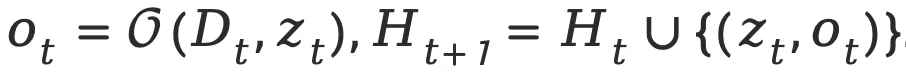
再根据新证据更新下一轮策略:
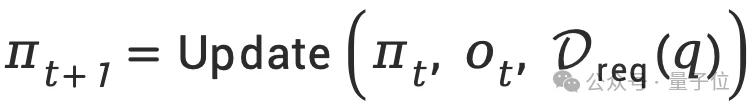
以上就是Propose→Observe→Update的检索推理闭环。这条链路的特点在于,它会在中途自己调整方向。例如,第一段材料如果带出一个新的人名、版本号或项目代号,下一轮可以直接追查;两个日期都已找齐,就不必再扫描整个目录。检索因此从一次性的top-k,变成一条会自我修正方向的导航路径。
停止条件同时看证据和预算:
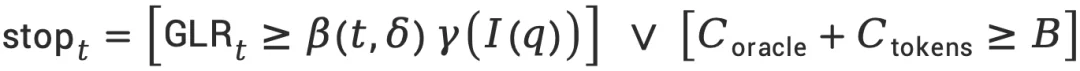
它包含两条规则:证据达到问题类型要求的充分程度时停止;预算耗尽时也必须停止,并保留不确定性,而不是强行给出一个看似完整的答案。
不同问题的门槛不同。明确的事实查找可以相对宽松;日期比较、数值计算和多跳问题更严格,因为缺少任一关键事实都可能改变结论。
真实语料很快就会打破漂亮的算法假设。
首先是命名。大量文件没有可辨语义的名字:
wiki_00part-00017shard_293.jsonl
只看文件名,几乎等同于随机挑选。所以文件评分同时考虑路径和正文命中:

命中JSON、JSONL或没有扩展名的分片后,记录标题、编号和行位置,才能把读取范围从整块大文件收紧到其中一条记录。
另一个反直觉的点是:证据不是越多越好。
检索的成败与“信噪比”息息相关。10段相关的证据材料,常常比两段直接证据更难用。进入模型之前,系统要去掉重复、模板和低覆盖的片段,优先保留命中实体、关系、日期或数值要求的内容,同时保留来源位置。
再往下是底层工具的可靠性。文件转换可能卡住,搜索进程可能超时,并发请求的token记账也不能混在一起。限流、超时、进程回收、搜索后端回退和请求级状态隔离,这些不像算法创新,却决定系统能否长期稳定运行。
一次高质量搜索留下的,不该只有一段答案。
问题怎么问、证据在哪里、哪些文件有用、结论如何被支撑——这些信息如果答完就丢弃,下一个相似问题只能重新找一遍。
Sirchmunk把满足条件的搜索结果沉淀为KnowledgeCluster:
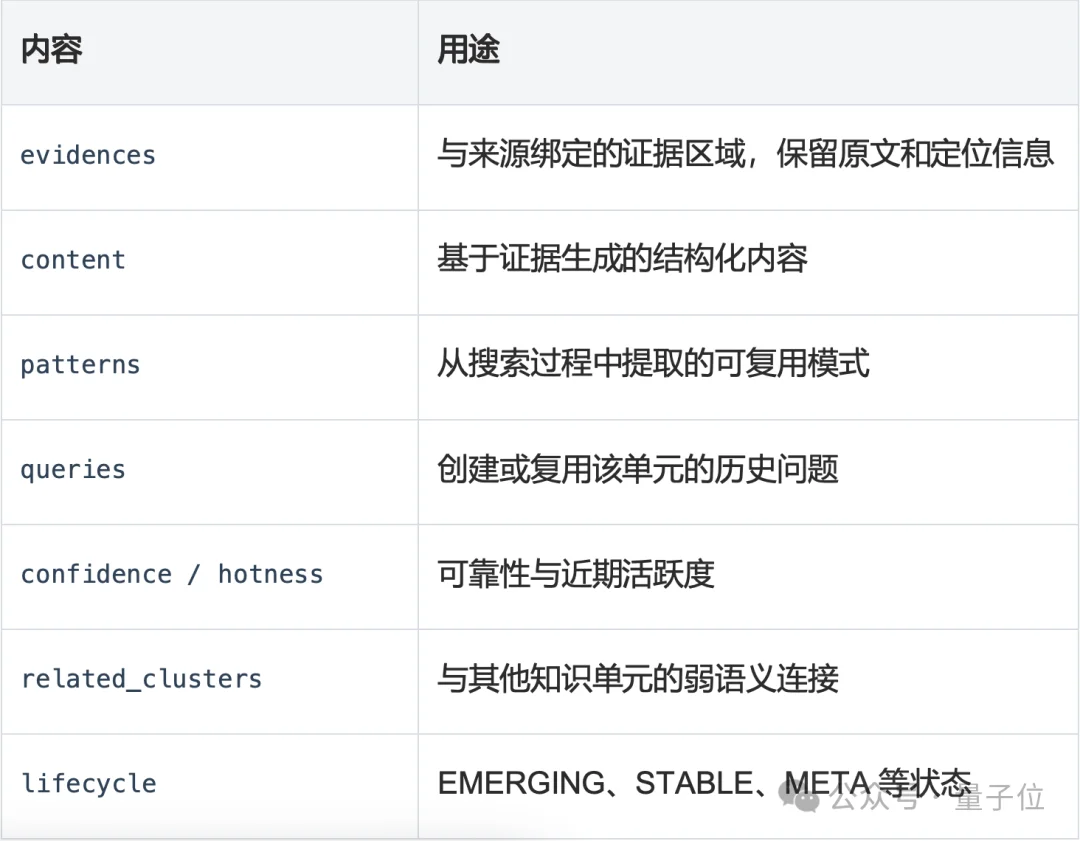
与普通的答案缓存实现有所不同,KnowledgeCluster的问题、证据、来源和可靠性被放在一起,构成一个可复查的经验单元。复用也分级:高度一致时可以复用已验证的结果;只是部分相似时,只借用文件线索和搜索模式,不照搬旧答案。
新建或被复用的知识单元都会进入KnowledgeEvolver。演化过程与当前搜索的返回解耦,不会阻塞用户拿到答案。
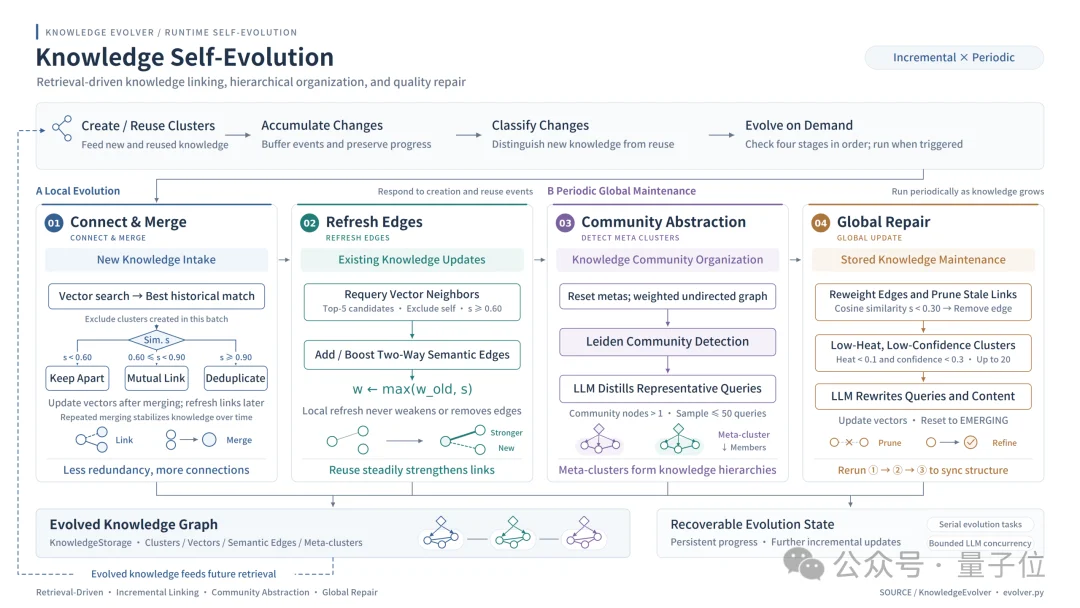
KnowledgeEvolver架构从上到下分三层:
知识演化的四个阶段:
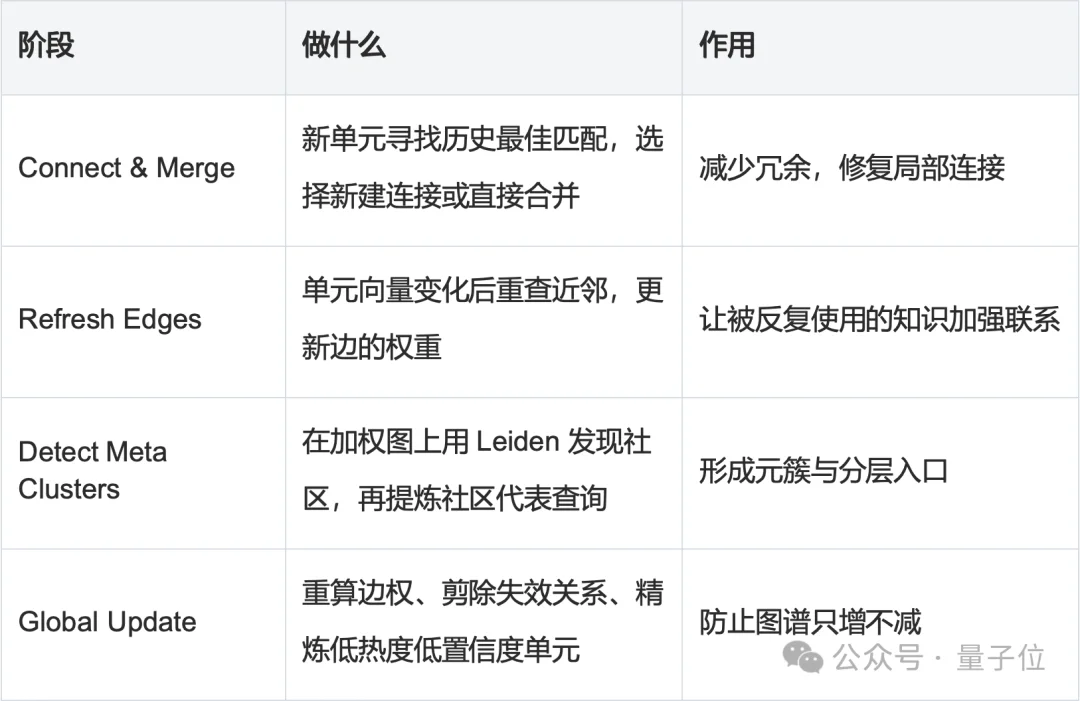
前两个阶段响应新建和复用事件,适合频繁执行;后两个阶段随知识积累周期性触发,负责更大范围的整理和纠偏。
静态图只能看到结果。为了观察结构如何随检索变化,团队做了一次时间序列回放。
演示基于SQuAD数据集,按可回答问题密度采样200条数据,涉及4篇文档,每篇50题。集中在少数文档上是有意为之:问题之间需要足够相似,连接、合并和社区形成才容易被观察到。
为了让回放更快,查询使用FAST模式和qwen3.8-flash,并调低合并、边刷新、元簇检测和全局更新的触发阈值。随后按顺序发起200次搜索,每次搜索后保存一份知识图快照,最后合成视频。
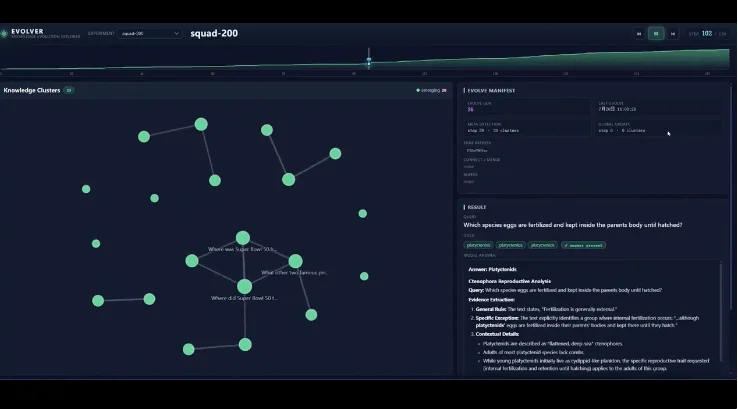
视频中展现了两种有趣的演化:
前提只有三样:Python环境、LLM配置,以及一个可搜索的目录。
pip install sirchmunksirchmunk initsirchmunk search “系统鉴权策略如何设计?” /path/to/documents
模式切换:
Python侧的最小调用如下:
from sirchmunk import AgenticSearchsearcher = AgenticSearch(paths=[“/path/to/documents”])result = await searcher.search( query=”系统鉴权策略如何设计?”, mode=”DEEP”, response_format=”rich”,)
Sirchmunk不是经典RAG系统的替代品,两者面对的场景不同:
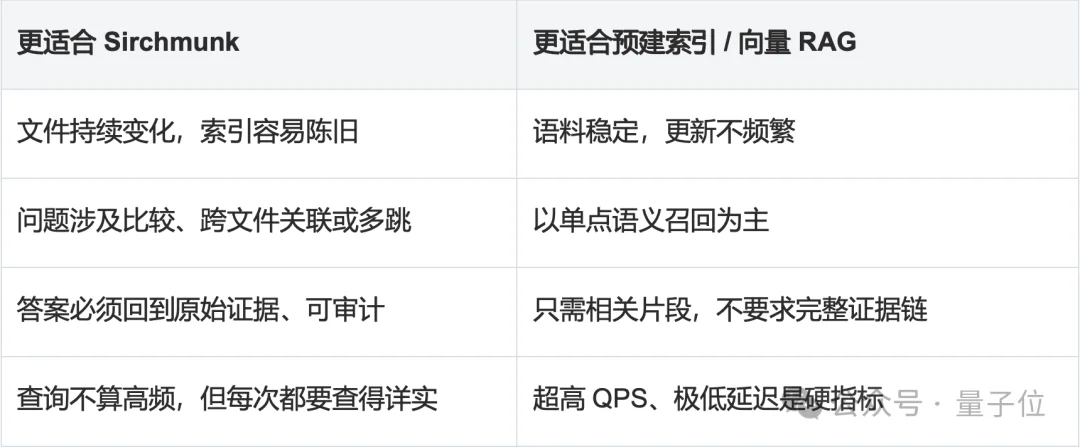
真实系统可以混合使用:长期稳定的热语料交给向量索引承担高并发召回;频繁变化、需要即时核验的动态部分交给Sirchmunk。
Sirchmunk未来的演进:
论文链接:https://arxiv.org/abs/2608.16185
代码仓库:github.com/modelscope/sirchmunk
项目文档:github.com/modelscope/sirchmunk-web
文章来自于微信公众号 “量子位”,作者 “量子位”


【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
