
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
一个有些反直觉的现实是:
AI已经在企业里被广泛用起来了,但很多公司的生产力并没有因此明显上升。
麻省理工NANDA发布的2025年企业生成式AI报告中,有一组经常被放在一起看的数字:
在受访的企业中,有95%的企业生成式AI试点没有带来可衡量的损益回报;与此同时,超过90%企业中的员工已经在用个人AI工具干活,真正购买官方企业订阅的公司却只有40%。
这组数字背后其实是同一个问题:
AI被用起来了,但它停在了个人层面。
所以今天企业面临的,已经不是“要不要接入AI”,而是另一个更难的问题:
接入之后,企业到底该自己积累什么,才能让AI真正变成生产力?
在今天上午,上海西岸的WTCC论坛上,特赞创始人范凌给出的答案是:
企业最终要补的,不是一套更强的模型,而是两个世界模型。
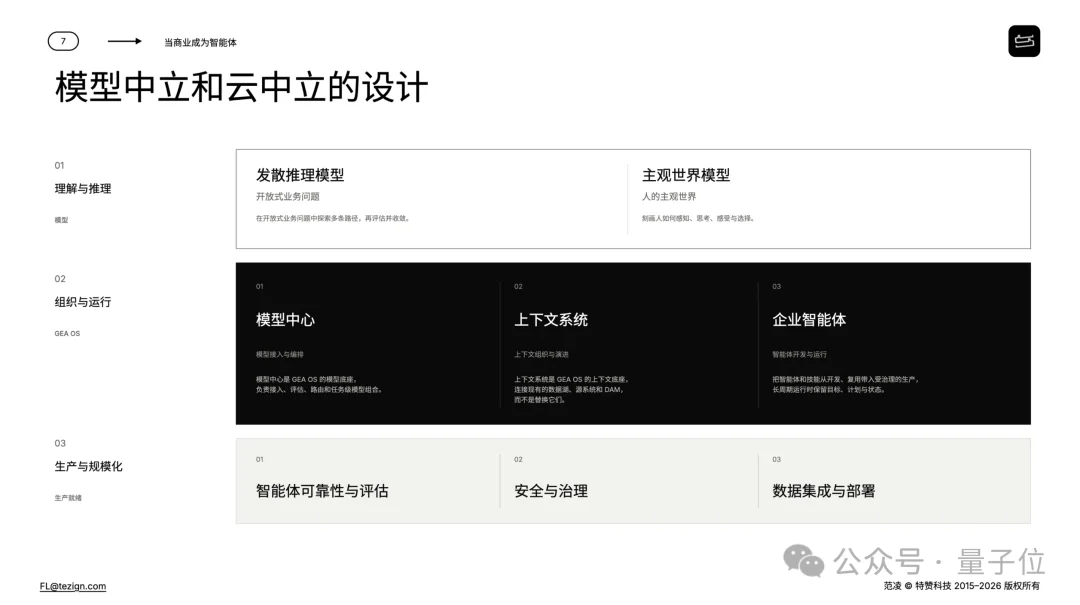
“世界模型”这个词,说简单点,就是一个系统能不能回答:如果我这么做,接下来会发生什么。
放到企业里,这个问题至少有两个方向:
一个向外,理解客户。客户为什么会偏好某个选择,什么会让他们改变主意,什么样的表达和产品更容易被接受。这一层,特赞在论坛上的说法是“客户世界模型”,也就是后来材料里更常出现的“主观世界模型”。
一个向内,理解公司。一项决策进入企业内部之后,会经过什么流程,受哪些资源、规则和协作关系影响,最后能不能真正落地。这个部分更接近“企业世界模型”。
两者看起来都在回答“怎么做决策”,但本质不是一个东西。
“理解客户”的主观世界模型,处理的是主观偏好、动机和选择,靠的是外部用户数据;
“理解公司”的企业世界模型,处理的是流程、资产、规则和默会知识,靠的是组织内部长期积累的上下文。
关于主观世界模型,前段时间量子位已经做过一次细致的讲解,这里不再展开。
也正因为这两套东西的数据来源、更新节奏、责任归属都不一样,它们很难被粗暴合并成一个大模型。
合在一起,往往不是更强,而是两边一起变钝,缺掉任何一边,问题都会立刻暴露出来:
所以这不是“多一套模型更保险”的问题,而是企业智能体架构里本来就缺了两块完全不同的东西。
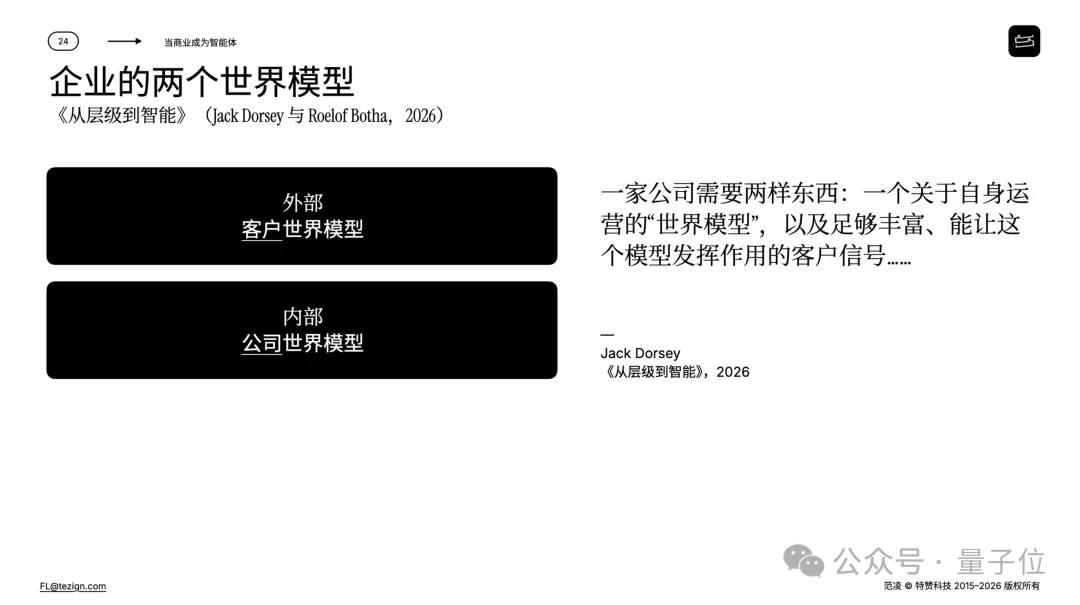
如果说客户世界模型更接近外部感知,那企业世界模型最难的地方,其实在内部知识的识别、组织和利用。
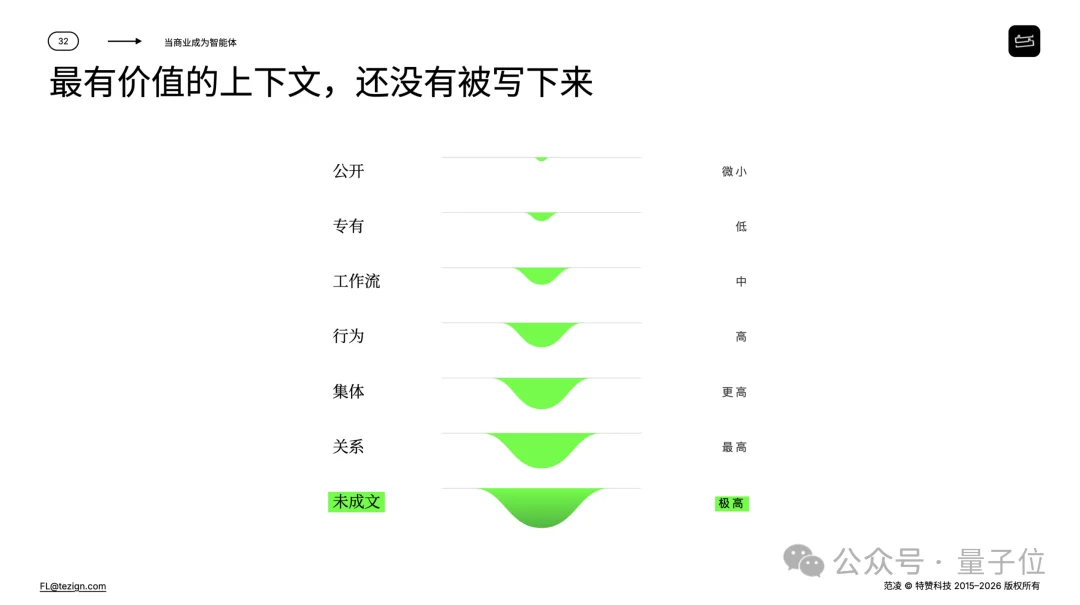
因为组织里最值钱的东西,很多恰恰不在文档里。
特赞在论坛上把企业知识拆成两类:
这也解释了为什么“把文档都喂给AI”并不等于“AI理解了企业”。
事实上,已经有不少企业,正在尝试基于模型能力构建自己的上下文系统。
但上下文建得好不好,这一层可能还没有形成统一的判断标准。
企业真正需要的上下文系统,至少得满足几个条件:
一句话总结就是:智能体调用的不是数据,而是上下文。
如果说企业世界模型解决的是内部上下文,那另一个正在发生的变化,是专家判断开始进入训练数据。
这里说的不是第三个世界模型,也不等同于客户世界模型。
它更像是两套世界模型之下,共用的一层能力底座。
据论坛和相关技术资料披露,特赞已经引入了大量不同领域的专家,参与真实判断过程的采集和标注,让训练信号不再只依赖通用数据,而是开始包含业务语境里的判断路径(Creative Trajectory)。与此同时,一些合作机构也在沿着类似方向推进研究,相关判断路径的积累已达万条量级。
这件事为什么重要?
因为企业里最值钱的知识,如判断标准、取舍逻辑、风险敏感度,互联网上没有,通用模型里也没有。
它们本来只存在于人、项目和档案之间。
现在做的,其实是把这些原本难以留存的判断过程,变成一种可以积累的资产。
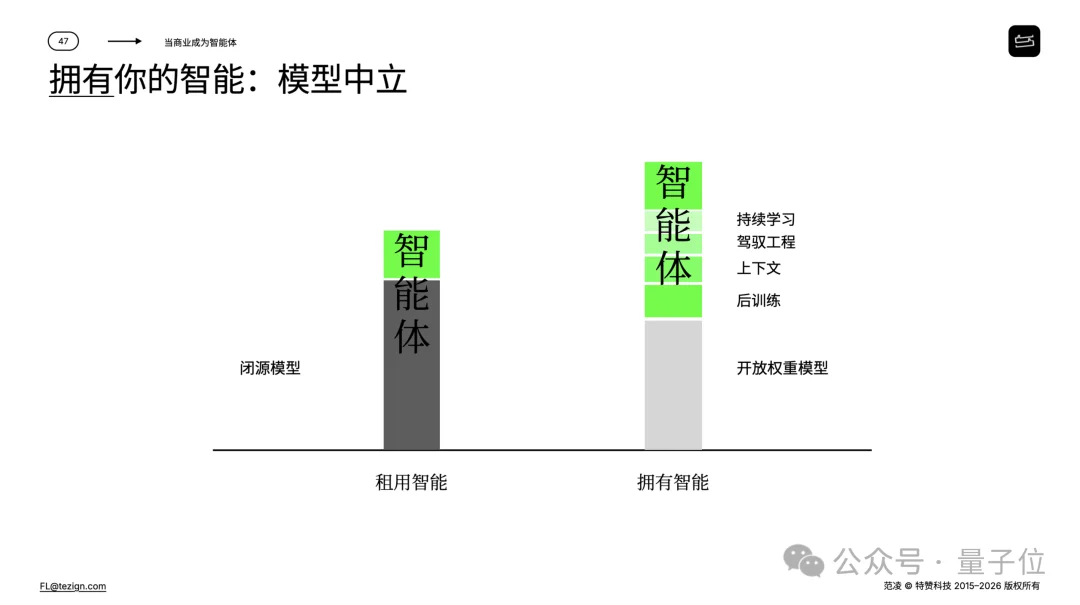
也因此,这条路最终通向的,不只是“模型更懂业务”,而是一个清晰的企业AI进化方向:
从“租用智能”,走向“主权智能”。
最后还剩一个绕不过去的问题:怎么评?
通用benchmark衡量的是模型能不能答对标准答案。
但企业场景里,更重要的问题往往不是“对不对”,而是:它是不是按这家公司的方式做对的。
一家公司的品牌边界、一家团队的选品逻辑、一个管理者对风险的容忍区间,这些都不在公开评测集里,也不在通用模型的默认价值观里。
所以业务垂直benchmark真正有价值的地方,不在于给模型打一个分,而在于它把组织的判断标准变成了一个能持续回归、持续比较、持续修正的测试集。
一旦这个东西存在,模型升级、流程调整、团队变化到底带来了什么能力变化,就不必再靠“感觉变好了”来判断。
这一点,特赞的团队提到一个很典型的校准方法:
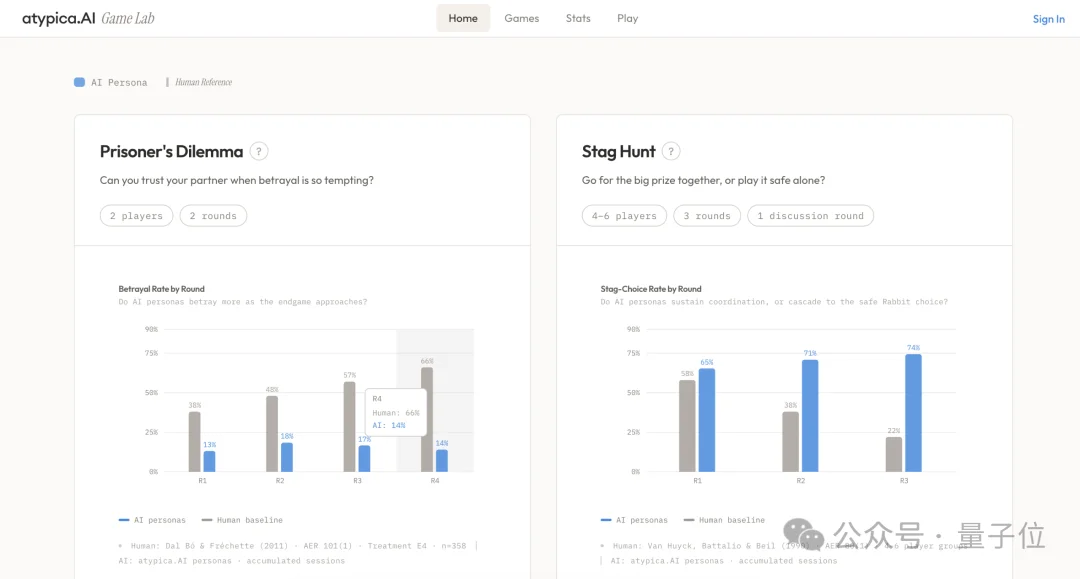
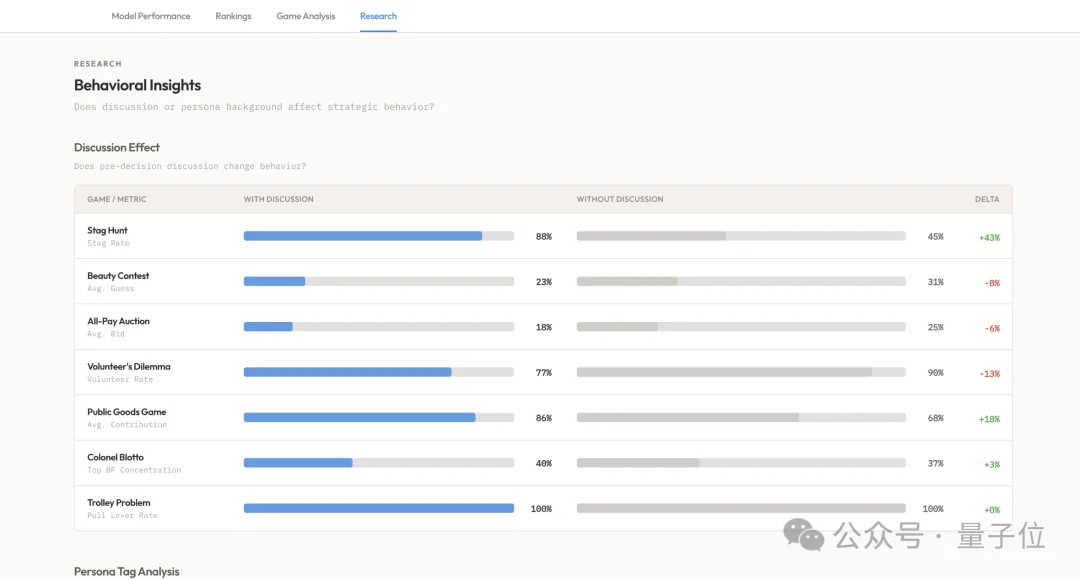
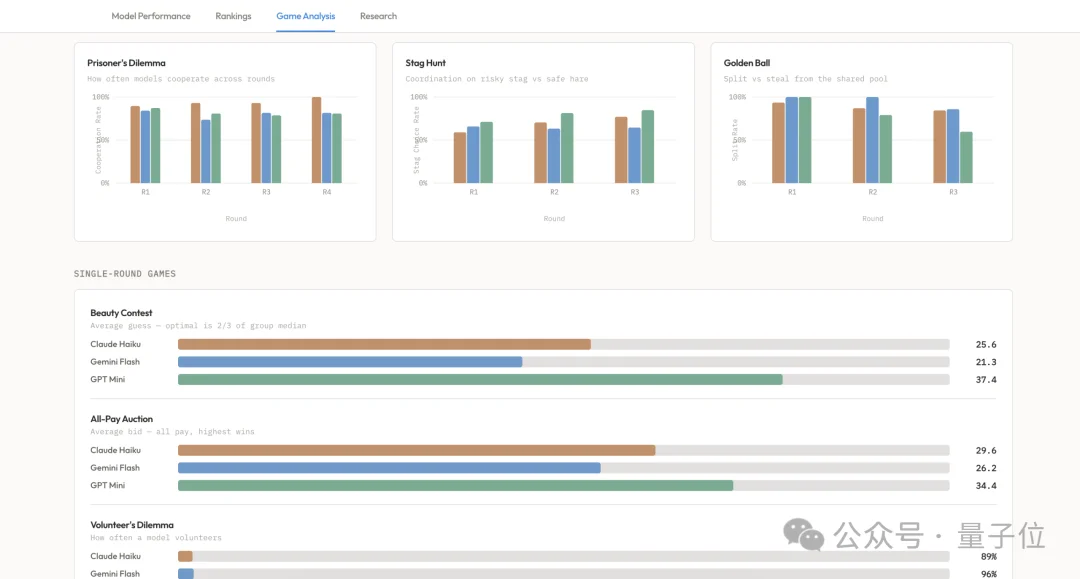
在Atypica的场景中,通过让真人和AI persona去完成同样的经济学行为实验,再用两者之间的差异来量化校准模拟效果,从而反哺到模型训练和优化中。
量子位今年7月在WAIC现场报道时提到过一个结果:主观世界模型在行为模拟上的准确率达到85%。
当然,这种模拟和benchmark本质上还是校准工具,它们能让研究和验证更早发生,但不能替代真人研究本身。
企业里智能体要真正跑起来,需要搭建什么样的机制?
有了基础之后,又该如何让机制真正转起来?
论坛上给出的说法是,企业智能体真正要跑起来,得转动一个完整闭环:Signal、Plan、Create、Evals。
这背后其实对应的是企业智能体和上一代Copilot的差别。
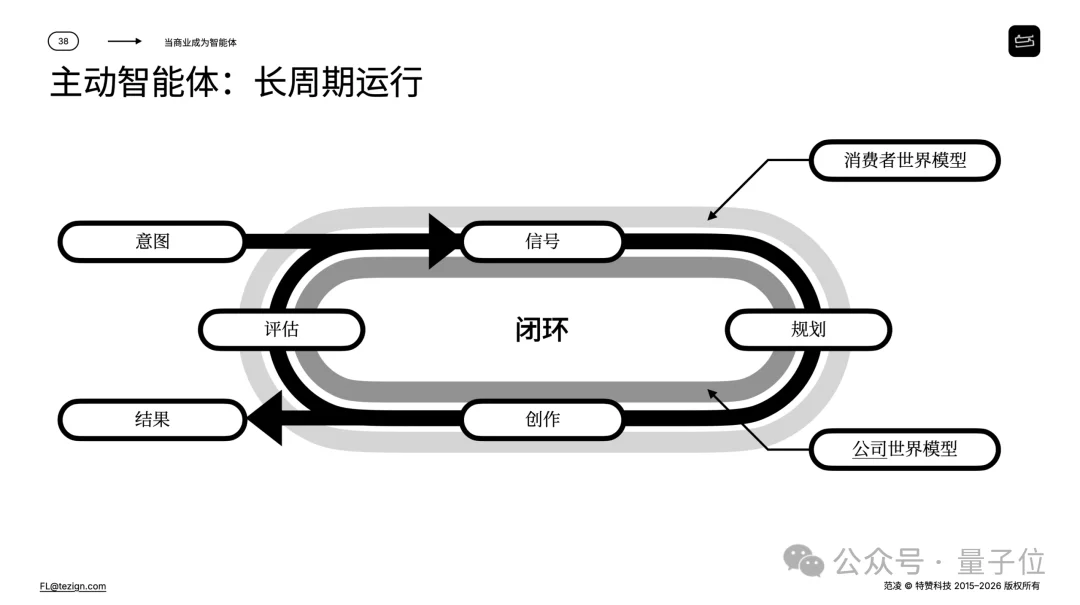
Copilot更像一次性被调用的工具:你问,它答;你开任务,它给你一个结果。
但企业真正需要的智能体不是这样。它是长程的,可以持续运行,得进入工作流,得跨时间保留目标、状态和反馈,而不是每次都从零开始。
范凌在演讲里说:
智能体把工作推到80分,人再把它从80分带到120分。
这句话重要的地方,不是“80分”和“120分”这两个数字,而是它重新定义了人和智能体的分工。
两者不是替代关系,而是错位分工:AI负责把大量可Token化的工作往前推,专家真正有价值的地方,仍然在最后那段高密度判断里。
把这些线索放在一起看,企业级AI进入了一个新的阶段,“两个世界模型”给出的,其实就是这套能力在企业架构里的表达:
一套理解外部,一套理解内部,中间跑一个能持续推进的长程智能体。
值得一提的是,特赞在WTCC论坛上同步发布了Agentic Transformation共建计划,把高校、研究机构、企业、模型与技术伙伴、专业实践者都拉进来,原因也很简单:这条路还没有被完全验证,很多问题没有现成答案,只能在开放协作中边做边成长。
比起“怎么把AI用起来”,特赞试图用一种共建的方式,来解答另一个更难的问题:
企业要想把自己的判断,变成一种可积累的资产。那么第一步,该怎么做?
参考链接:https://game.atypica.ai/
文章来自于"量子位",作者 "允中"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
