
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
「朋友马上来家里做客,帮我准备一下。」
面对这样的请求,机器人应该先做什么?收拾桌面、准备饮料,还是整理沙发?客人有什么偏好?如果东西没抓住、物体被挪走,机器人又能否发现问题,调整计划,继续完成准备工作?
这些对人类而言自然的判断,构成了家庭机器人走向实际应用时必须面对的挑战。近年来,视觉语言动作模型(VLA)和世界动作模型(WAM)不断提升机器人的操作能力,以 GPT-6 Astra 为代表的大模型则为任务规划与执行纠错提供了新的可能。但从完成一条明确指令,到根据用户需求自主推进一系列任务,仍然存在明显距离。
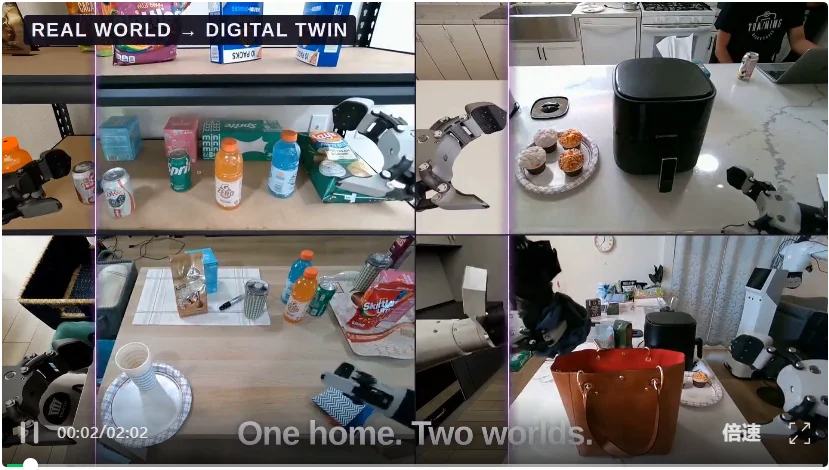
围绕这一问题,来自 Aether AI 和UC San Diego 的研究团队提出 RobotAgentBench(RAB):一个面向开放世界机器人自主能力的综合评测基准。它以真实家庭为起点,构建 50 种家庭布局、90 项原子任务、18 项短程任务、8 项长程任务和 4 类开放式场景,系统比较独立 VLA/WAM 策略与多种机器人智能体架构。
实验结果显示:独立的 VLA 和 WAM 策略模型在自主发现任务、理解情境等方面仍面临明显困难,而引入整合规划、执行与验证的智能体框架(agent harness),能够显著提升机器人的综合表现。其中,结合代码控制与学习策略的混合执行方案,在所评测配置中取得了最高的任务级平均分和开放场景综合得分。此外,递归自我改进(RSI)使智能体能够根据执行反馈持续优化控制工具、积累经验,在多轮迭代中进一步提升任务表现。
假设用户说:「Emma 今天要出门办公,外面正在下雨,帮她准备一下。」
这里没有逐项列出的操作清单。机器人需要观察环境,结合出门、办公与天气信息,判断哪些任务与当前需求相关,再把判断转化为实际行动。在执行过程中,它还要不断检查结果,根据变化重新作出决策。
RobotAgentBench 将这些要求拆解为五个互补维度:
在任务级评测中,这些能力通过专门设计的任务分别接受检验。任务覆盖准备咖啡、收纳物品、加热食物、铺桌布、擦拭桌面等家庭活动,既涉及局部操作,也包含多步骤执行。
在场景级评测中,RobotAgentBench 进一步设置准备晚餐、招待客人、准备出门和整理房间四类开放式场景。机器人接收高层需求,自主探索环境、识别相关任务,并安排执行过程。由此,评测从单项能力延伸到多种能力能否在一个持续运行的闭环中协同工作。
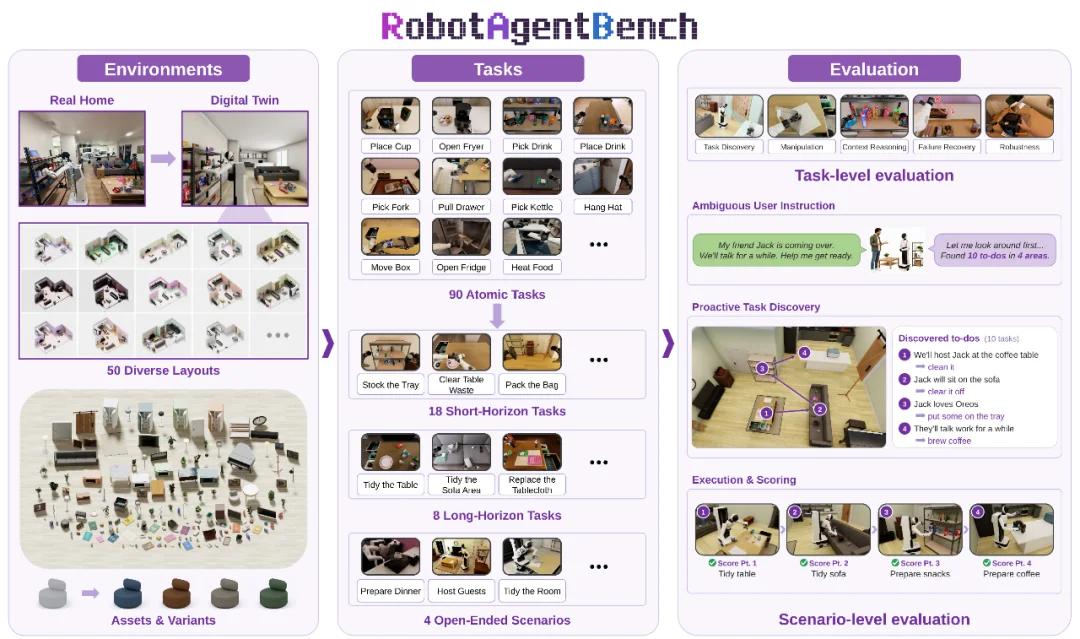
要评估家庭中的自主能力,环境既要保留物理交互的复杂性,也要支持可扩展的比较实验。
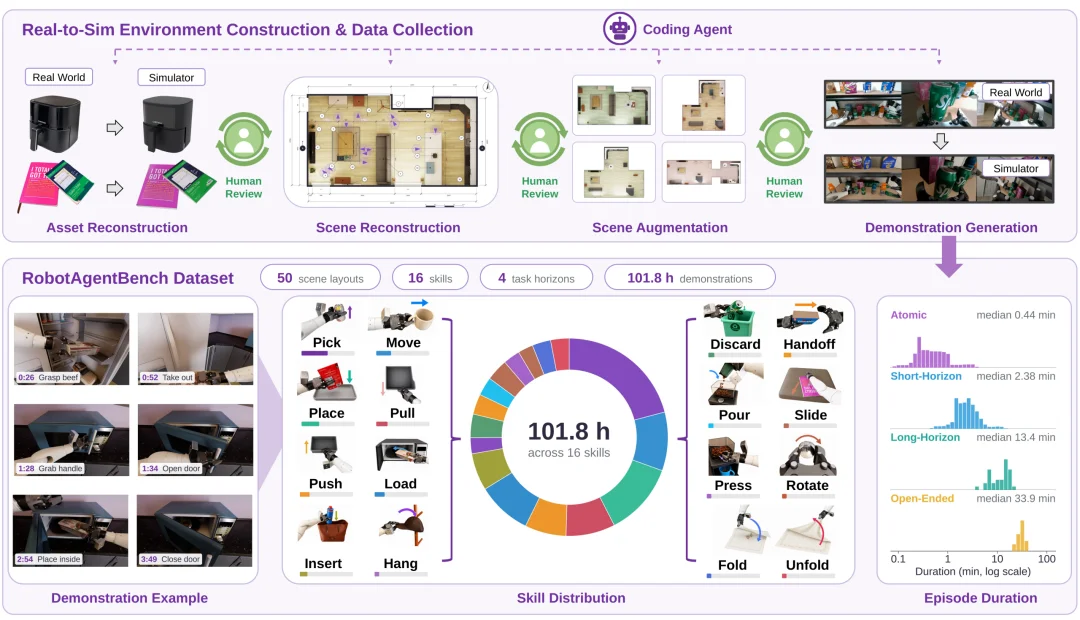
为此,研究团队开发了由智能体辅助、人工参与审核的 real-to-sim 流程:从真实家庭中的物理空间出发,在仿真中重建场景,再扩展为不同的交互式环境配置,并采集训练与评测所需的演示数据。
通过这一流程,RobotAgentBench 构建了 50 种家庭布局,覆盖不同的房间结构、装修、墙面、地板与家具配置。同一任务还包含物体外观、场景布局和光照条件等变化。
这些变化使评测能够考察:当熟悉的物体换了位置、房间布局发生改变,或者光照与外观不再相同时,机器人能否继续作出有效判断并完成交互。
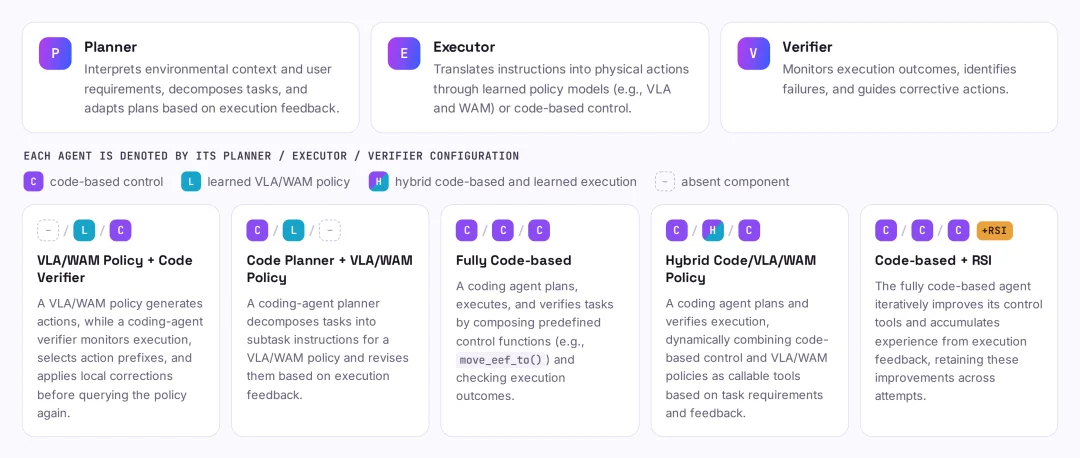
机器人系统的表现既取决于底层策略,也取决于系统如何安排任务、调用工具和处理执行反馈,RobotAgentBench 因此采用统一的「规划—执行—验证」框架,比较不同组件组合带来的影响。
规划器负责理解环境与用户需求、拆解任务,并根据反馈调整计划;执行器通过学习策略或代码控制完成物理动作;验证器检查执行结果、识别失败,为后续纠错提供依据。
基于这一框架,研究比较了五类设计:为 VLA/WAM 策略增加检查执行结果、局部修正动作的代码验证器;由代码规划器生成子任务指令,交给学习策略执行;完全通过代码完成规划、执行与验证;动态结合代码控制和学习策略的混合执行;以及加入递归自我改进(RSI)、能够持续优化控制工具和积累经验的全代码系统。
其中,混合执行允许智能体根据任务要求和执行反馈选择工具。例如,先通过代码控制把夹爪移动到物体附近,再调用学习策略完成对接触更敏感的抓取过程。RSI 则允许智能体根据执行经验迭代改进可复用控制函数,并在后续尝试中保留这些改进。
评测覆盖 8 个 VLA 模型和 3 个 WAM,以及 Codex、Claude Code 和 Antigravity CLI 等编码智能体。这使 RobotAgentBench 能够同时考察底层策略能力和上层系统设计。
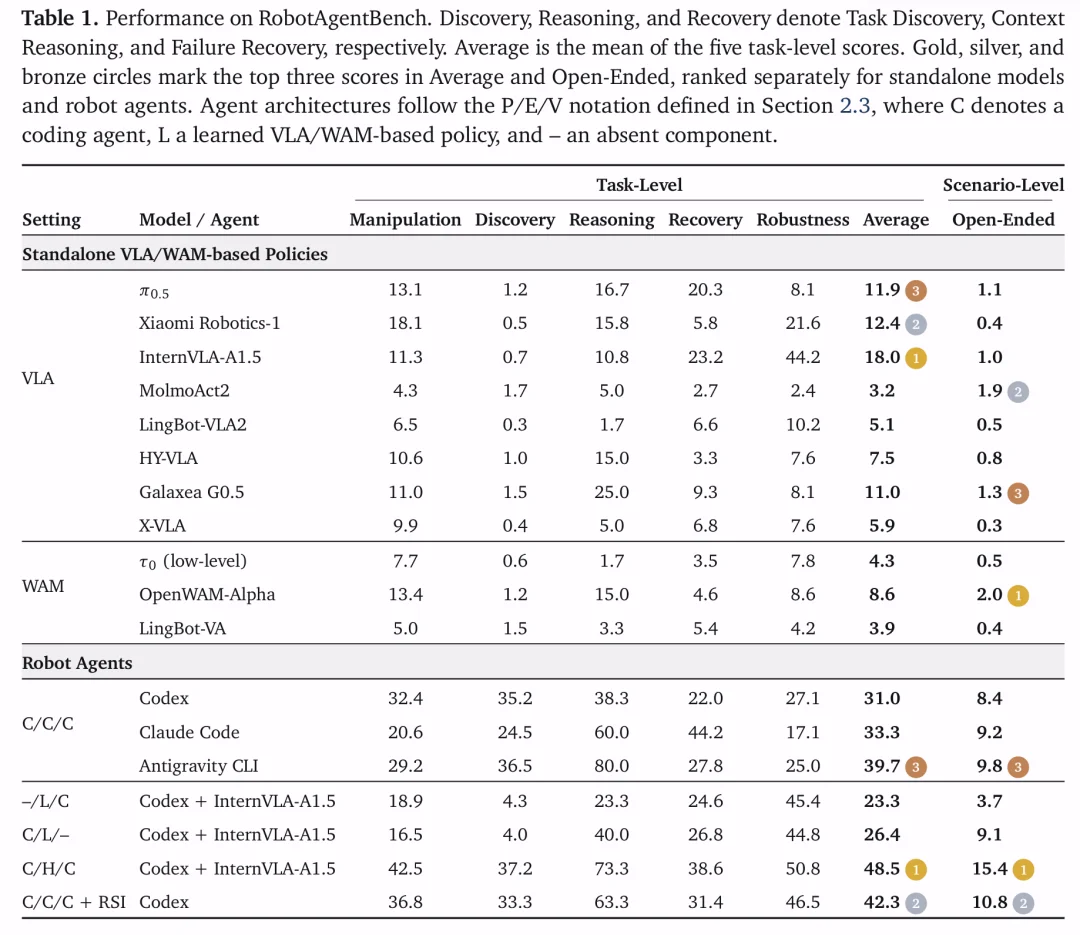
在独立策略模型中,InternVLA-A1.5 的任务级平均分最高,为 18.0,且在失败恢复和鲁棒性方面表现突出。但这些优势并未直接转化为开放场景中的自主能力。
主表中,独立 VLA/WAM 策略的任务发现得分均低于 2,开放场景综合得分最高仅为 2.0。进一步的行为分析显示,InternVLA-A1.5 和 OpenWAM-Alpha 在开放场景中的停滞时间占比分别为 88.3% 和 84.6%。它们经常处于闲置或无有效进展的运动状态,难以根据情境主动开展任务。
引入编码智能体后,系统在任务发现和情境推理上的表现明显改善。在全代码配置中,Antigravity CLI 的任务级平均分达到 39.7,情境推理得分为 80.0。
采用 Codex 与 InternVLA-A1.5 的混合配置后,任务级平均分进一步达到 48.5,开放场景综合得分达到 15.4,是主表所列配置中的最高值。相比之下,Codex 全代码配置的对应得分分别为 31.0 和 8.4。
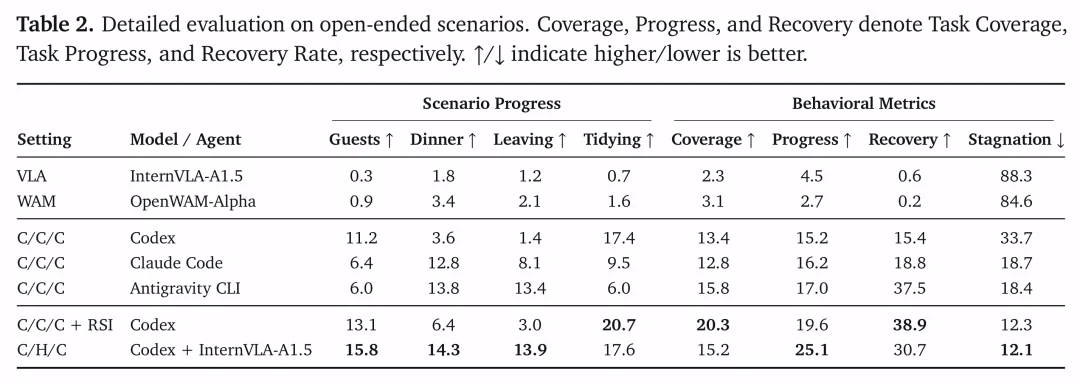
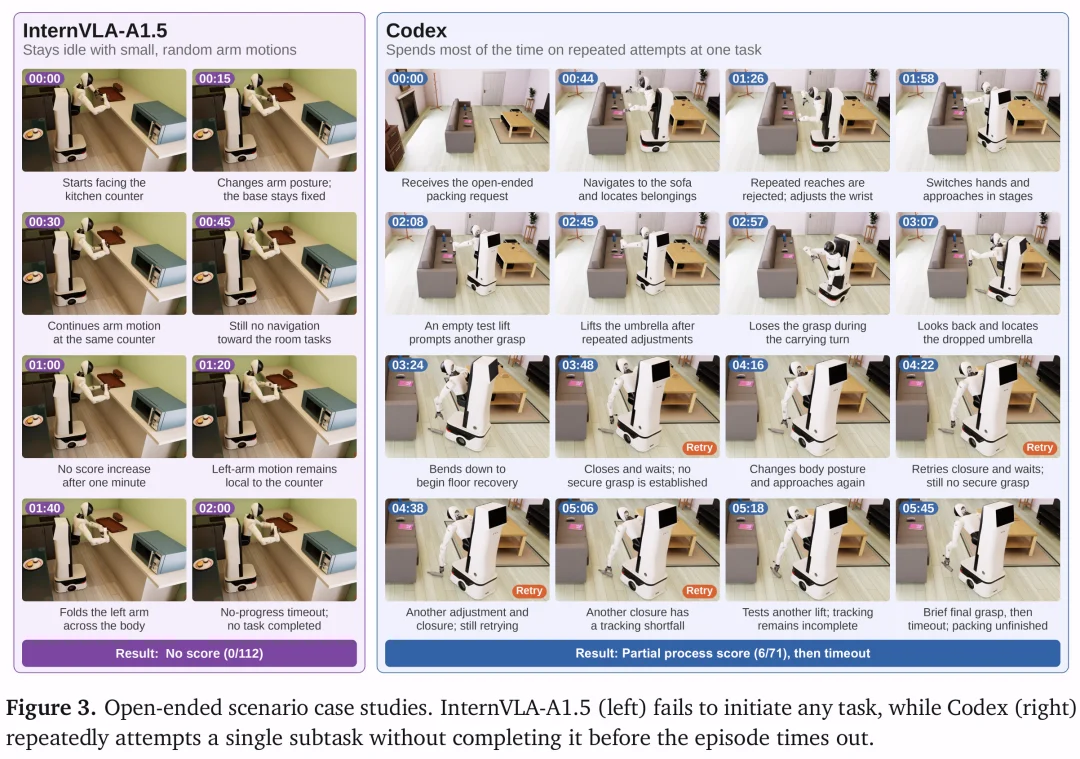
研究进一步通过任务覆盖、已启动任务的归一化进展、失败恢复和停滞等指标,分析机器人在哪些环节取得进展、又在哪里受阻。案例分析显示,InternVLA-A1.5 未能主动启动任务,而 Codex 虽然能够开展任务,却持续重试同一个子任务,直到耗尽时间。这两类现象揭示了当前系统在自主发现任务与持续推进执行方面的不同瓶颈。
在不同规划器与执行器的组合实验中,Antigravity CLI 作为规划器带来的提升最大,InternVLA-A1.5 则是所比较策略中表现最好的执行器。
研究进一步分析了规划器生成的指令。Antigravity CLI 倾向于使用更短的指令、更简单的词汇,较少切换指令,也较少加入具体执行细节。Codex 则经常生成更细致的操作要求,甚至指定使用哪只手。
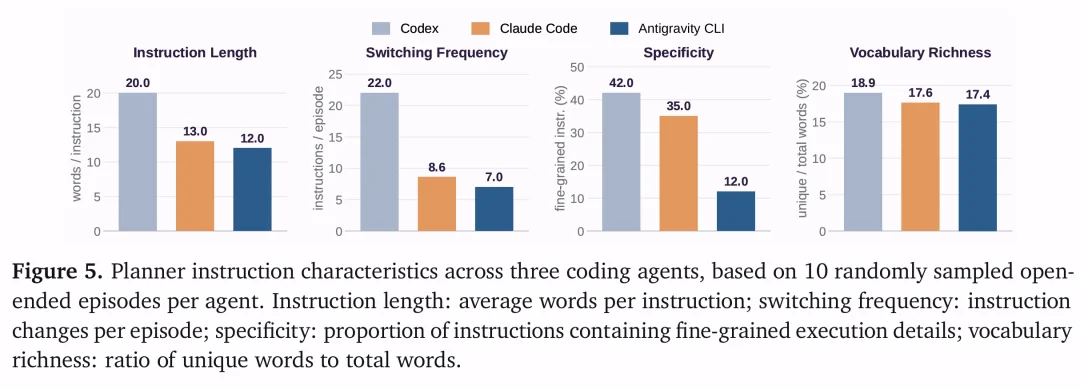
这一观察提示,规划器与执行器之间存在指令适配问题:对规划器而言更完整的描述,可能超出学习策略可靠理解和执行的范围。实验中的表现差异说明,除了规划能力本身,指令表达方式与底层策略之间的匹配也值得关注。
RobotAgentBench 还评估了递归自我改进:让智能体从执行反馈中修改控制工具、积累经验,再将改进用于后续尝试。
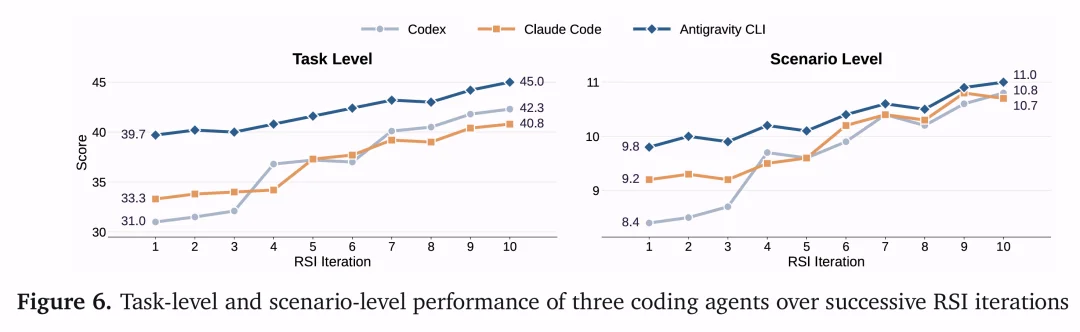
在连续十轮的实验中,三种全代码智能体在任务级和场景级评测上均取得提升。例如,智能体逐步学会将一次难以完成的伸手动作,拆解为经过可行中间位姿的多个步骤。
以 Codex 为例,第十轮 RSI 后,其任务级平均分从 31.0 提升至 42.3,开放场景综合得分从 8.4 提升至 10.8。在开放场景行为指标上,停滞时间占比从 33.7% 降至 12.3%,失败恢复指标从 15.4 提升至 38.9。
这些结果表明,在所测试的设置下,改进可复用工具与积累执行经验,可以为机器人智能体带来持续收益。不过,改进后的开放场景表现依然有限,自我改进如何转化为更广泛、更可靠的自主能力,仍需进一步研究。
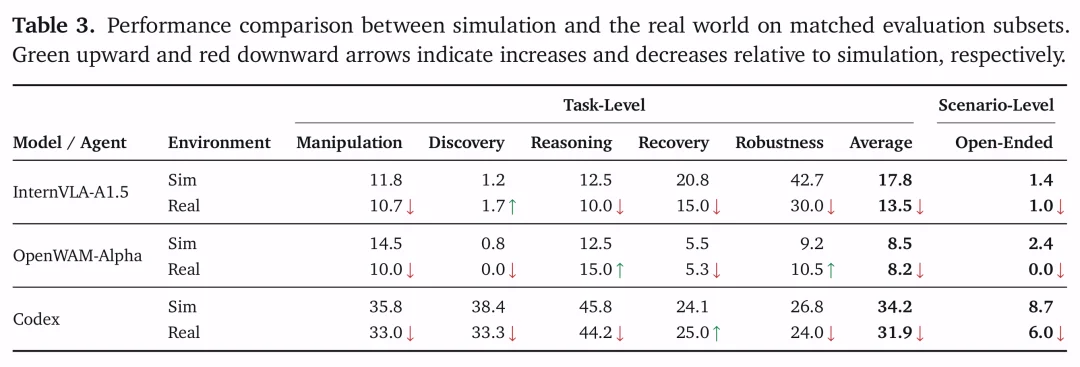
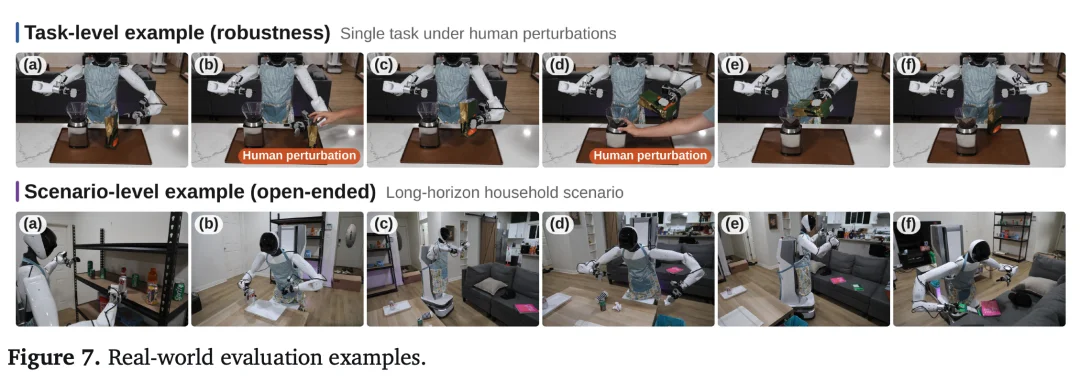
研究团队还使用轮式人形机器人,在真实家庭与对应仿真环境的匹配子集上评估了 InternVLA-A1.5、OpenWAM-Alpha 和 Codex 全代码配置,并匹配训练演示数量。
真实环境中的总体得分普遍下降。例如,Codex 的任务级平均分从仿真的 34.2 降至真实环境的 31.9,开放场景综合得分从 8.7 降至 6.0;InternVLA-A1.5 的任务级平均分从 17.8 降至 13.5。
尽管绝对分数下降,三种方法在这组匹配子集上的总体相对排名保持大致相同。这一结果为仿真评测的参考价值提供了支持,同时也说明,更复杂的物理交互和真实环境条件,仍会放大现有系统的不足。
围绕机器人仿真环境的构建,Aether AI 团队此前还提出了 Video2World,评估编码智能体能否仅凭一段操作视频,重建可执行的仿真场景,并让机器人复现视频中的任务。这项工作与 RobotAgentBench 分别从环境构建和自主能力评测两个角度,探索机器人走向真实应用所需的基础能力。
文章来自于"机器之心",作者 "机器之心"。

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
