
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
本文作者来自 Lehigh University、University of British Columbia 与 Vector Institute。共同第一作者为 Lehigh University 博士生宋定杰(Dingjie Song)与 Zhiling Yan,通讯作者为 Lehigh University 助理教授 Lichao Sun。
让大模型「多想一会儿」,今天几乎等同于让它多写一些字:先生成一段思维链,再给出答案。
但在很多实际系统里,模型要做的只是一个选择:这条请求交给哪个工具,这段文本属于哪一类,几个候选动作里选哪一个。Jev、Kev 这类「决策模型」就是为此设计的。它们读入问题和候选项,一次前向计算就给出每个选项的概率,几十毫秒返回,不生成任何文本。
决策模型快,但计算量在训练时就定死了。简单题和难题花同样多的计算,遇到难题也没法多想一会儿。另一条路是让模型先写推理再作答,可这样每个问题都要为推理文本付费,简单题也不例外。
与此同时,循环 Transformer 最近再度成为业界关注的热点。以字节 Seed 的 Ouro 为代表的原生循环语言模型,在预训练阶段就让同一组层反复计算,把「多想」放进了隐藏状态里。
能不能让决策模型也这样「多转几圈」?
近日,来自 Lehigh University 等机构的研究者提出 Lev,一个用循环而不是 token 来加深思考的决策模型。Lev 在每一圈之后都读出一次选项概率,各圈联合训练,所以同一份权重可以在任意深度作答;一个轻量的停止器再按题目决定算几圈。作者把这种计算方式称为 System 1.5 :保留 System 1 直接给出决定的接口,又能像 System 2 一样在难题上多花计算。
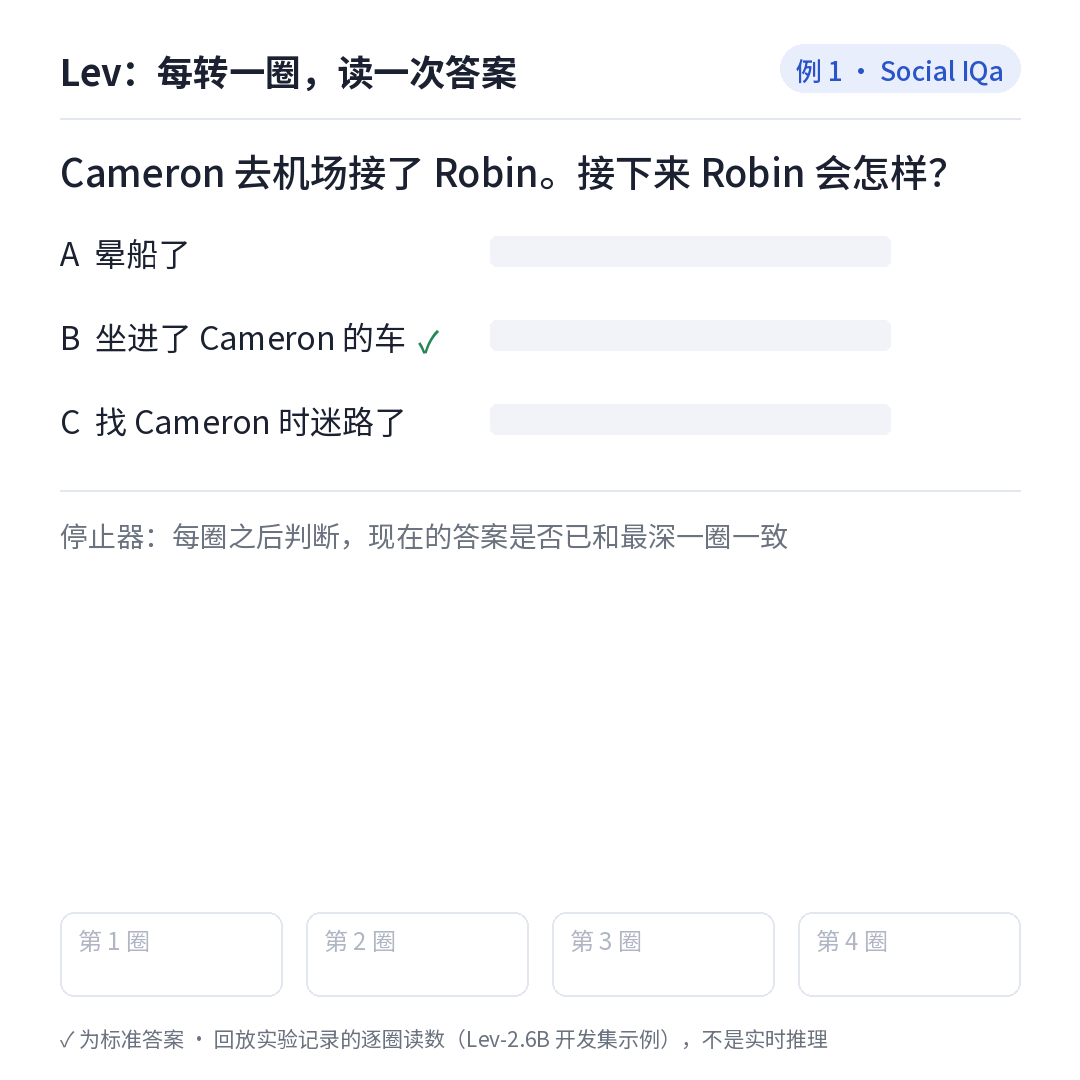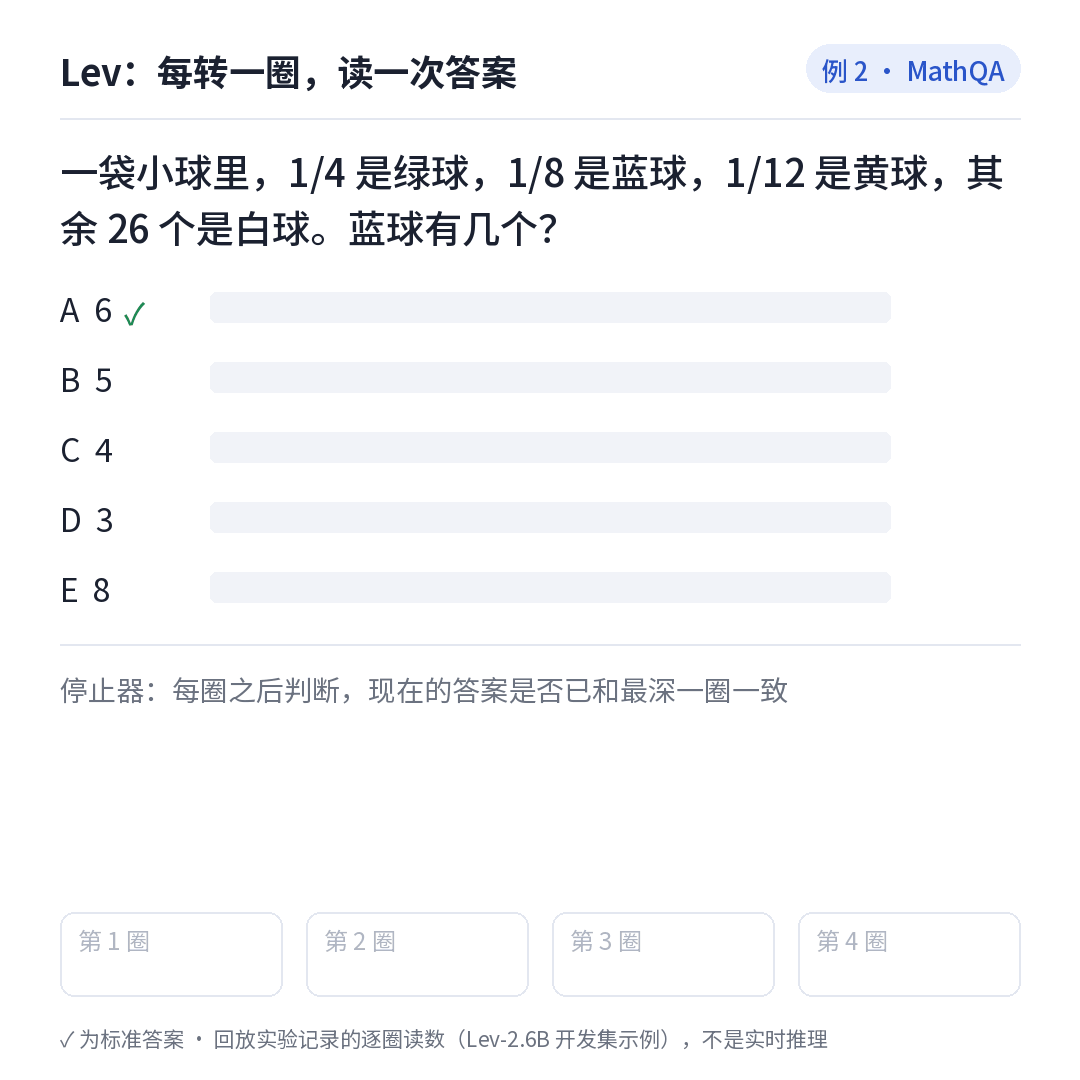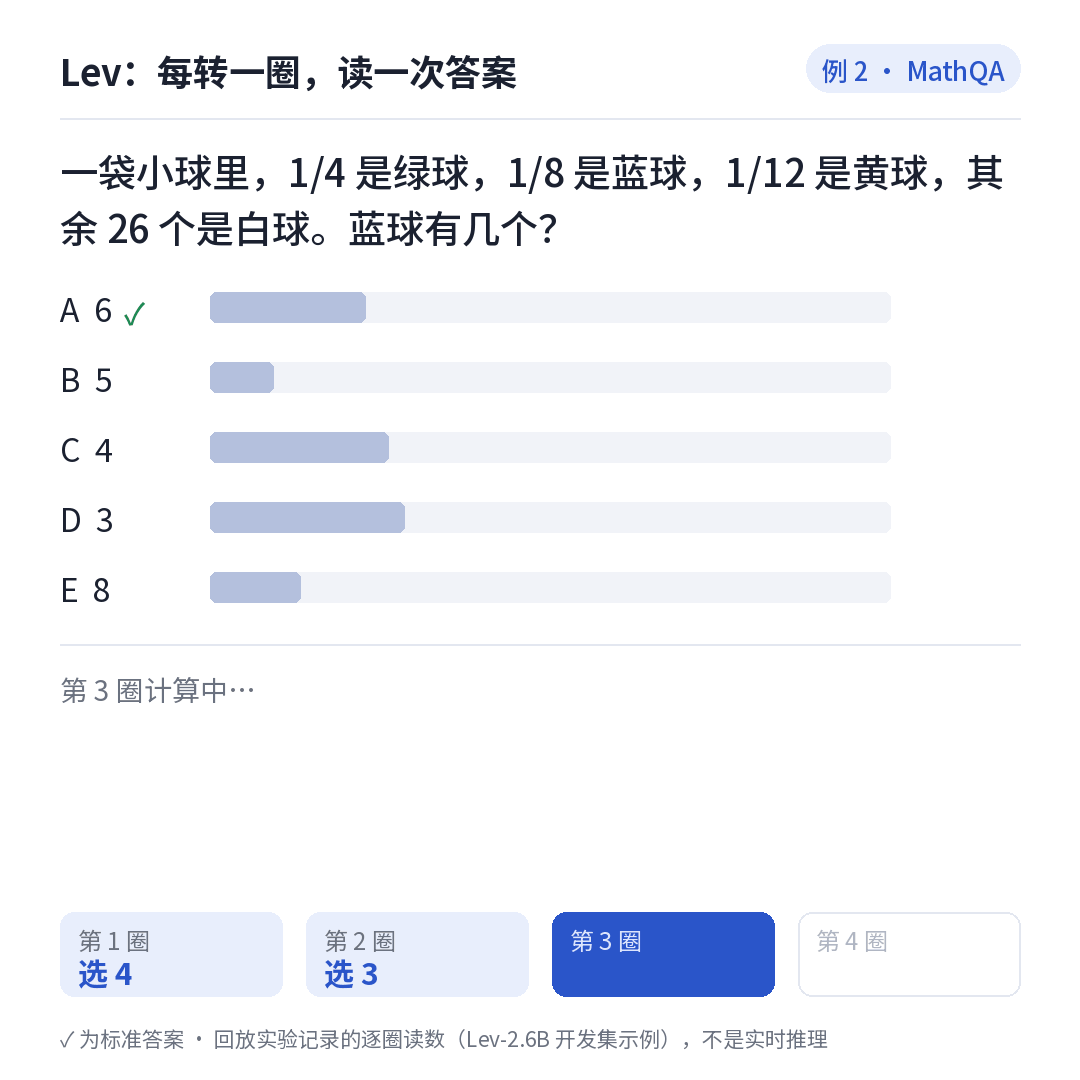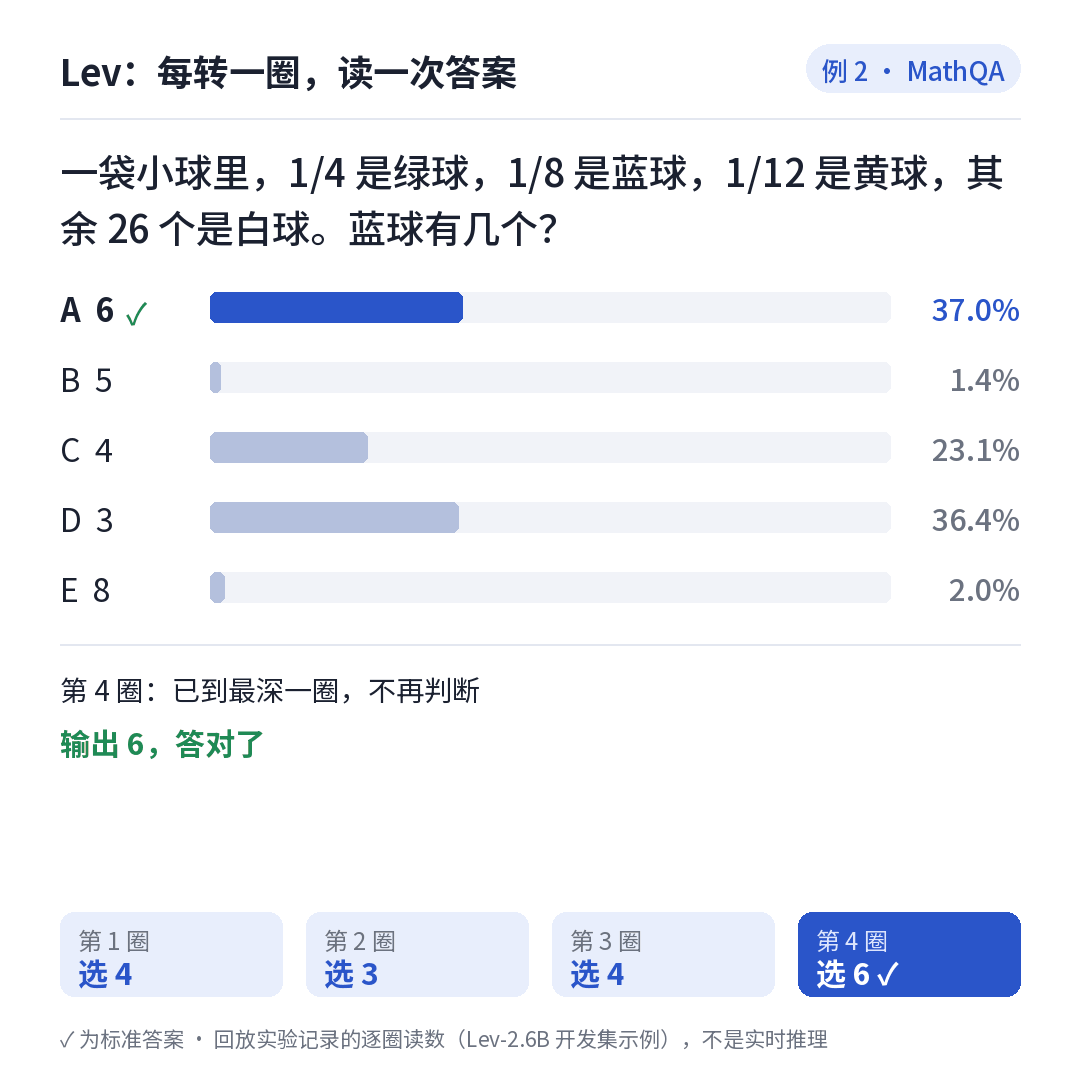
Lev 逐圈作答(按项目主页记录的逐圈读数重绘,回放实验数据,不是实时推理):例 1 第 1 圈就选中正确答案 B,停止器判定可以停下;例 2 第 1 圈选 4,到第 4 圈改选正确答案 6。
从任务形态看,Lev 可以视为 OpenAI Decisions 式文本决策的一个独立开源实现,并多了一个「深度旋钮」。这里的「式」只指任务形态:给定输入和候选项,输出每个选项的概率。Lev 基于公开的 Ouro、Nanbeige 底座和 Kev 实现,不复刻 OpenAI 的模型权重、内部架构或 API,也没有与其产品做性能对测。
在公开 JevBench 的 231 道题上,同一个 Lev-2.6B checkpoint 从一圈的 63.2% 提升到四圈的 76.2%,增加 13.0 个百分点,权重没换,变的只是循环深度。
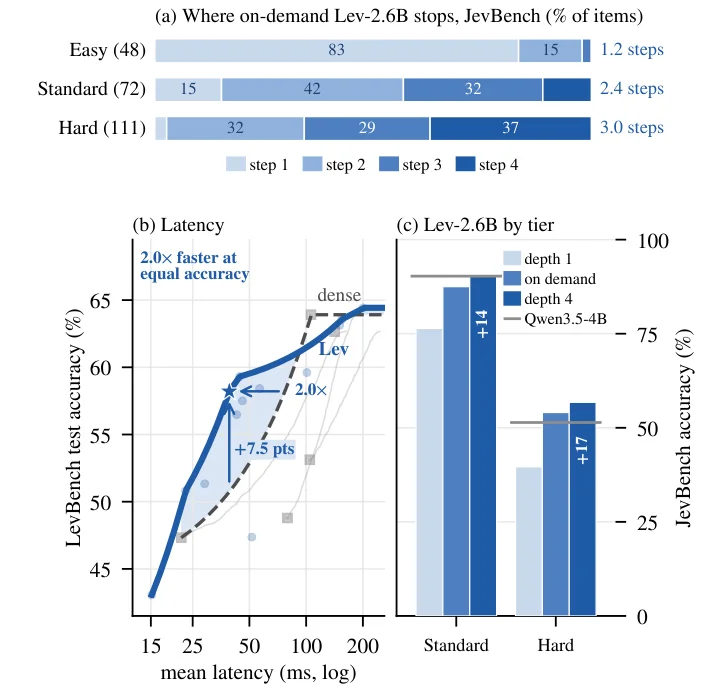
论文图 1:(a) 按需深度下 Lev-2.6B 在 JevBench 各难度档上用的圈数;(b) LevBench 锁定测试上的准确率与延迟;(c) Lev-2.6B 在标准题和难题上一圈、按需、四圈的准确率,对照为同数据训练的 Qwen3.5-4B。
作者先拿两个公开的决策模型 Kev-0.8B 和 Kev-4B 做了一次逐题对比。两者用同样的数据源训练,在 JevBench 的 231 道公开题上,Kev-4B 比 Kev-0.8B 多答对 28 道,而这 28 道全部来自标准题和难题:简单题两个模型本来就全答对了。
更关键的是,两个模型只在 42 道题上结果不同,可 Kev-4B 在每一道题上都多花了参数和计算。如果用 Kev-0.8B 的置信度挑出它最没把握的一半题目交给 Kev-4B,准确率就几乎追平 Kev-4B 全量作答。
换句话说,额外计算只在少数题上有用,而一次便宜的初读就能找到这些题。
那么现有的加计算方式够用吗?作者逐一检查了三种:
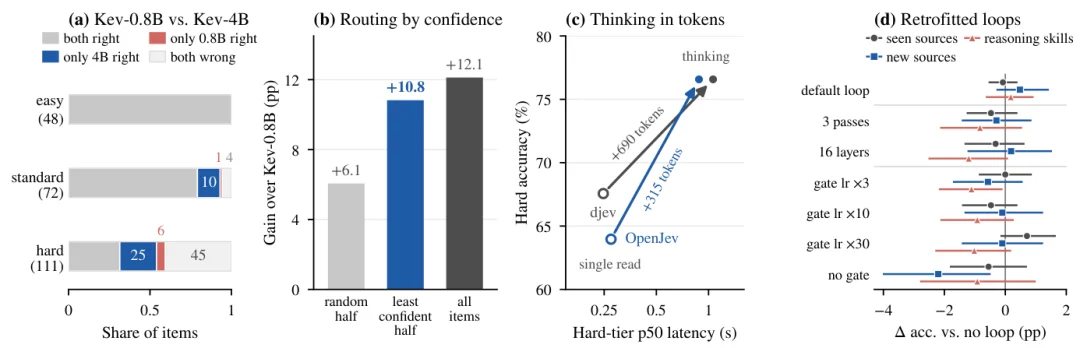
论文图 2:(a) Kev-0.8B 与 Kev-4B 在 JevBench 每道题上的结果;(b) Kev-4B 回答随机一半、最没把握一半或全部题目时相对 Kev-0.8B 的提升;(c) 同一底座上单次读出与生成推理的对比;(d) 给 Qwen3.5-0.8B 加装循环后的准确率变化。
后一点直接决定了 Lev 的设计:与其在决策训练里教模型使用循环,不如从一个预训练时就学会循环的底座出发。
Lev 沿用 Kev 的决策模型接口。一个请求包含一段状态(例如一段对话或一份文档)和若干问题,每个问题列出自己的候选项。所有内容打包成一条序列,用块因果掩码让每个问题只看到状态和自己,这样状态只编码一次,每个问题又像单独提问一样作答。
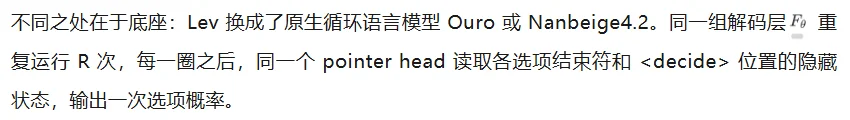
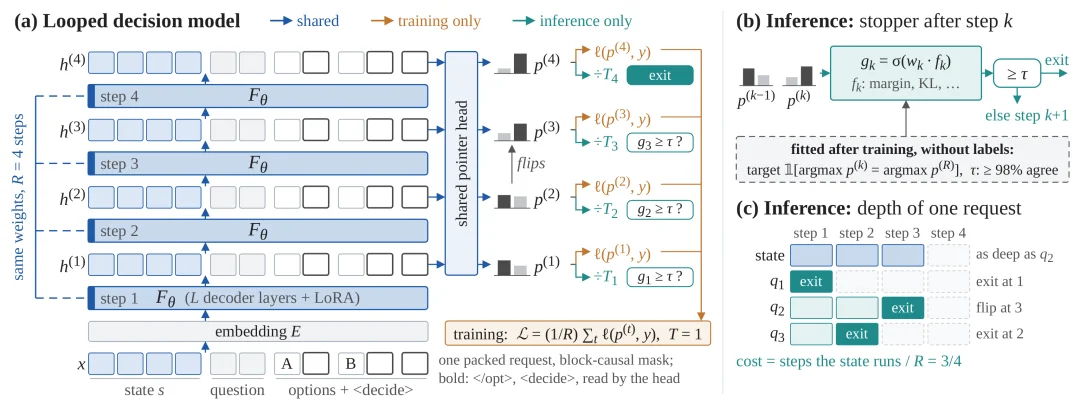
论文图 3:Lev 的结构(以 4 圈为例)。(a) 同一组解码层循环 R 次,共享的 pointer head 每圈读一次选项;(b) 每圈之后,停止器预测当前答案是否已与最深一圈一致;(c) 每个问题在自己的深度退出,状态只算到其中最深的问题所需的深度。
训练时,pointer head 和 LoRA 适配器在各圈之间共享,损失对所有圈取平均,所以每一个深度都被训练成一个可用的决策模型,而不只是最后一圈。
这带来两个直接好处。第一,第 t 圈只依赖前面的圈,用 k 圈服务时只算前 k 圈,成本约为全深度的 k/R。第二,「再算一圈」就是从上一圈的隐藏状态继续往下算,请求不需要重新读一遍,这正是级联做不到的。
此外,浅层和深层读出的校准程度不同,作者为每个深度单独拟合一个温度。温度缩放不改变预测选项,所以不影响准确率。
有了每一圈的读出,下一个问题是:每道题算几圈?
常见的早退做法,是在有标签数据上为置信度挑一个阈值,置信度够高就停。作者发现,这条规则在决策模型上迁移得很差,原因有两个:
因此,Lev 的停止器换了一个预测目标:在第 k 圈,预测当前答案是否已经和最深一圈的答案一致。它是每个深度一个逻辑回归,特征只来自当前圈和上一圈的读出:最高概率、前两名的差距、归一化熵、答案是否变化、两圈分布的 KL 散度等。
这个目标的好处是,标准答案就是模型自己的最深答案,拟合停止器和挑选阈值都不需要人工标签。阈值取能让至少 98% 的最终答案与最深答案一致的最小值。部署时,可以直接用自己业务里的无标签请求来校准停止器。当然,无标签不等于零成本,拿到各圈的输出仍然要算一遍。
作者在三个循环底座上构建了 Lev-1.4B(Ouro-1.4B,4 圈)、Lev-2.6B(Ouro-2.6B,4 圈)和 Lev-3B(Nanbeige4.2-3B,2 圈)。Nanbeige 预训练时只在最后一圈有损失,用来检验 Lev 是否依赖预训练中被监督过的中间圈。
对照组是 Qwen3-1.7B、Qwen3.5-2B 和 Qwen3.5-4B 三个非循环(dense)模型,与 Lev 使用同样的 31,329 条训练数据和同样的配方(LoRA rank 16,训练一轮)。训练标签都不来自 Jev,所以 Lev 不是从被比较的模型蒸馏而来。
评测方面,作者先在三个调优集上定下配方和停止器设计,之后才读取两个 held-out 测试集:一个是覆盖五个应用领域、14 个从未训练过的数据集的 Kev-Breadth;另一个是作者自建的 LevBench,在任何模型读取之前就已冻结,难度档从训练源的新题一路走到完全没见过的数据集。此外还报告 JevBench 的 231 道公开题。
发现 1:同一份权重,深度越深越准,收益递减。
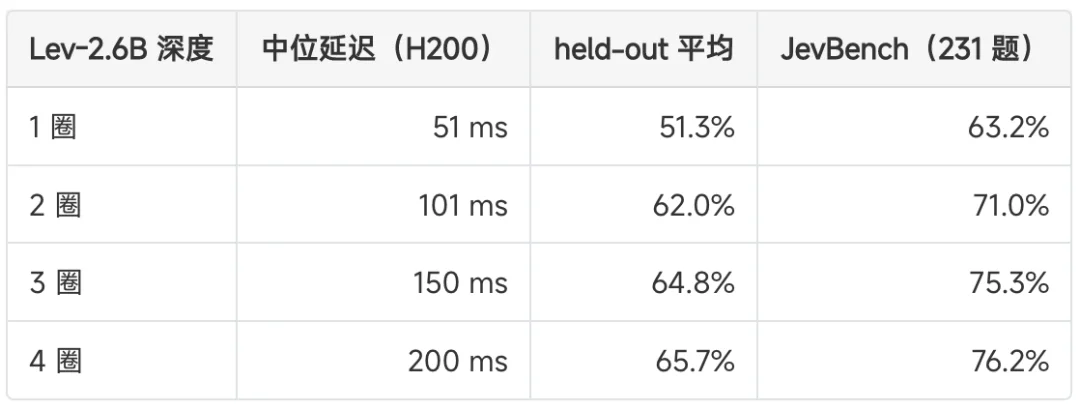
三个底座、所有测试集上都观察到这一趋势。JevBench 上一圈到四圈的提升为 13.0 个百分点(95% 置信区间 7.4 到 19.0)。大部分收益来自第一个额外的圈:Lev-2.6B 的 held-out 平均从 51.3% 升到 62.0%,第四圈最多再加 1 个点。
离训练数据越远,深度的作用越大:在训练数据源上,一圈到四圈约提升 7 个点;在其余四个离训练数据更远的测试集上,提升为 9.0 到 19.5 个点。
发现 2:多出来的计算主要花在难题上。
在 JevBench 上,Lev-2.6B 从一圈到四圈,在 72 道标准题上净多答对 10 道,在 111 道难题上净多答对 19 道;简单题在每个深度都接近全对。难题里有 29 道被改对、10 道被改错,多数修改是纠错。
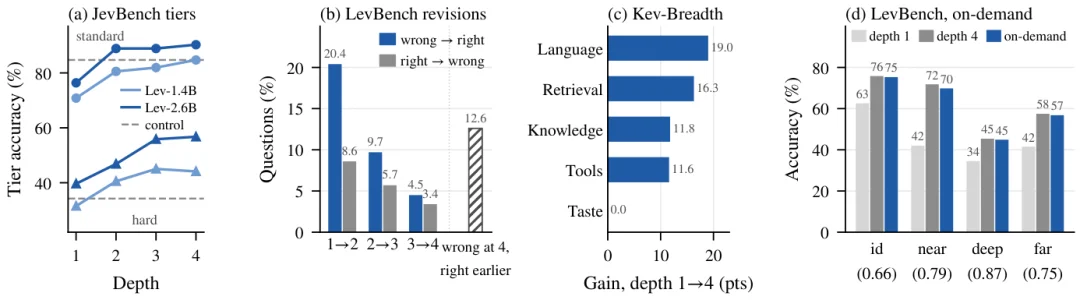
论文图 5:深度在哪里起作用。(a) JevBench 标准题和难题上的准确率;(b) LevBench 上相邻两圈之间被修改的题目;(c) Kev-Breadth 各应用领域从一圈到四圈的提升;(d) LevBench 各难度档的准确率与按需深度的成本。
深度并不只会改对。在 LevBench 上,第一个额外的圈改对了 20.4% 的题,也改错了 8.6%。还有 12.6% 的题,某个较浅的圈答对了,最深一圈却答错了,以「与最深一圈一致」为目标的停止器救不回这些题。不同任务受益也不同:在 Kev-Breadth 上,深度让语言理解类任务提高 19.0 个点,在幽默和颜色偏好这两个「品味」类任务上则没有收益。作者推测,额外的圈提供了组合多个事实所需的串行计算,而品味判断用不上这类计算。
发现 3:按需深度少算 15% 到 24%,准确率损失不到 1 个点。
在两个 held-out 测试集上,停止器只用了最深一圈 76% 到 85% 的计算,准确率与最深一圈相差不到 1 个点(0.3 到 0.8 个点)。
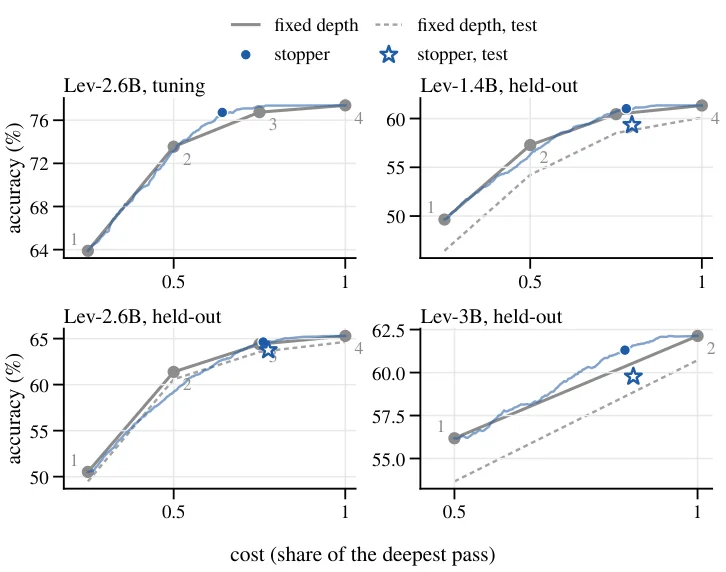
论文图 6:准确率与计算成本。灰色为各固定深度及其连线(固定深度前沿),蓝线为移动停止器阈值得到的曲线;虚线和星号为锁定测试上的结果。
停止器完全看不到题目难度,却会自动把更多圈花在难题上:在 JevBench 上,按需的 Lev-2.6B 在简单、标准、难题上平均分别用 1.2、2.4、3.0 圈。
作者也如实报告了这项收益的边界。与「同等成本下混合使用固定深度」相比,按需深度的优势不大:Lev-2.6B 在 held-out 上只高 0.2 个点,Lev-3B 高 1.0 个点。原因在于 Ouro 模型的前沿本身是凹的,第一个额外的圈就拿走了大部分收益。在锁定测试上(配方和停止器全部定下后只读一次),按需深度相对最深一圈最多损失 1.0 个点,Lev-1.4B 和 Lev-3B 高于固定深度前沿,Lev-2.6B 与前沿持平。
需要说明的是,这里的「少算」是离线统计的环路计算量。要把它变成线上的吞吐或延迟收益,还需要服务端支持不同深度请求的打包和调度,这部分不在本文范围内。
发现 4:关键不在停止器的特征,而在用目标流量校准。
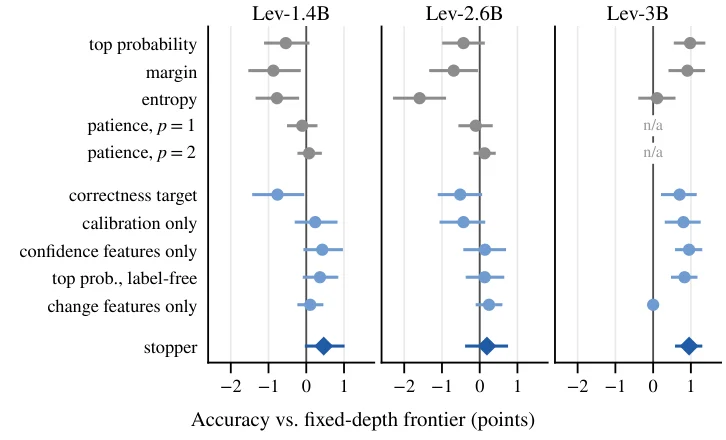
论文图 8:各停止规则在相同成本下相对固定深度前沿的准确率差(95% 置信区间)。灰色为常见早退规则,浅蓝为停止器的消融。
对 Ouro 模型,在有标签数据上调阈值的置信度规则,以及基于差距、熵和 patience 的早退规则,都没能超过固定深度前沿。而只要像停止器那样在无标签目标请求上、以「与最深答案一致」为准则来选阈值,一个简单的最高概率阈值就能做到与停止器只差 0.2 个点。反过来,在有标签校准集上以「是否答对」为目标拟合,两个 Ouro 模型都会跌到前沿以下。
所需的无标签数据也不多:每折 500 道题,就能让 Lev-2.6B 与全量拟合相差不到 0.2 个点。
发现 5:在 50 ms 以内的低延迟区间,小号 Lev 比同延迟的 dense 模型和级联更准。
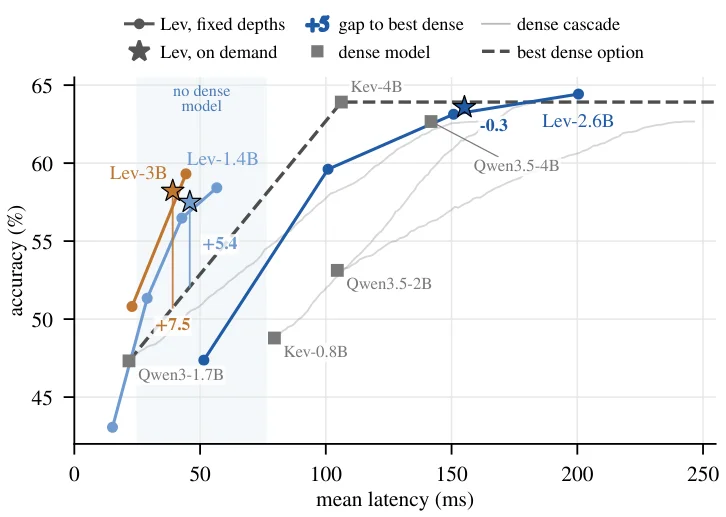
论文图 10:LevBench 锁定测试上的准确率与平均延迟。实线连接同一 Lev checkpoint 的各固定深度,星号为按需深度;虚线为最好的 dense 模型或级联,数字为按需 Lev 与它的差距。
在 39 到 46 ms 的延迟下,按需的 Lev-1.4B 和 Lev-3B 比这一延迟下唯一能达到的级联高 7.0 到 8.8 个点,比最好的 dense 方案高 5.4 到 7.5 个点。
作者同样把条件写得很清楚:
类似地,Lev 能用更少的参数追平更大的模型:Lev-3B 在 JevBench 上与 Qwen3.5-4B 持平,Lev-2.6B 与公开的 Kev-4B 持平(76.2% 对 75.8%,差异不显著)。但参数少不等于运算少。
论文研究的循环底座在 1.4B 到 3B 之间,这是目前能公开获得的规模,更大的循环模型能把深度曲线推多远还有待验证。JevBench 结果只基于 231 道公开题。按需深度的成本以环路圈数计,要转成真实耗时,需要能把不同深度请求打包服务的推理系统。延迟测量没有做任何服务端优化,循环模型和 dense 模型的优化服务都留待未来工作。
Lev 把循环深度变成了一个在服务时才决定的设置:同一份决策模型权重,可以按题目在延迟和准确率之间取舍,而不必为每种预算部署一个模型。实验显示,深度带来的提升主要落在难题上;用「与最深答案一致」为目标、在无标签请求上校准的停止器,能在不看难度的情况下把更多计算分给难题。
作者认为接下来有两个方向:设计能救回「浅层答对、深层答错」那 12.6% 题目的停止目标,从而超过最深一圈的准确率;以及在更大的循环底座上检验难题收益是否随规模增长。
论文、代码、三个模型和三个数据集均已公开。数据集是按各来源再分发条款筛选后的子集,无法托管的来源附重建说明。
文章来自于"机器之心",作者 "宋定杰与Zhiling Yan"。

【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
