
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
从GPT的考题,到一杯奶茶,Liber-0 正在拓展零样本泛化的能力边界。
今日,物理AI公司 LiberAI 发布了世界动作模型 Liber-0。它不仅能根据不同口味订单,灵活组合操作技能,完成复杂长程的奶茶制作;还接受了 GPT-6 随机生成的60项任务挑战,在没有目标任务机器人数据示范的情况下,实现从基础抓取到更加复杂长程灵巧操作任务的 Zero-shot 泛化。
支撑这些能力的,是超过220万小时的人类经验。通过 Human Data Scaling,LiberAI 正在将人类积累的海量物理经验,转化为机器人可持续扩展的通用泛化执行能力。
从单一技能到复杂长程任务,从零样本泛化到真实场景应用,通用物理智能的潜力正在逐步显现。
过去,机器人学习一项技能,通常需要为该任务采集大量对应的真机后训练数据。这套模式可以让机器人在特定场景中达到较高的执行水平,但也限制了机器人走向更多场景更多任务。
Liber-0 的奶茶制作,展示了另一种可能性。
经过少量后训练,模型能够执行一套较长的奶茶制作流程。而在面对不同订单时,它不必将每种口味都视为一个完全独立的新任务,而是可以根据需求变化,重新组织已经掌握的操作技能。
这里涉及两项关键能力。
第一项是长程灵巧操作。机器人需要连续操作杯子、勺子、配料容器等不同物体,在加冰、加各类小料、加不同糖浆、加各类茶底多个步骤之间保持正确的物理状态。前一个动作的结果会直接影响后一个动作能否顺利执行,任何一次接触偏差,都可能让整套流程中断。
第二项则是组合泛化。不同订单可能共享大量基础操作,却需要不同的技能排列与组合。模型不仅需要会使用这些技能,还需要根据当前任务选择合适的组合方式。
从执行一套固定流程,到根据需求重新组织操作技能,是机器人走向通用化的重要一步。
这种能力一旦持续扩展,潜在的应用范围就不再局限于奶茶制作。在餐饮、零售、物流、工业生产等场景中,大量真实任务都具有相似特征:基础操作相对有限,但实际任务需求与组合方式却千变万化。
Liber-0 模型在做奶茶任务中展示了一条值得期待的路径:通过大规模预训练获得通用操作能力,再以少量后训练适应具体场景,模型驱动技能自动灵活组合覆盖更多实际需求。
而比做奶茶更值得关注的,是 LiberAI 对模型 Zero-shot 泛化能力的一次系统性验证。
衡量模型是否真正具备泛化能力,一个最直接但高难度的方法,就是让它面对没有专门训练过的新任务。
LiberAI 这次将出题权交给了 GPT-6。
由 GPT-6 生成的 60 项任务,被划分为三个难度等级。
最基础的是 Pick-and-Place(PnP),考察物体抓取、移动与放置。
第二组是 Non-PnP,要求机器人完成更复杂的物体交互,包括精细接触、姿态调整以及超越简单抓取的操作。
第三组难度进一步提升,涉及需要连续完成多个步骤的长程 Non-PnP 任务。机器人不仅要执行动作,还要让不同动作在物理状态上正确衔接。
测试的关键限制是:Liber-0 没有使用针对这些目标任务采集的机器人示范进行训练。在三组测试中,Liber-0 分别取得了 63.5%、34.0% 和 10.5% 的成功率,整体成功率达到 36.0%。
其中,尤其值得关注的是第三组任务。对于涉及多个连续步骤的灵巧操作,机器人不仅需要完成眼前的动作,还要考虑动作之后的物体状态是否适合下一步执行。例如,抓握方式是否影响后续操作,物体移动后应当如何重新接触,以及如何避免误差在连续动作中不断放大。
这些挑战使得长程操作远比单次抓取复杂,高自由度灵巧手的灵巧执行更是“难上加难”。
虽然10.5%的成功率仍处于早期水平,但它释放出了一个重要信号:没有目标任务的机器人示范,模型也已经开始能够完成完整的、多步骤的陌生灵巧操作任务。零样本泛化正在从相对独立的基础动作,向更复杂的连续操作延伸。
而 Liber-0 的 Zero-shot 泛化能力,与上层 Agent 的结合,也为更复杂的长程任务打开了新的想象空间。
Liber-0 已支持接入 Astra 等上层 Agent,由 Agent 进行任务规划、跟踪执行状态、管理中间目标,再调用 Liber-0 完成具体的物理操作。
值得注意的是,在 LiberAI 公布的同一套任务测试中,Astra 直接作为机器人策略时,三组任务的成功率分别为8.3%、5.0%和1.7%。这一结果也凸显了通用推理模型在 System1 精细物理操作中的局限性。
那么,Liber-0 的这些灵巧泛化能力,究竟从哪里来?
答案指向了 LiberAI 长期坚持的一条技术路线:Human Data Scaling。
此次 Liber-0 使用的预训练数据超过220万小时,其中人类视频达到200万小时,进一步突破了此前 Dyna 等发布的百万小时级人类视频训练的规模。如此庞大的数据背后,是一套支撑海量数据处理的自动化管线和数据基础设施。
但人类视频的规模优势,并不能直接等同于模型的动作能力。
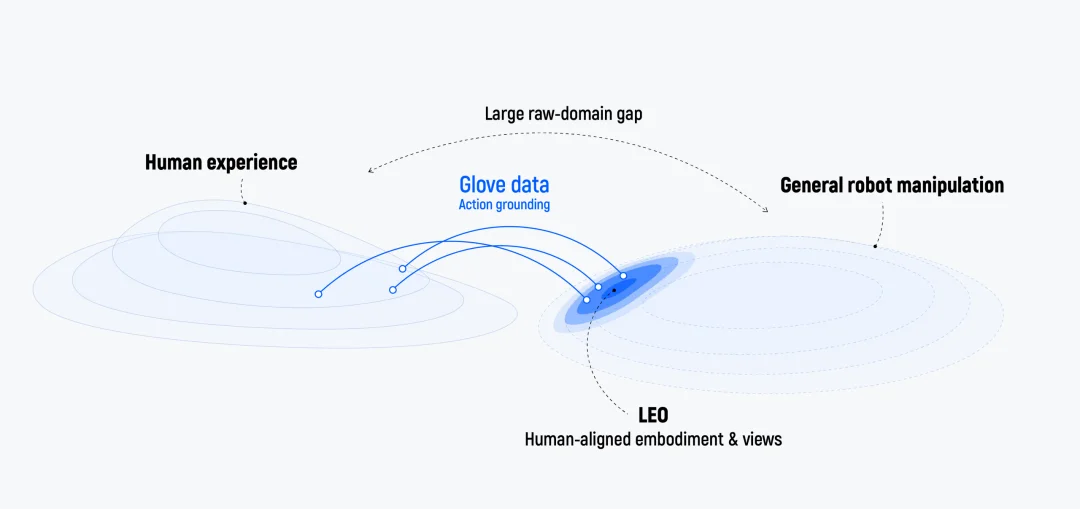
互联网上每天产生大量关于人类如何使用工具、操作物体、完成工作的影像。视频中包含极其丰富的物理知识,却缺少一类关键的信息:人究竟是通过怎样精细的身体运动,完成眼前的操作?
尤其在灵巧手执行场景中,仅凭视觉画面很难准确还原手指的位置、接触方式与运动轨迹。要让机器人真正学会行动,就需要建立视觉经验与动作之间的联系。
为此,LiberAI 自研了 LiberSense Glove,一套能够在真实环境中使用的轻量化动作数据采集系统。
设备通过记录精确的手部姿态与运动轨迹,同时结合第一视角与双腕部摄像头,将人类操作时的视觉信息和动作信息同步采集下来。
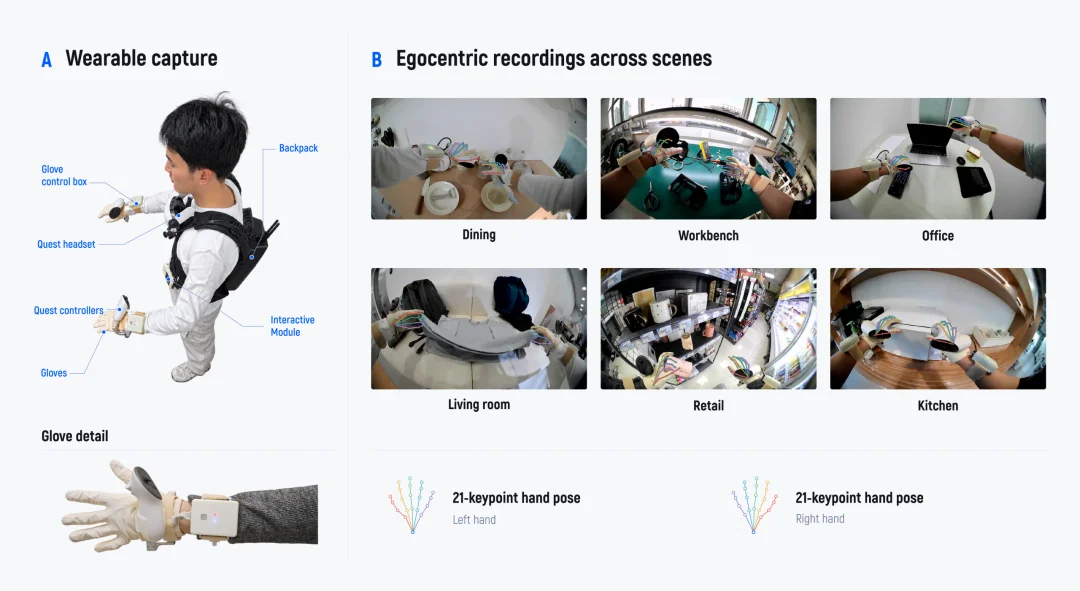
相比依赖机器人遥操作的数据采集模式,这套方案不要求采集现场部署机器人。人们可以直接佩戴手套,在真实工作、生活场景中完成日常操作。
这意味着,家政阿姨收拾房间、零售人员整理物品、工人装配零件、普通人使用工具的过程,都有机会转化为模型可以利用的操作经验。
更重要的是,少量高质量的动作监督,有机会激活更大规模视频中蕴藏的物理经验。
这使得人类视频的规模优势与高质量动作数据的精度优势,可以在同一套模型训练体系中形成互补。对于需要多指协同、精细接触和复杂运动控制的灵巧操作而言,这种数据获取方式尤其具有价值。
随着 LiberSense Glove 在真实世界场景中的规模化部署,LiberAI 正在构建一张覆盖多元物理场景、持续积累高质量人类动作数据的分布式采集网络,将亿万次真实的人类操作经验,转化为驱动物理智能持续 Scaling 的数据引擎。
什么样的人类数据,才是驱动物理智能 Scaling 最有效的燃料?
LiberAI 用一组系统性的对照实验,给出了自己的答案:在与互联网人类视频、开源第一视角数据等不同数据源的直接比较中,LiberSense Glove 数据展现出最陡峭的 Scaling 曲线,以及最显著的模型性能增长。
这意味着,手套数据的价值不再只是技术路线上的判断,而是得到了实际 Scaling 曲线的量化验证:在所比较的数据源中,精准的人类动作数据展现出最强的能力增长效率,为大规模预训练 Scaling 找到了更具潜力的数据 Recipe。
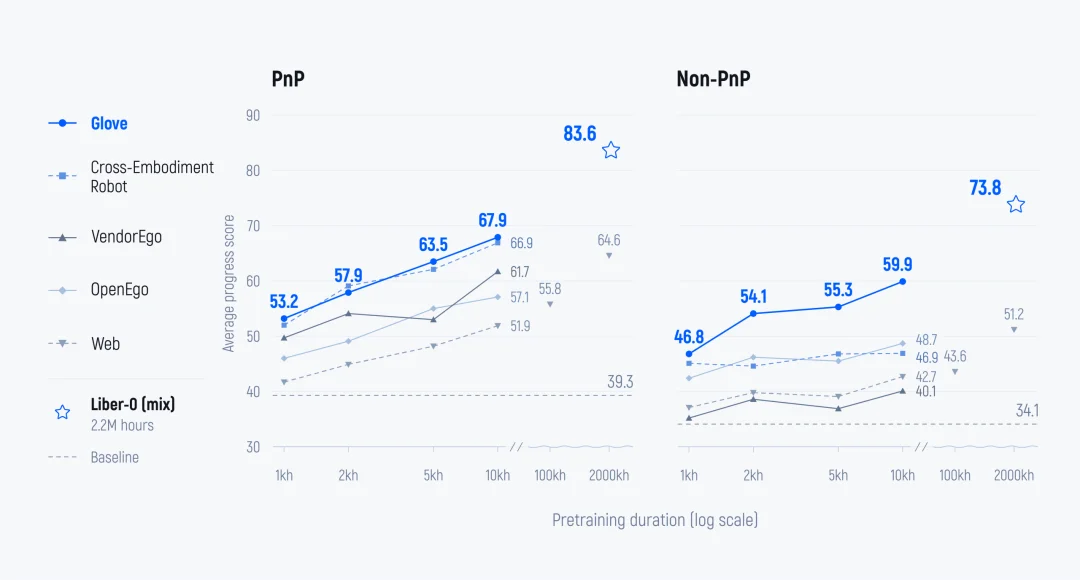
更具突破性的是,LiberAI 通过实验验证:即使没有对应任务的机器人示范,仅依靠人类手套数据,模型也能学会全新的灵巧操作技能,性能甚至接近使用完整机器人示范训练的水平。这意味着,人类数据已经开始具备替代部分真机示范、直接向机器人传递新技能的能力,为机器人技能的规模化学习打开了全新的 Scaling 路径。
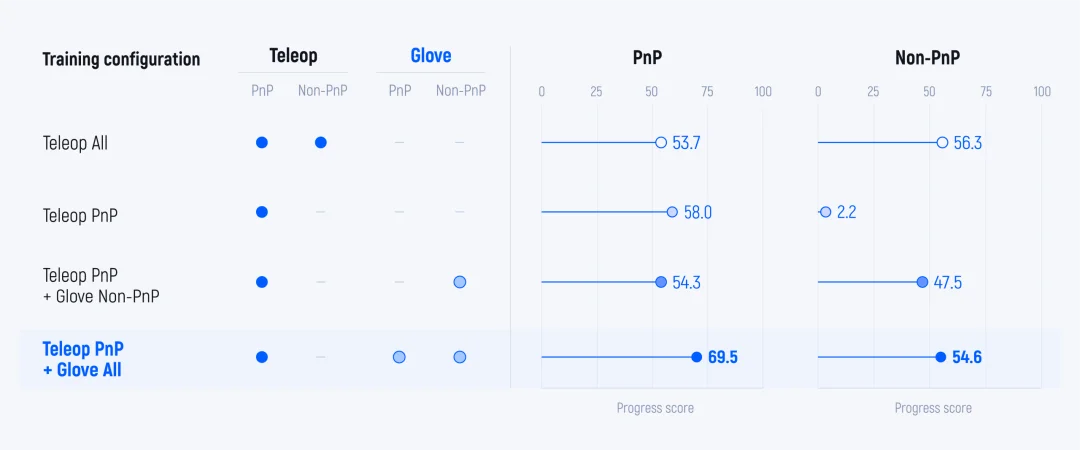
这组实验的意义,远不只是分数提升——人类经验不再只是辅助预训练的背景知识,而是开始成为机器人获得新技能的直接来源。
传统机器人技能采集受到本体数量、遥操作设备、场地和专业操作人员等因素制约。相比之下,让人类直接在真实场景中完成物理操作,天然拥有更广泛的参与者和应用环境。
如果这种人类到机器人的技能迁移能力可以继续扩展,通过人类示教积累技能,再结合少量针对性后训练和部署验证,机器人有机会以更低成本、更快速度进入新的场景与任务领域。
这也是 LiberAI 的独特 Human Data Scaling 路线,值得持续关注的原因。
人类经验迁移还有一个长期存在的难题:人和机器人毕竟拥有不同的身体。
不仅人类与机器人不同,不同人之间的身高、臂长、手部尺寸也存在差异;不同机器人之间,关节结构、运动范围和灵巧手设计同样不尽相同。
过去,解决本体差异的主流思路,是尽可能让数据采集设备与最终执行的机器人保持一致。
LiberAI 则突破性选择进一步利用这些差异。
在 Liber-0 中,团队创新性引入了统一的 Embodiment 表征机制,将身体几何、运动学等信息显式纳入模型的动作预测上下文。
模型在学习任务时,不仅要掌握某种操作应当如何完成,还需要理解不同身体条件下,完成同一任务所对应的动作方式。
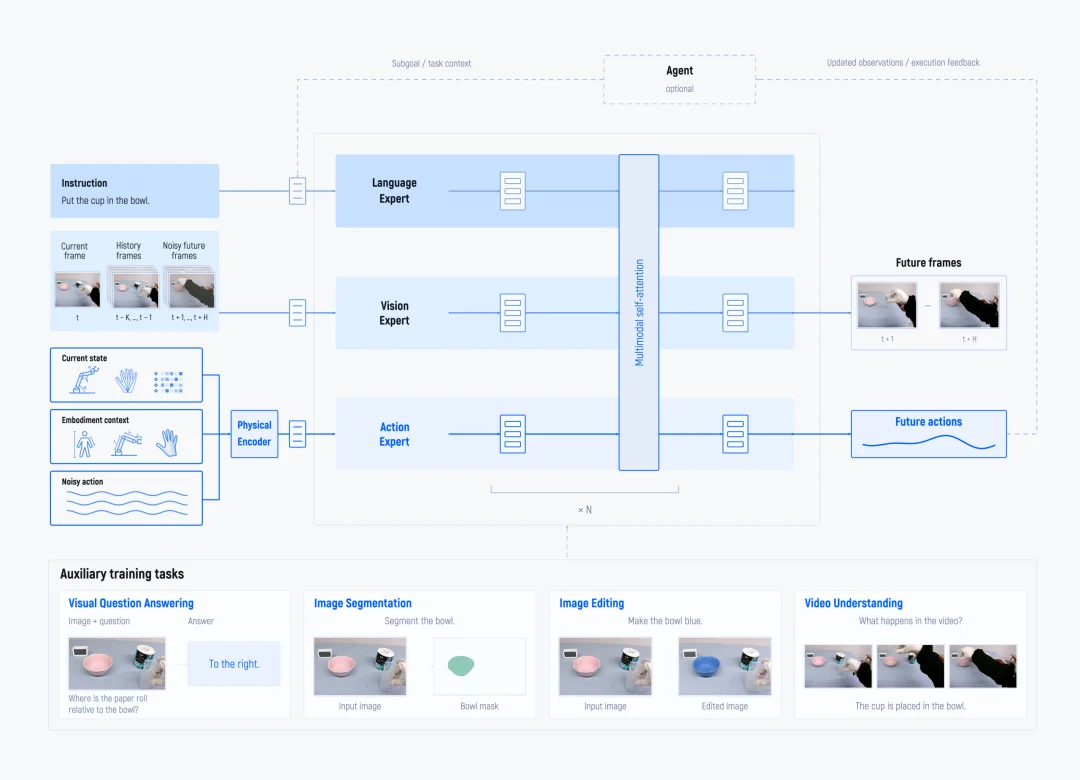
这让一个新的 Scaling 方向浮现出来:除了持续增加训练数据,还可以扩大数据所覆盖的身体形态范围。
LiberAI 的实验显示,在手套数据总时长保持不变的情况下,提升示范者的身体形态多样性,仍然可以持续改善机器人操作表现。
这意味着,本体差异不再只是需要消除的训练障碍,也可能成为模型学习泛化能力的新资源。
由此,LiberAI 的 Scaling 逻辑开始形成更完整的体系。
在人类数据层面,轻量化手套不断扩展高质量动作的规模;在模型层面,海量视觉经验、动作信息与本体表征共同参与训练;在机器人本体层面,硬件结构与运动能力又能够反过来服务模型的数据需求和执行需求。
数据、模型与本体之间,不再是简单的单向传递关系,而是可以相互反馈、共同优化的全栈系统。
有意思的是,此次发布 LiberAI 还同步上线了在线交互式模拟器(sim.liberai.work),大家可以自由上传物体,亲自测试 Liber-0 面对陌生物体时的 Zero-shot 泛化能力,让机器人智能的边界接受更开放的检验。
此次发布的完整技术 Blog 更披露了更多对照实验与 Scaling 细节。比眼前 Demo 更值得关注的,是 LiberAI 用实验验证了一条可持续扩展的 Human Data Scaling 路径。
从 GPT 随机生成的60项任务,到灵活完成不同订单的奶茶制作,Liber-0 正在展现一个重要趋势:机器人不再只是重复训练过的动作,而是开始将已有经验泛化到未知任务,并通过技能组合完成更加复杂的物理操作。
人类与物理世界的每一次交互,都在创造值得被学习的智慧。从指尖的细微动作,到双手完成的复杂操作,无数看似平凡的瞬间,都蕴藏着对物理世界的深刻理解。LiberAI 正在让这些散落于日常生活中的经验被看见、被学习、被传承,汇聚成物理智能持续生长的力量。一个更加广阔的物理智能未来,也正从这些微小而真实的交互中,悄然生长。
参考链接
Liber-0 官方技术 Blog:https://www.liberai.com/blog/liber0
LiberAI 官网:https://www.liberai.com/
文章来自于"Z Potentials",作者 "Z Potentials"。

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
