GPU荒还没结束,CPU可能要被抢起来了
GPU荒还没结束,CPU可能要被抢起来了2026 年 5 月 31 日,英伟达(Nvidia)宣布一颗拥有 88 个定制核心的 CPU 已经进入全面量产。它叫 Vera,采用 Arm 指令集和英伟达自研的 Olympus 核心,既会进入 Vera Rubin 超级计算平台,也会被单独装进 CPU 服务器。戴尔、惠普、联想、超微以及多家服务器厂商,已经开始制造搭载 Vera 的系统。
搜索
2026 年 5 月 31 日,英伟达(Nvidia)宣布一颗拥有 88 个定制核心的 CPU 已经进入全面量产。它叫 Vera,采用 Arm 指令集和英伟达自研的 Olympus 核心,既会进入 Vera Rubin 超级计算平台,也会被单独装进 CPU 服务器。戴尔、惠普、联想、超微以及多家服务器厂商,已经开始制造搭载 Vera 的系统。
Gemini 领跑,GPT表现平平,国立清华、英伟达提出双奖励孪生网络,告别算力焦虑。
就在刚刚,SemiAnalysis的一个内部播客,曝出了不少猛料。据悉,Anthropic新模型Mythos 2已经训练完成,但惨遭雪藏。现在,Anthropic正用Mythos 2生成的数据,去全力冲刺Mythos 3!
为什么偏偏是小尺寸模型?为什么是现在?
DeepSeek Harness ,正在成为全球网友的赛博乐高。我们在内部评测时相关标签显示的插件数量不到 300 个。开放之后,据不完全统计,目前 GitHub 上包含 dsh-plugin(DeepSeek Harness 插件)标签的仓库,已经来到了 6000 多个。
刚刚,闭源RSI的钦点严父来了!
“北航90后副教授”、“在B站教AI”、“3岁小孩都能听懂”……
日产7.5万首,播放却不到3%。
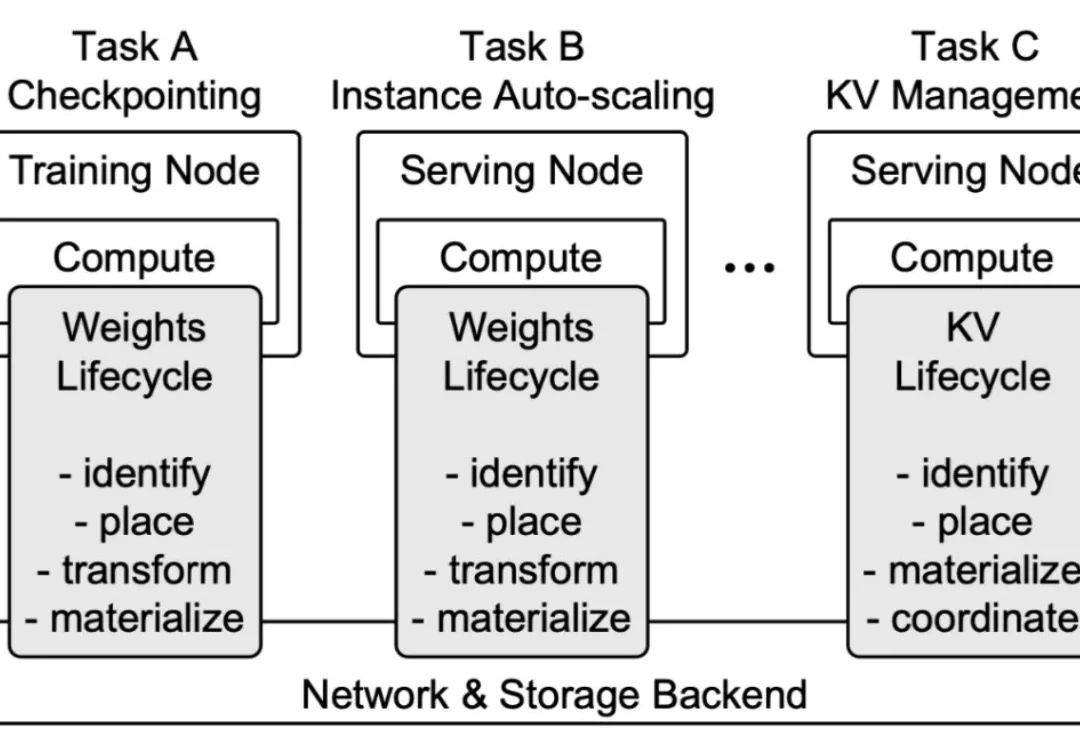
过去几年,大模型推理系统优化的核心目标一直围绕一个问题展开:如何让 GPU 更高效地计算权重、激活、KV Cache 等高维张量?从并行策略、请求调度、显存管理到算子优化,学界业界大量优化技术不断提升模型推理效率。
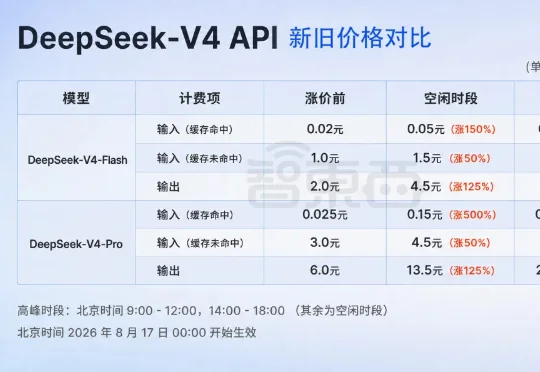
今日零时起,DeepSeek正式执行新版API价格,DeepSeek-V4-Flash和DeepSeek-V4-Pro两款主力模型首次采用峰谷定价,闲时价格统一为高峰时段的一半。此次调整同步抬高了两款模型的基础价格。DeepSeek-V4-Flash高峰时段每百万Tokens缓存命中输入、缓存未命中输入和输出价格分别为0.1元、3元和9元,闲时分别降至0.05元、1.5元和4.5元。