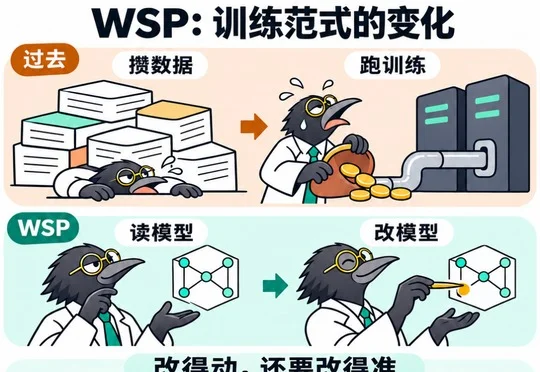
GPT-6 Astra改权重爆火?我们做了一组对照实验,模型根本没变聪明
GPT-6 Astra改权重爆火?我们做了一组对照实验,模型根本没变聪明无涯智远(Norizon AI)的对照实验显示,GPT-6 Astra改动Qwen3.5-0.8B约0.016%权重虽将MATH-500得分从7.9%提至48.1%,但关闭思考模式已有48.95%,且未能稳定内化新知识、风格和技能,改权重不等于变聪明。
来自主题: AI技术研报
9048 点击 2026-11-08 14:49

 搜索
无涯智远(Norizon AI)的对照实验显示,GPT-6 Astra改动Qwen3.5-0.8B约0.016%权重虽将MATH-500得分从7.9%提至48.1%,但关闭思考模式已有48.95%,且未能稳定内化新知识、风格和技能,改权重不等于变聪明。
Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。
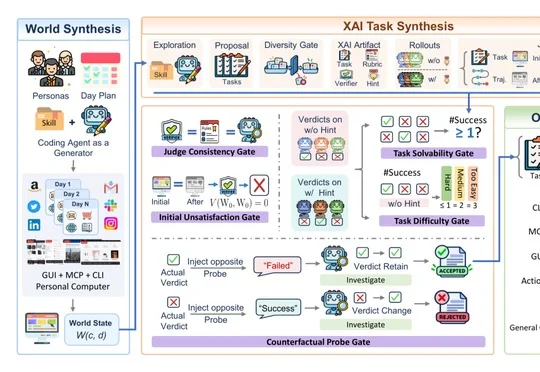
微软研究院等团队提出全开源的WildAWM,合成个人电脑环境、跨GUI/MCP/CLI任务及验证器,并训练Qwen3.6-35b-a3b和Qwen3.5-4b,两款模型在8个分布外基准上均获提升,相关环境、任务、模型与数据均已开源。
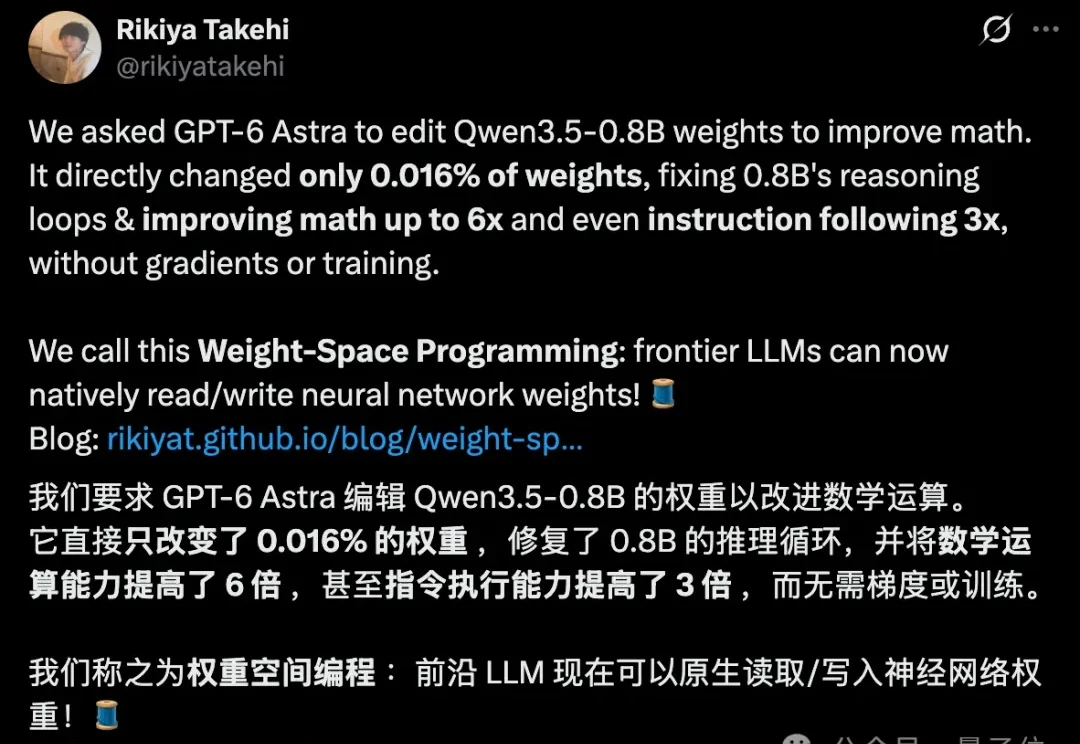
GPT-6 Astra能直接读取编辑小模型权重了。
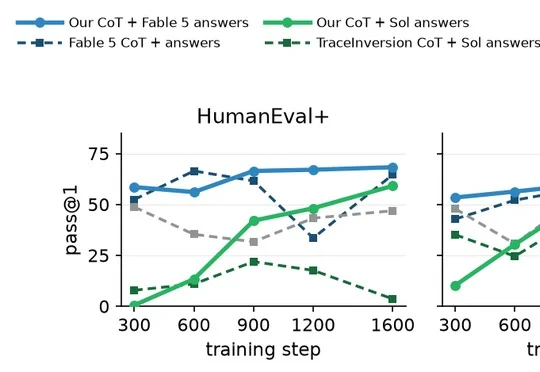
王琰在 TraceForge 技术报告中提出用同族模型合成原生思维链,在 Qwen3.5-9B-Base 实验中超过直接蒸馏 Claude Fable 5 思维链的方案,动摇闭源模型以隐藏思维链构筑的能力护城河。
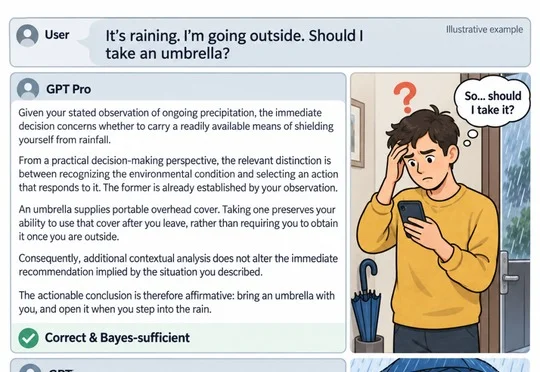
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
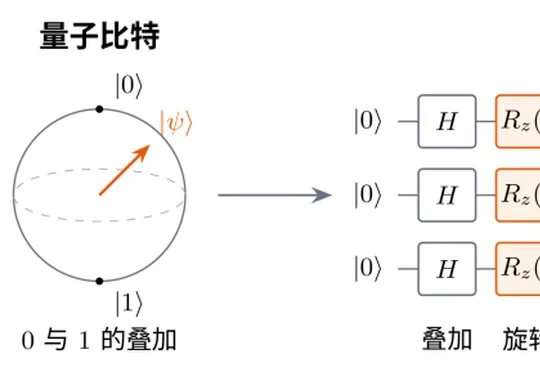
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
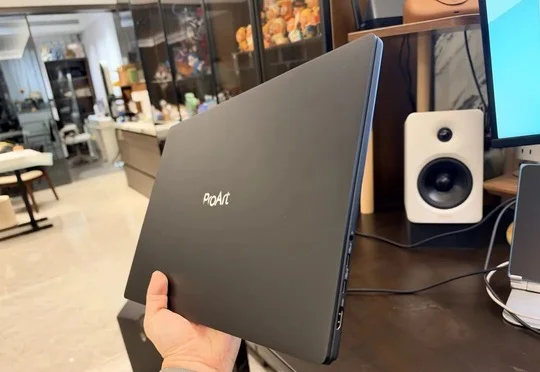
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
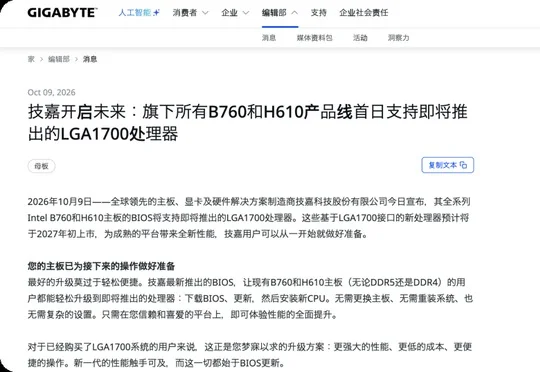
AI需求挤压消费级内存产能并推高PC成本,技嘉通过BIOS更新让B760、H610及DDR4平台继续支持英特尔LGA1700新处理器,开源项目Strata则让消费级电脑本地运行1250亿参数的Qwen3.8-Flash-Next成为可能。
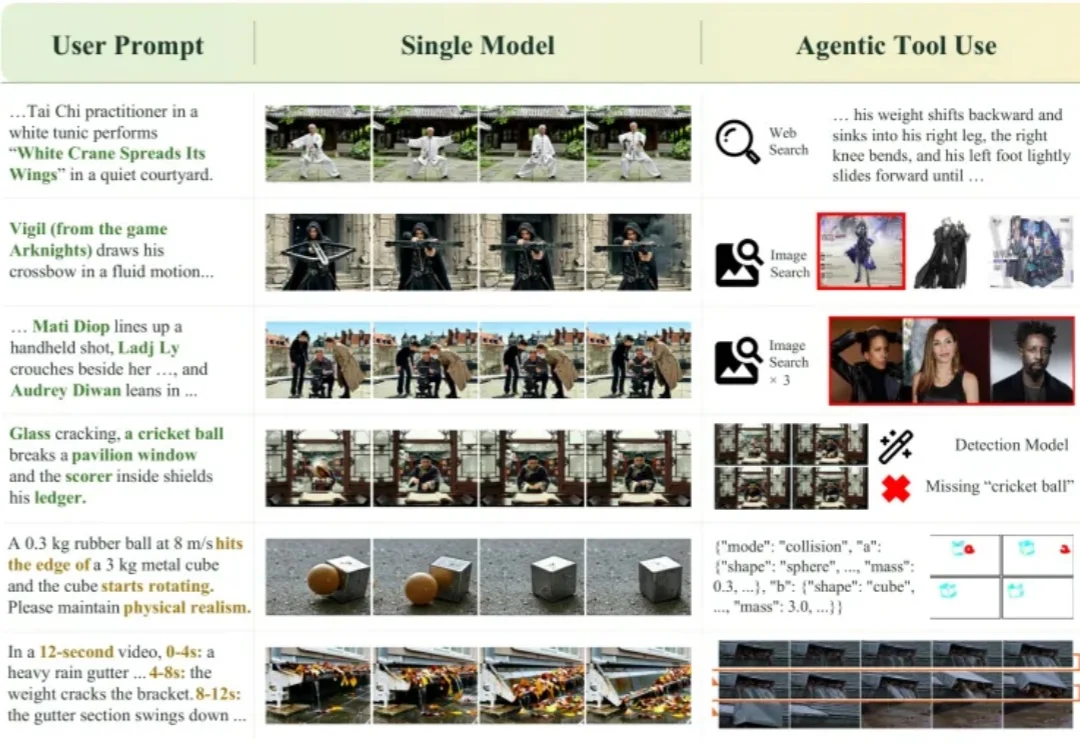
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?