我的上下文资产,凭什么被大厂绑架?
我的上下文资产,凭什么被大厂绑架?开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。
来自主题: AI资讯
8435 点击 2026-09-25 10:13

 搜索
开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。
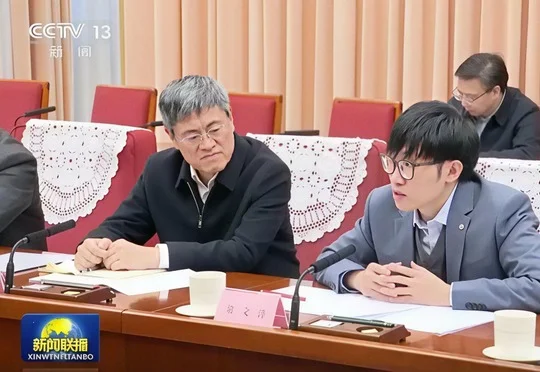
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
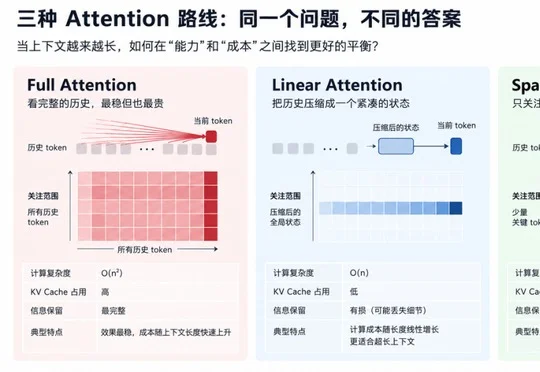
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
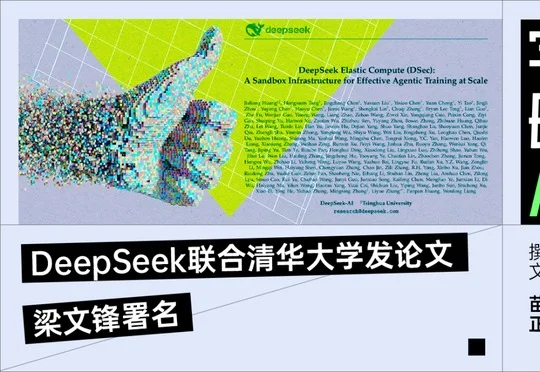
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。
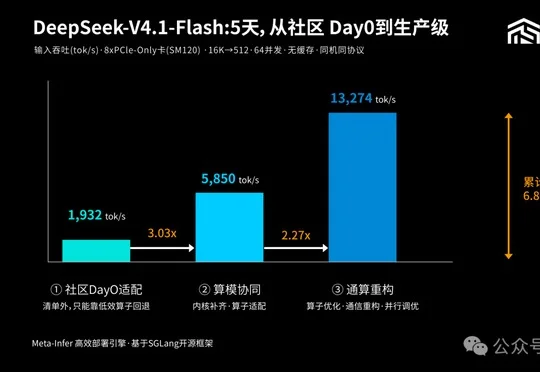
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
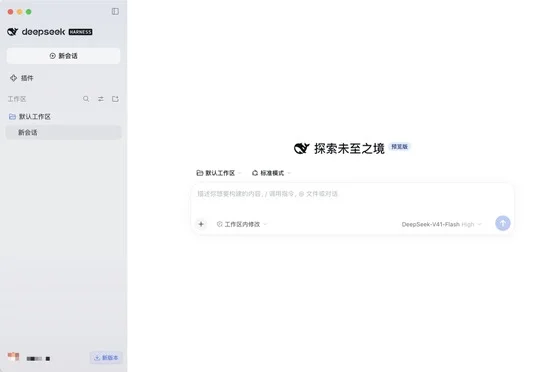
DeepSeek Harness推出桌面版,虽未经官方正式宣布但已通过苹果签名公证,内置智能体团队、语音输入等6个插件并提供标准、PTC、极简、创造四种工作模式,但目前仅支持macOS。
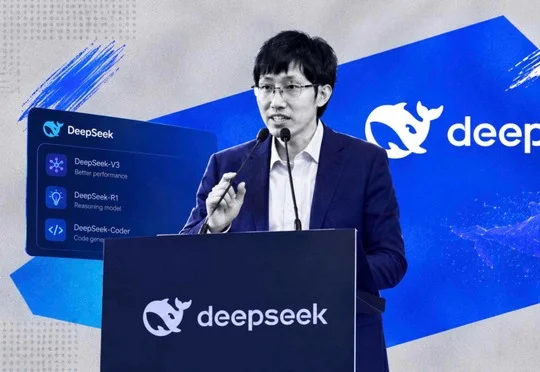
DeepSeek接近完成500亿元人民币的第二轮融资,其年化营收在融资启动后显著增长,且公司近期迎来首任CFO并推进上市筹备工作。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
大模型训练拼的是算力,Agent训练拼的是环境。
价格卷过DeepSeek Flash。