8万亿,梁文锋也开始卷“超大”
8万亿,梁文锋也开始卷“超大”DeepSeek正训练约2万亿参数的新模型,并计划将后续模型参数规模进一步推至8万亿,加入新一轮超大参数模型竞赛。
来自主题: AI资讯
9290 点击 2026-09-23 16:08

 搜索
DeepSeek正训练约2万亿参数的新模型,并计划将后续模型参数规模进一步推至8万亿,加入新一轮超大参数模型竞赛。
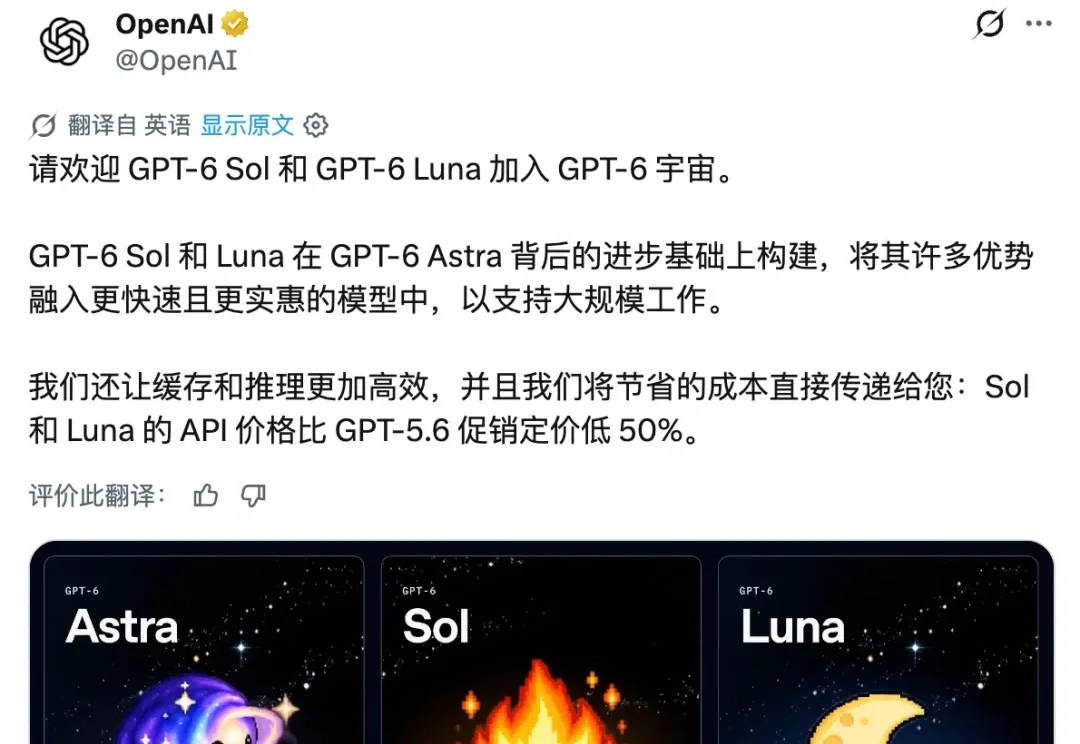
DeepSeek 快醒醒,ChatGPT 要打到家门口了。
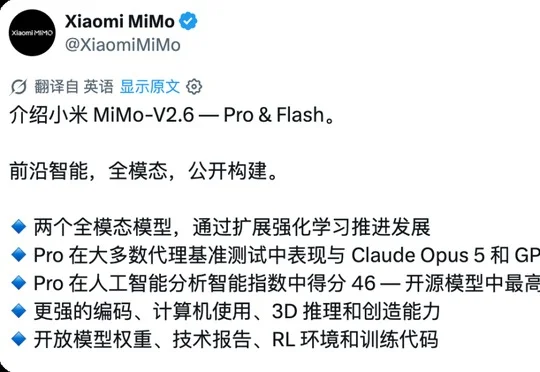
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
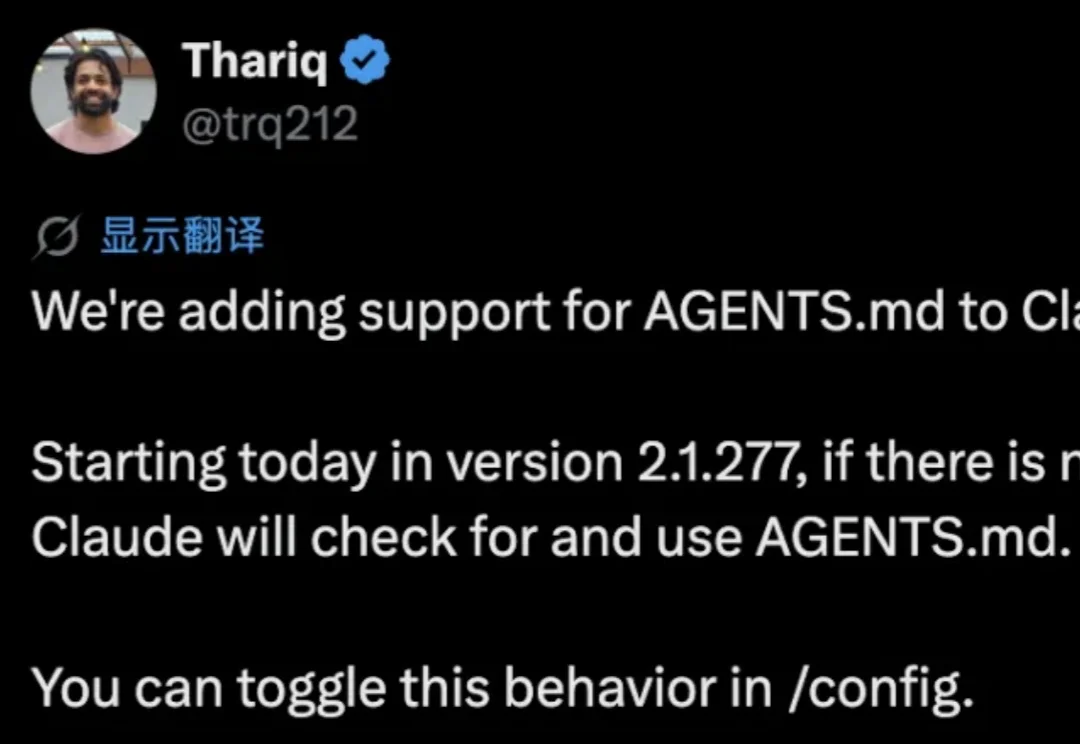
Claude向OpenAI格式投降了。
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
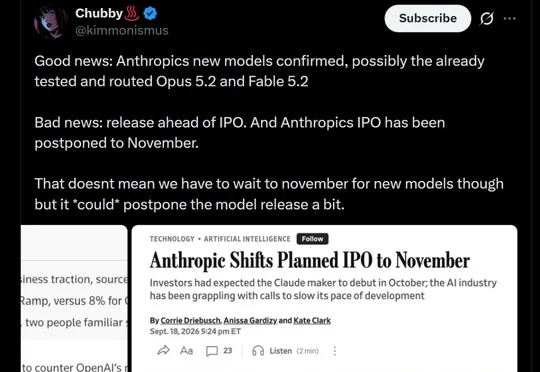
Anthropic、谷歌、OpenAI、Kimi、DeepSeek及阿里Qwen等全球AI大厂正密集备战,在中秋国庆假期前后集中推出或预告Claude 5.2、Gemini 4 Pro、Kimi K3.1、DeepSeek V4.1 Pro、Qwen4等旗舰基模,集体围攻OpenAI此前发布的GPT-6 Astra。
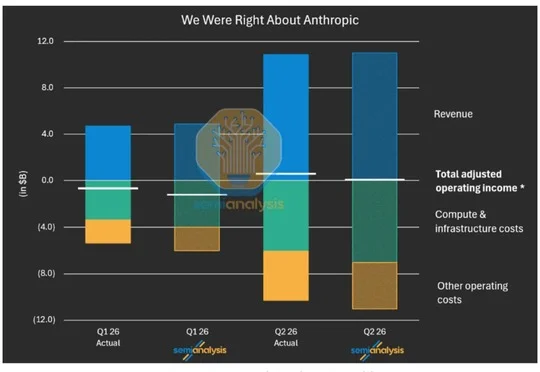
文章指出当办公Agent深度介入工作后,用户面临工作方式主导权被平台锁定的风险,认为模型开源不等于Agent开源,Agent Runtime开源才是关键,并以DeepSeek发布的Harness和网易有道开源的LobsterAI(含OpenClaw)为例,说明开源Agent Runtime能为用户带来数据主权、可审计性、连续性和可定制性。
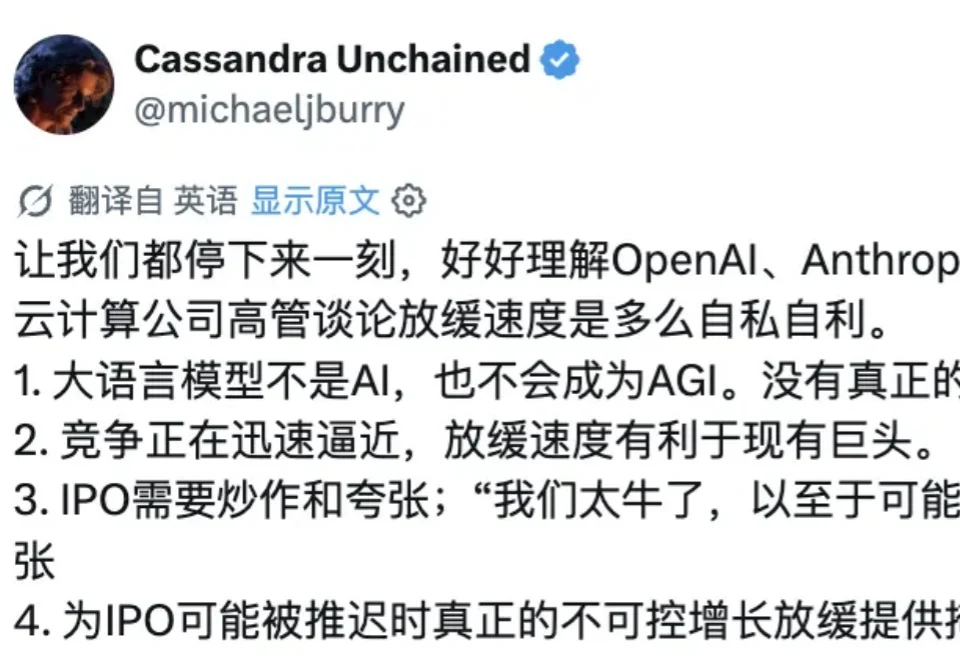
忍!不!了!了! 你老A社天天一会儿AI要失控、一会儿互联网要完蛋,转头自己IPO、融资、扩算力,一个都没耽误??
DeepSeek资深MLSys工程师刘胜与深夜发文,坦承刚完成V4.1核心算子交付后,意识到AI已能自主编写和优化GPU算子,正迫使他从手写底层算子转向驾驭AI Agent的"机甲驾驶员",并警示工程底层能力空心化可能带来系统性风险。
DeepSeek据悉将迎来高瓴创投90后合伙人严文韬出任CFO,同时已聘请中信证券筹备上海科创板IPO,并近期发布了DeepSeek V4.1 Flash模型,资本与产品双线加速推进。